Νικος Πετειναρακης
AVClub Fanatic
Πρόκειται περί ενζύμου που δρα με παρόμοιο τρόπο, αυτό κατάλαβα εγώ. Δεν είπα πως ανακάλυψε εκ νέου την αντίστροφη μεταγραφή.
Αγαπητοί φίλοι και φίλες,
Σας προσκαλούμε να γιορτάσουμε μαζί τα 20α γενέθλια του AVclub.
Το Σάββατο 10 Οκτωβρίου, από τις 18:00 θα πραγματοποιήσουμε το πάρτι των γενεθλίων του φόρουμ μας στο Peñarrubia Lounge.
Δηλώστε τη συμμετοχή σας εδώ, θα χαρούμε πολύ να σας δούμε από κοντά.

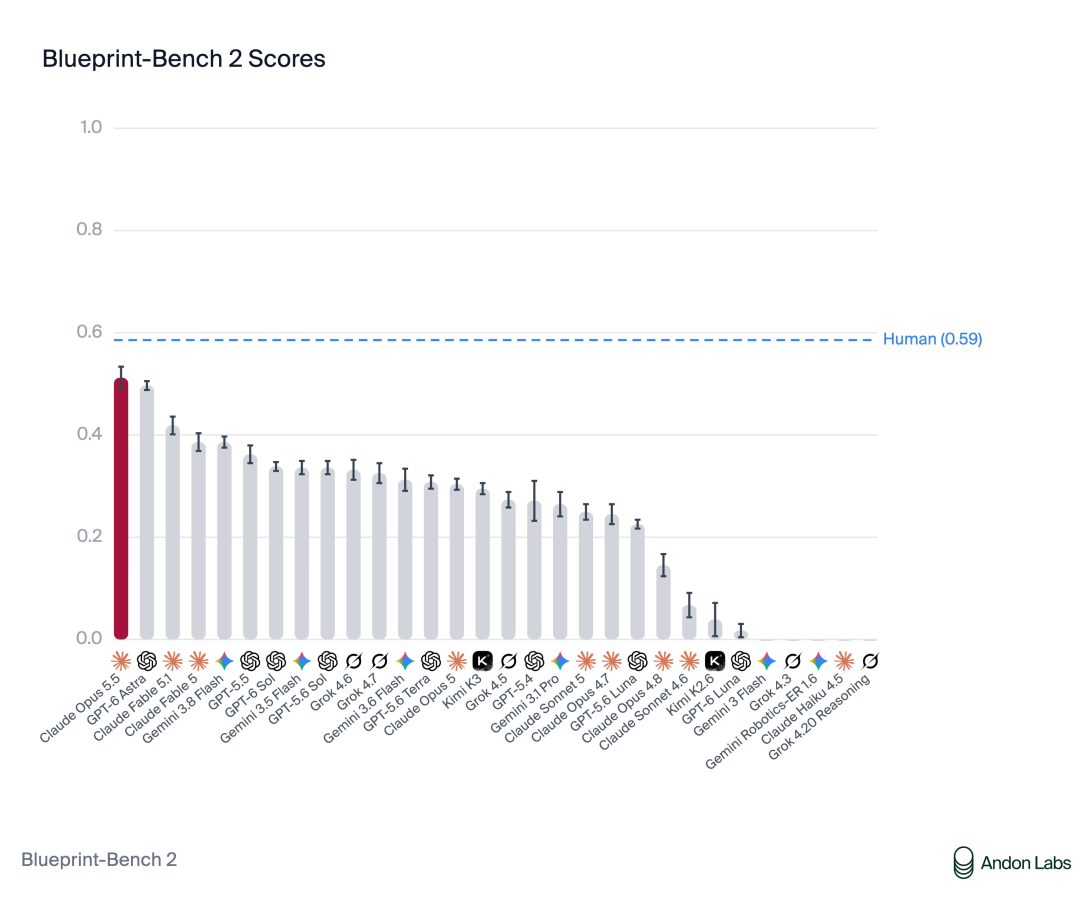

Δηλαδή το διαφορά θα δούμε αν φτάσουν σε αυτό το επίπεδο;Η Andon Labs δημοσίευσε τα αποτελέσματα της αξιολόγησης της ως προς την χωρική αντίληψη των μοντέλων στα 3 επίπεδα.
Το Astra όταν βγήκε ήταν όντως καινοτόμο στην αντίληψη του χώρου, το διαφήμισαν και πολύ με τις παρουσιάσεις στο blender -και καλώς. Πλέον το νέο Opus είναι το frontier και εδώ.
Βρίσκω εξαιρετικά ενδιαφέρον το ότι είμαστε πάρα πολύ κοντά στην ανθρώπινη αντίληψη.
Πολύ καλά τα πάνε και τα μοντέλα της Google αναλογικά. Το Gemini 3.8 Flash συγκρίνεται με το GPT 5.6 Terra.
View attachment 277968
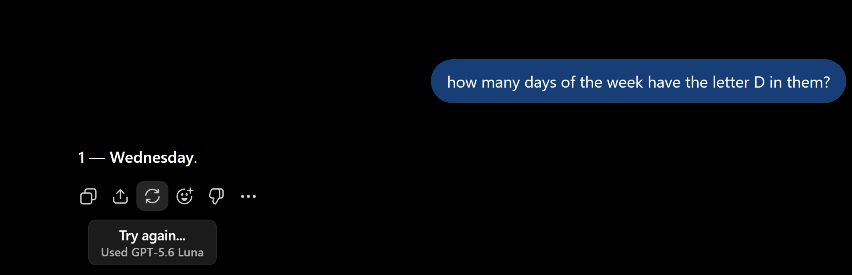
Δηλαδή τι διαφορά θα δούμε αν φτάσουν σε αυτό το επίπεδο;
Να πω την αλήθεια δεν περίμενα τέτοια βελτίωση στην χωρική αντίληψη γενικά μιας και αρκετοί ερευνητές συνέδεαν αυτή την κατηγορία δυνατοτήτων με τα world models που είναι ακόμη υπό ανάπτυξη.Ο μέσος άνθρωπος που ανοίγει το chatgpt και γράφει κάτι, έρχεται σε επαφή με τέτοιου επιπέδου "intelligence".
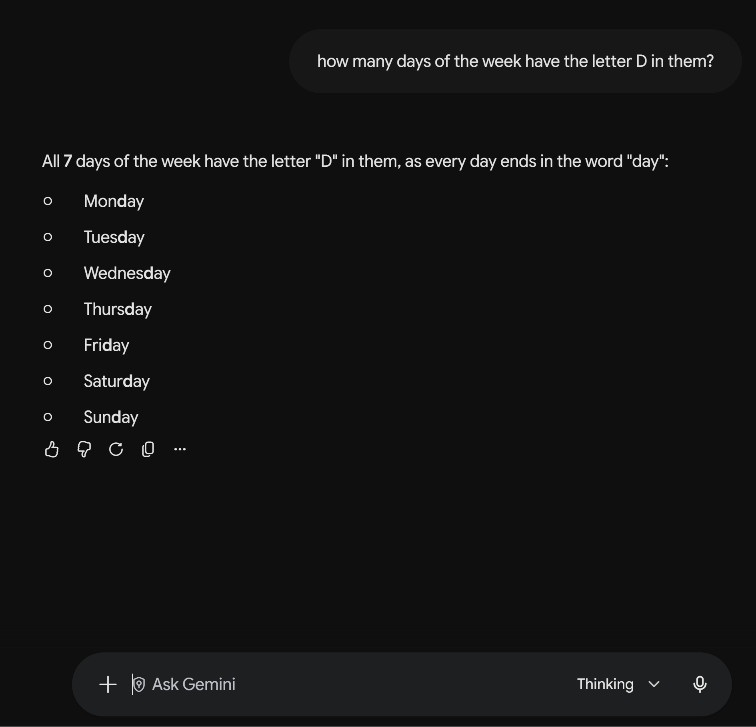
Εάν δεν έχετε συνδρομή στην OpenAI και πρόσβαση στα σοβαρά της μοντέλα, δεν αξίζει ούτε να το ανοίγετε. Τα Flash μοντέλα της Google που πρακτικά τα δίνει δωρεάν σε όλους είναι σαφέστατα καλύτερα.
Το Gemini 3.8 Flash:
Όσο βελτιώνεται η αντίληψη του χώρου τόσο πιο σωστά θα μπορούν να μοντελοποιούν χώρους με μεγαλύτερη ακρίβεια.
Ήδη είναι σε εξαιρετικό επίπεδο. Μπορείς να πάς από μια κάτοψη σε ένα πλήρες μοντέλο χώρου στο Blender. Πρίν από ένα χρόνο δεν γινόταν τίποτα από αυτά.
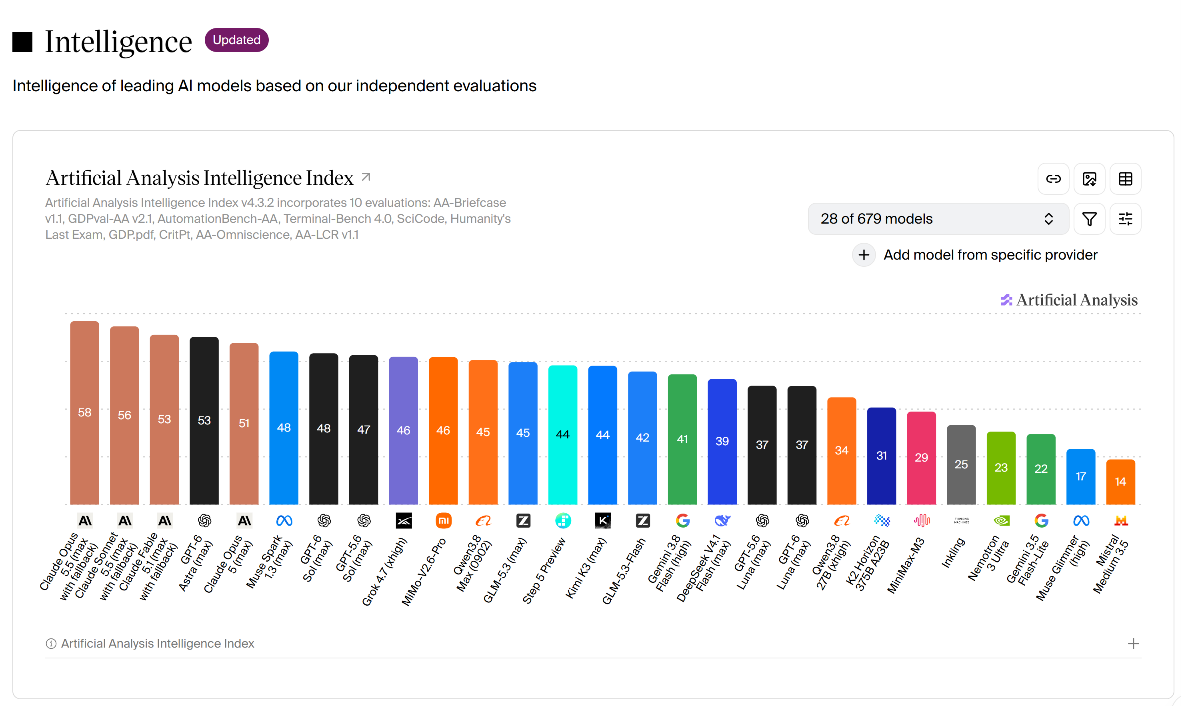
Artificial Analysis:
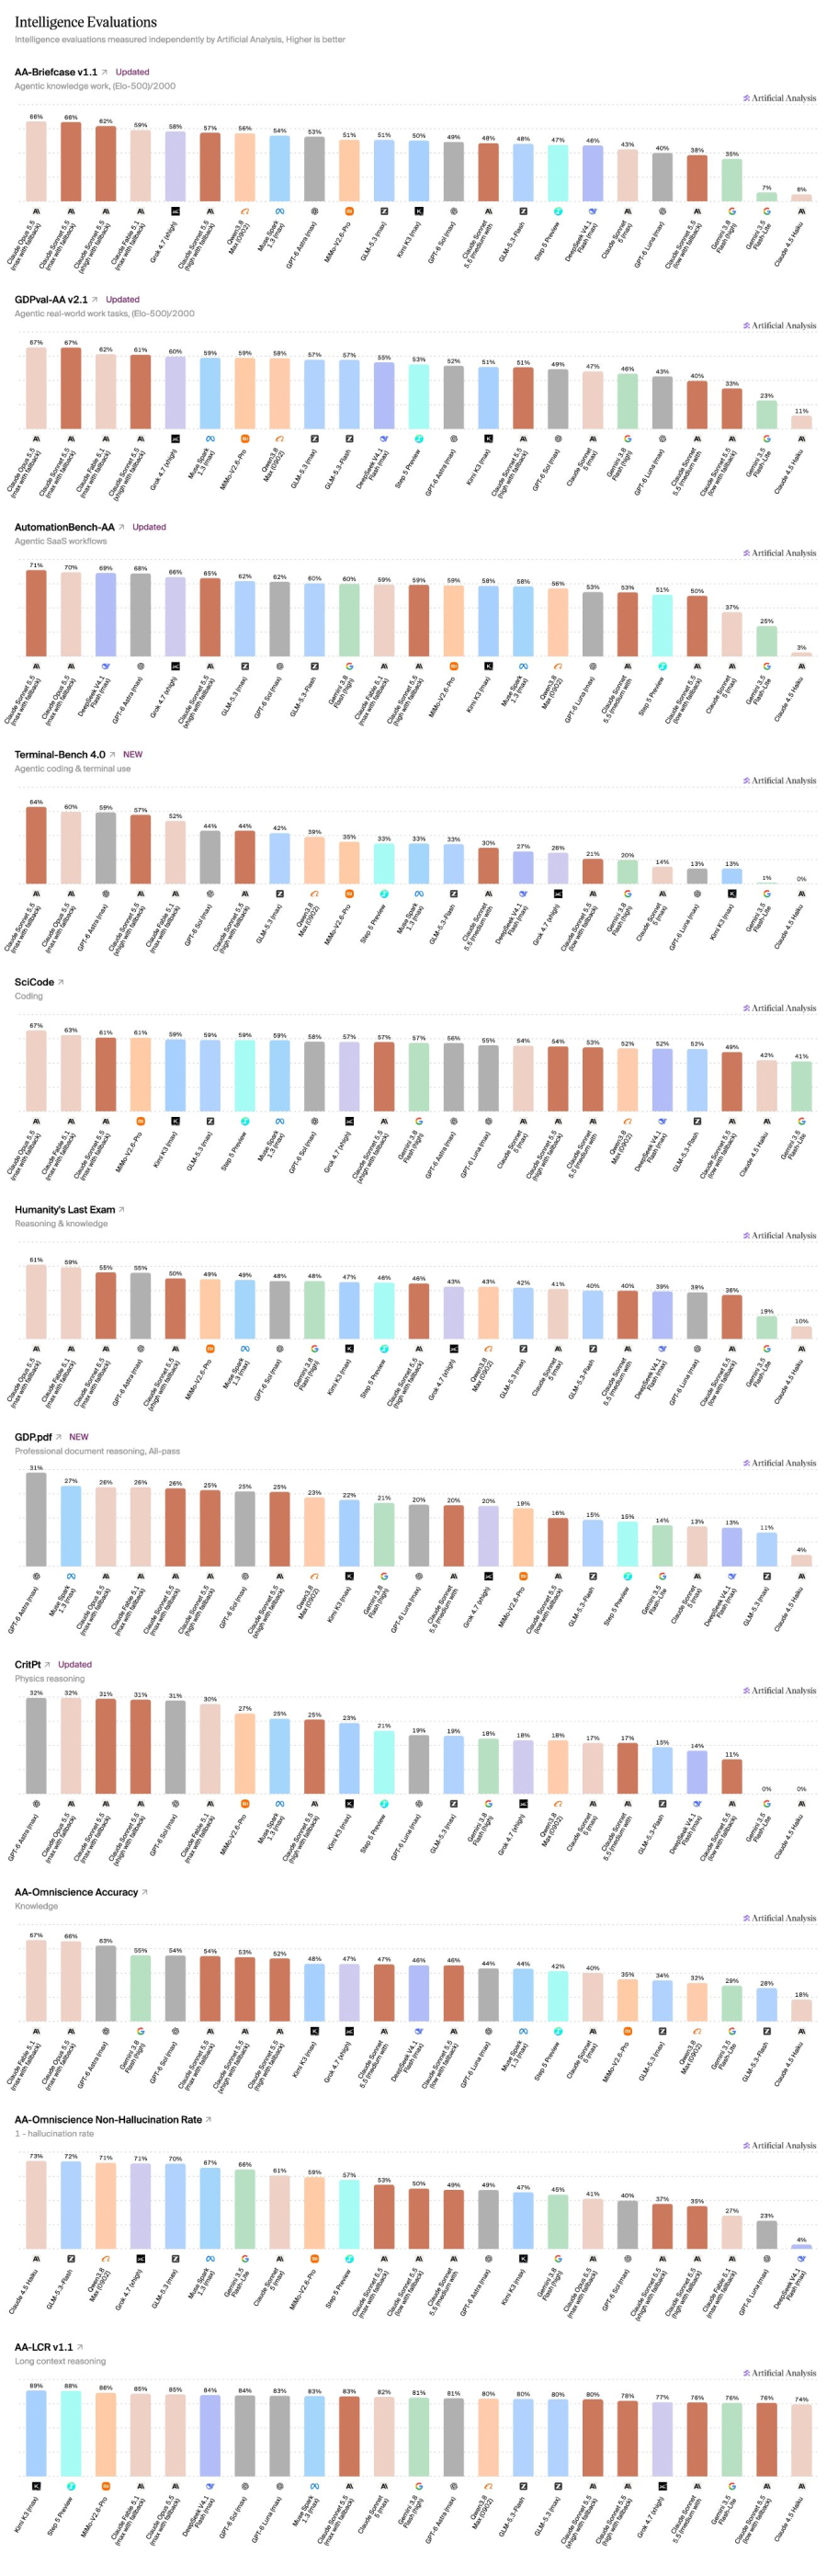
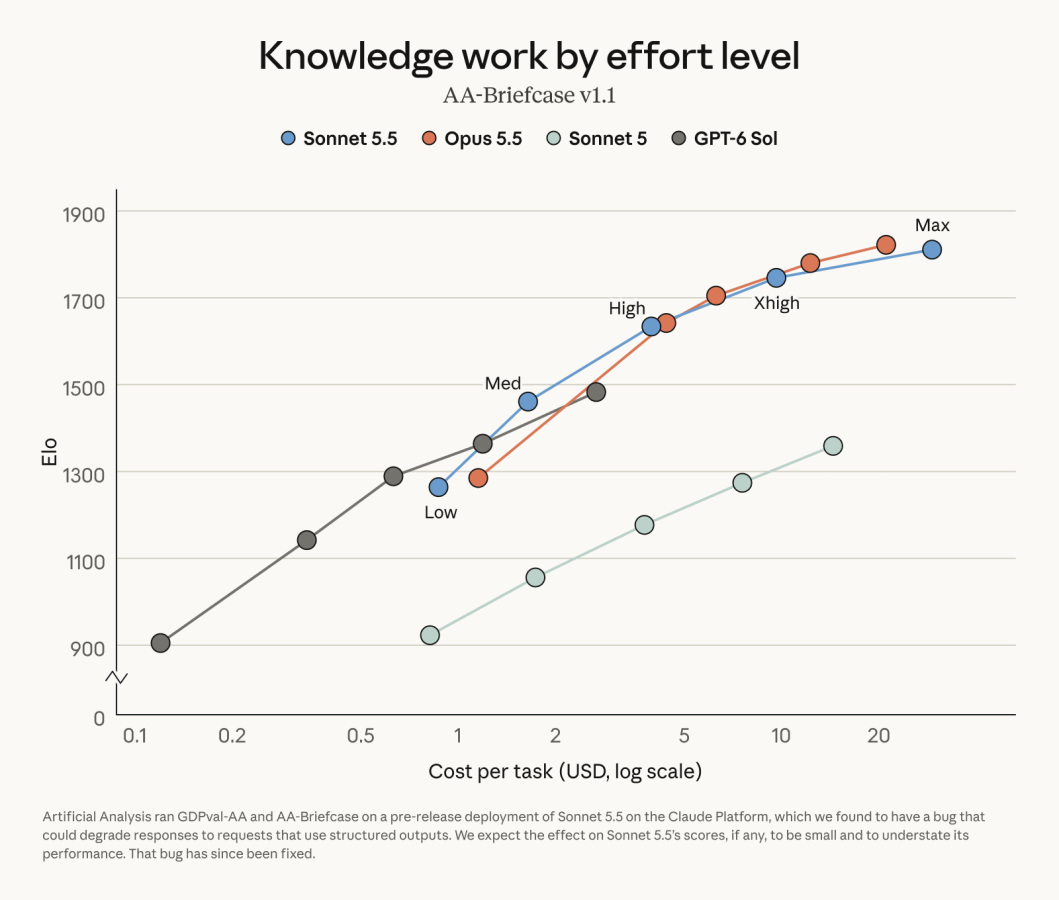
Anthropic has launched Claude Sonnet 5.5: it scores 56 on the Artificial Analysis Intelligence Index, just 2 points behind Opus 5.5 (max), but at the highest Output Tokens per Task we’ve seenWith max effort, Sonnet 5.5 gains 18 points over Sonnet 5 and to #2 on the Intelligence Index behind only Opus 5.5 (max). Anthropic has priced Sonnet 5.5 identically to Sonnet 5 at $0.2/$2/$10 per 1M cache input/input/output tokens, however it outputs a higher number of Output Tokens per Task and costs $7.60 per task (~50% higher than Sonnet 5’s Cost per Task)
Key takeaways:
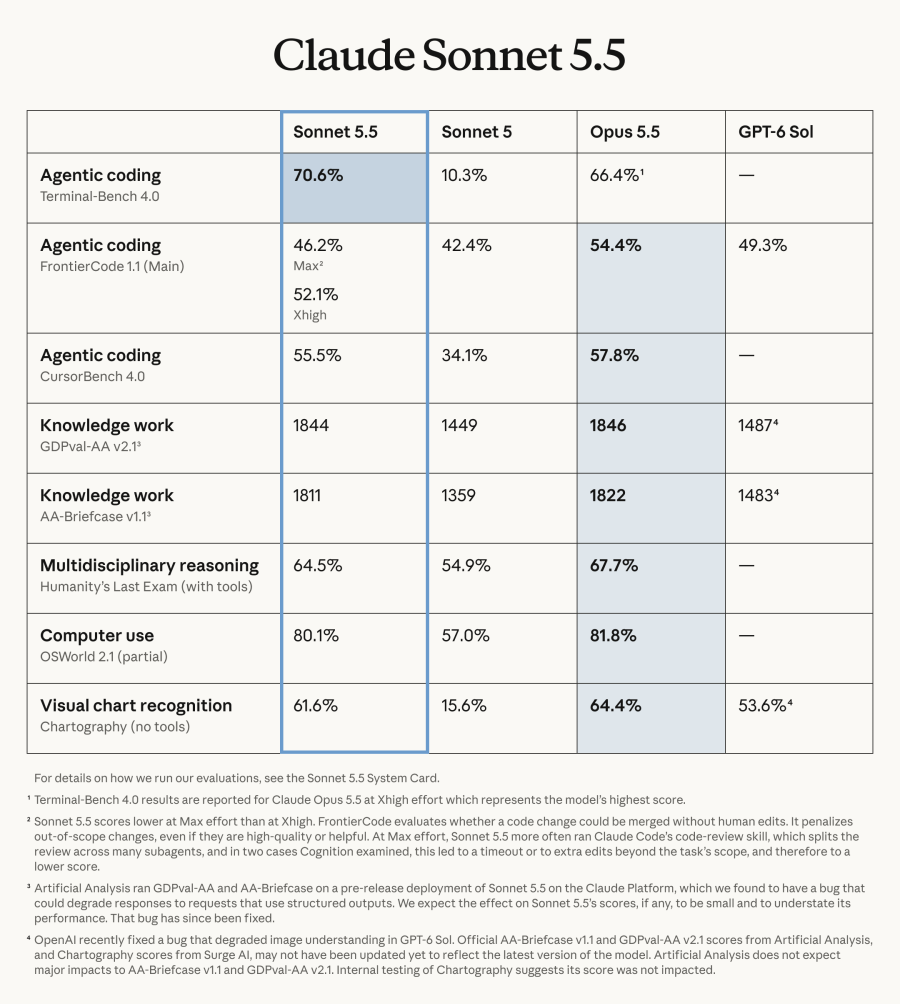
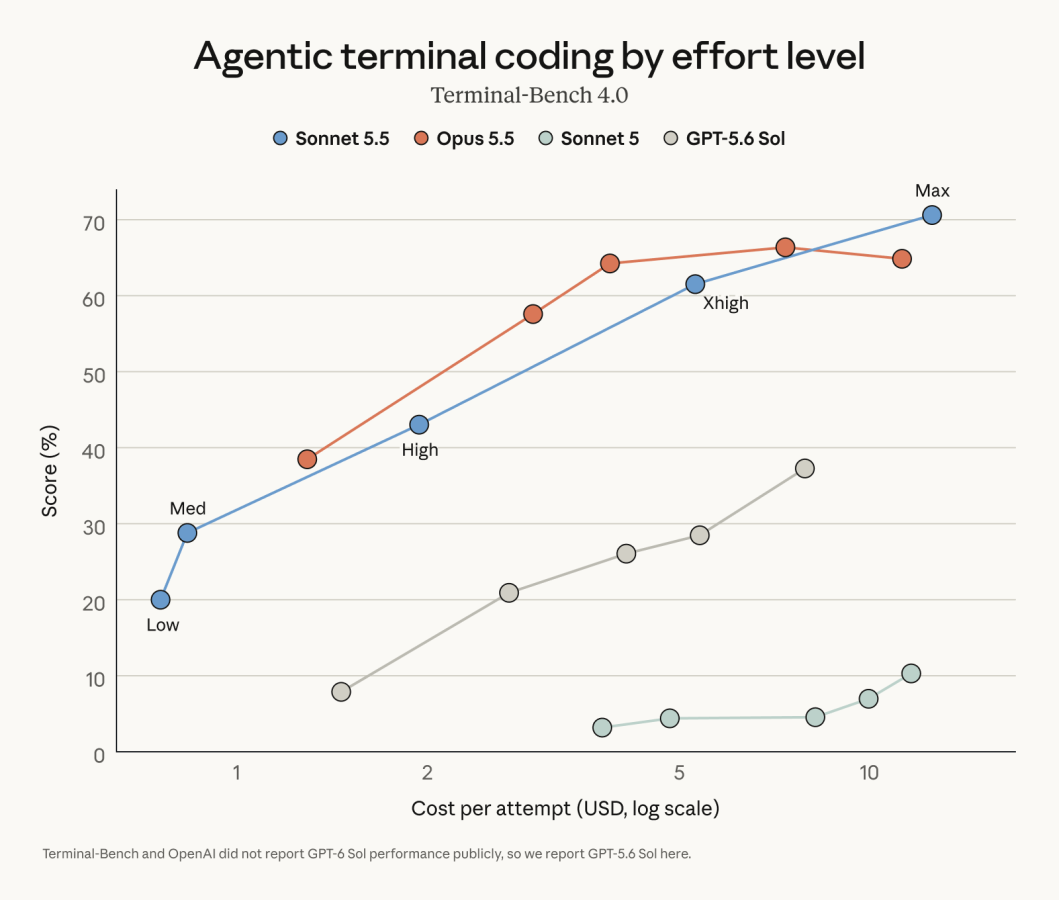
➤ Meets leading models on agentic terminal use and knowledge work: in Terminal-Bench 4.0, Claude Sonnet 5.5 reaches 64% against 60% for Opus 5.5 and GPT-6 Astra. On AA-Briefcase (1811 vs 1822 Elo), GDPval-AA (1844 vs 1846 Elo), and AutomationBench-AA (71% vs 70% headline score), Sonnet 5.5 reaches parity with Opus 5.5, albeit with significantly higher token usage to achieve it
➤ Heaviest token use we have measured: at max effort, where it reaches performance nearing that of Opus 5.5, Claude Sonnet 5.5 used ~193k Output Tokens per Intelligence Index Task. This is the highest token use we have measured on around 60% higher than Opus 5.5 (max) or Sonnet 5 (max) and ~7x GPT-6 Astra (max)
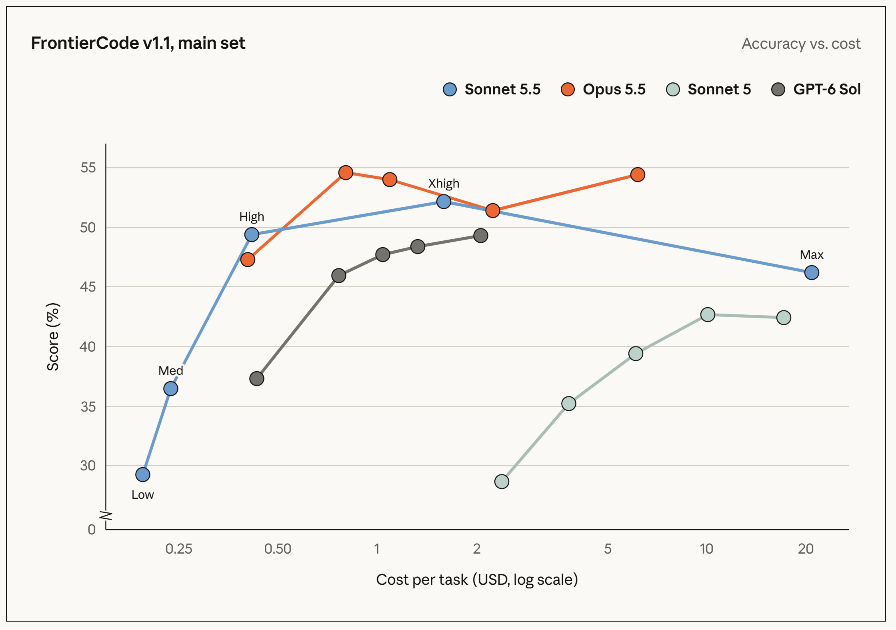
➤ Pricing remains at $2/$10 per million tokens of input/output, matching GPT-6 Sol. At this pricing Claude Sonnet 5.5 sits off the Intelligence vs. Cost per Task Pareto Frontier. At high effort levels it sits behind Opus 5.5, while lower efforts have GPT-6 Astra or Sol configurations delivering equivalent performance for lower cost. The high effort setting is the most competitive on this basis, sitting very narrowly behind GPT-6 Sol on Intelligence at effectively the same Cost per Task
➤ Behind Opus 5.5 on factual knowledge and scientific reasoning: as a smaller class model, Sonnet 5.5 still lags on factual knowledge in AA-Omniscience compared to Opus 5.5. It scores 54% against 66% for factual accuracy, though with a lower hallucination rate (47% against 59%). It also sits ~6 points lower on Humanity's Last Exam and SciCode compared to OpusThese evaluations were conducted on a pre-release deployment of Claude Sonnet 5.5, which Anthropic found to have a bug that can degrade responses to requests that use structured outputs. This is fixed for the public release and Anthropic expects minimal change or slightly understated performance, but we will be re-running relevant evaluations soon.Other model details:➤ Context window: 1 million tokens with image and text input, unchanged from Sonnet 5
➤ Pricing: unchanged from Sonnet 5’s latest $2/$10 per 1M input/output tokens; cache writes at $2.5, cache reads $0.2
➤ Effort settings: five (low, medium, high, xhigh, max). Intelligence Index evaluations were run at all five with Anthropic's default fallback enabled. We see Sonnet 5.5 fall back in ~0.1% of tasks across the Intelligence Index, primarily in TerminalBench 4.0, falling back to Sonnet 5 in all cases.
We use essential cookies to make this site work, and optional cookies to enhance your experience.