Τοπικά / Offline AI: Μοντέλα, Harnesses, Hardware, εγκατάσταση και εφαρμογές

  • Αγαπητοί φίλοι και φίλες,

    Σας προσκαλούμε να γιορτάσουμε μαζί τα 20α γενέθλια του AVclub.

    Το Σάββατο 10 Οκτωβρίου, από τις 18:00 θα πραγματοποιήσουμε το πάρτι των γενεθλίων του φόρουμ μας στο Peñarrubia Lounge.

    Δηλώστε τη συμμετοχή σας εδώ, θα χαρούμε πολύ να σας δούμε από κοντά.

17 June 2006
11,957
Με αφορμή την πρόταση του Δημήτρη στο γενικό νήμα για την Τεχνητή Νοημοσύνη, νομίζω ότι έχει νόημα να ανοίξουμε ένα ξεχωριστό νήμα αποκλειστικά για τα local / offline AI models.

Το βασικό νήμα έχει πλέον εξελιχθεί σε μια πολύ ευρύτερη συζήτηση γύρω από την AI: νέα frontier μοντέλα, δυνατότητες και benchmarks, agents, εξέλιξη των μεγάλων εργαστηρίων, αλλά και τις γενικότερες επιπτώσεις της AI στην εργασία, την κοινωνία και τον πολιτισμό.

Τα local μοντέλα όμως έχουν αρχίσει να αποτελούν από μόνα τους ένα αρκετά μεγάλο και κυρίως πολύ πιο πρακτικό αντικείμενο. Οπότε καλύτερα η σχετική κουβέντα να συγκεντρωθεί εδώ, αντί να χάνεται μέσα στο γενικό νήμα.

Με τον όρο local/offline AI εννοούμε μοντέλα που μπορούμε να τρέξουμε στο δικό μας PC, workstation ή server, χωρίς να χρειάζεται κάθε inference να γίνεται στους servers της OpenAI, της Anthropic, της Google κ.λπ. Το «offline» βέβαια δεν σημαίνει ότι όλες οι εφαρμογές πρέπει αναγκαστικά να είναι αποκομμένες από το Internet, αλλά ότι το βασικό είναι ότι το ίδιο το μοντέλο και τα δεδομένα μας μπορούν να παραμένουν τοπικά.

Εδώ μπορούμε να συζητάμε, μεταξύ άλλων:

  • ποια open/local μοντέλα αξίζουν για διαφορετικές χρήσεις,
  • dense και MoE αρχιτεκτονικές, quantization και διαφορετικά quants,
  • GGUF και άλλα formats,
  • CPU/GPU/NPU inference και απαιτήσεις σε RAM/VRAM,
  • ταχύτητα, context length, tokens/sec και κατανάλωση πόρων,
  • llama.cpp, Ollama, LM Studio και τα υπόλοιπα inference engines/front-ends,
  • πραγματικές συγκρίσεις και benchmarks - όχι μόνο τα επίσημα scores,
  • χρήση local μοντέλων με agents, coding harnesses, RAG, tools κ.λπ.,
  • privacy και επεξεργασία ευαίσθητων ή εμπιστευτικών δεδομένων τοπικά,
  • κόστος και πρακτική σύγκριση με cloud/API μοντέλα,
  • καθώς και hardware builds ειδικά για local AI.
Κυρίως θα είχε ενδιαφέρον να μοιραζόμαστε πραγματική εμπειρία χρήσης. Τα benchmarks είναι χρήσιμα, αλλά δεν λένε πάντα όλη την ιστορία. Ένα μοντέλο μπορεί να βρίσκεται ψηλά σε κάποιο leaderboard και στην πράξη να είναι υπερβολικά αργό, να παράγει τεράστια reasoning traces ή απλώς να μην είναι καλό για το συγκεκριμένο workload που μας ενδιαφέρει.

Το διαπίστωσα και εγώ τις τελευταίες ημέρες δοκιμάζοντας αρκετά διαφορετικά μοντέλα και quantizations. Οι διαφορές στην πραγματική χρήση είναι πολύ μεγαλύτερες από όσο θα περίμενε κανείς κοιτώντας μόνο τα benchmarks.

Οπότε ας μεταφέρουμε εδώ από δω και πέρα ό,τι αφορά local/offline models, inference και το hardware/software οικοσύστημα γύρω τους, κρατώντας το βασικό νήμα για την ευρύτερη συζήτηση περί AI.

Και φυσικά, όσοι ήδη τρέχετε κάτι τοπικά, γράψτε τι hardware έχετε, ποιο μοντέλο χρησιμοποιείτε και για ποια χρήση. Νομίζω ότι έτσι θα φτιάξουμε σχετικά γρήγορα μια αρκετά χρήσιμη εικόνα του τι πραγματικά δουλεύει και σε τι μηχανήματα.
 
Θα μοιραστώ πως ξεκίνησα να ψάχνομαι για local AI.

Αρχές 2026 (ούτε ένα χρόνο πριν!!!) έγινε ο χαμός με το clawdbot / moltbot / openclaw. Ο πρώτος personal agent. Να είναι καλά το ChatGPT και ξεκίνησα να προγραμματίζω την πρώτη μου ψηφιακή γραμματέα. Τότε είχα ακόμη τη συνδρομή των 20 δολαρίων στην OpenAI και δεν ήθελα να συνδέσω το Openclaw με τη συνδρομή μου. Από την άλλη ο βασικός μου υπολογιστής ήταν σχεδόν 7 ετών. Όμως για καλή μου τύχη είχε μια RTX 2060 με 6 GB VRAM. Οπότε μετά από δοκιμές αρκετών μοντέλων κατέληξα στο qwen3-4b-instruct-2507. Το οποίο πιστεύω ακόμη ότι είναι μάλλον το καλύτερο 4Β μοντέλο που δεν χρειάζεται να σκέφτεται.
Τι ήθελα από την εφαρμογή; Να μου κρατά ένα todo list και να μπορώ να αποθηκεύω και σημειώσεις. Τα κατάφερα; Όχι και ο λόγος ήταν ότι όσο αναλυτικά skills και να έγραφα το LLM τα έκανε μαντάρα με τις βάσεις δεδομένων κλπ. Χρειαζόταν απλά ένα πιο έξυπνο μοντέλο. Έτσι σταμάτησα να ασχολούμαι με το OpenClaw (αν και η ενασχόληση μου φάνηκε απίστευτα χρήσιμη σαν εκπαιδευτική διαδικασία).

Περίπου την ίδια εποχή είχα ξεκινήσει να ασχολούμαι με το CODEX. Όλοι το παρουσίαζαν σαν εργαλείο προγραμματισμού. Εγώ προγραμματίζω ελάχιστα. Αλλά έβλεπα στο internet εφαρμογές που έβλεπαν το codex σαν πλατφόρμα για ανάπτυξη πολυπρακτορικών συστημάτων (να πω ότι είχα θεωρητικά υπόβαθρο στα πολυπρακτορικά συστήματα γιατί ήταν μέρος της διδακτορικής μου διατριβής πολύ πριν τα LLM). Για να το μάθω είχα φτιάξει 2 τοπικά λογισμικά που χρειαζόμουν. Το πρώτο ήταν συγχρονισμός ημερολογίων μεταξύ MS Outlook και Google Calendar. Το δεύτερο ήταν ένα advanced self-learning φίλτρο για τα email που δεχόμουν σε ένα πανεπιστημιακό email που έχω από το 2000 και λαμβάνω καθημερινά πάνω από 30-50 μηνύματα και μόνο 1-2 είναι σημαντικά. Να πω ότι αυτά ήταν deterministic λογισμικά, δεν είχαν καθόλου ΑΙ. Όμως ένιωσα έτοιμος να δοκιμάσω να αναπτύξω την πρώτη εφαρμογή με ΑΙ.

Έτσι η γραμματέας που απέτυχε στο openclaw μετενσαρκώθηκε σε ανεξάρτητη εφαρμογή. Όλο σχεδιάστηκε ντιτερμινιστικά, αλλά έβαλα ένα LLM μπροστά για να μπορώ να μιλάω με φυσική γλώσσα. Μετά από λίγες μικροβελτιώσεις τις πρώτες ημέρες το todo list δούλεψε τέλεια. Χρησιμοποιούσα το qwen3-4b-instruct-2507 μέσω του LM Studio για να γράφω με κανονική γλώσσα. Μετά προσέθεσα notes και voice. Επίσης έστησα χρήση μέσω του κινητού μου μέσω Tailscale. Έστησα και ένα Raspberry Pi να μου ξυπνάει τον υπολογιστή μέσω καλωδίου δικτύου - επικοινωνούσα μέσω Telegram με το Raspberry.
Μετά προσέθεσα και άλλα 2 χαρακτηριστικά. Ένα πρωινό briefing, τι έχω να κάνω μέσα στη μέρα και ένα εβδομαδιαίο παρασκευή απόγευμα για την επόμενη εβδομάδα.
Κάπου εκεί σταμάτησε η ανάπτυξη. Και το λογισμικό το χρησιμοποιώ συνεχώς από τότε, χωρίς να χρειαστεί κάποια αναβάθμιση.

Εκεί η πρώτη σκέψη ήταν να πάρω ένα Jetson Orin Nano και να στήσω το βοηθό εκεί πάνω. Αυτό θα ήταν ένα ωραίο project αλλά θα κόστιζε 400+ ευρώ και η εξτρά λειτουργικότητα από αυτό που θα είχα ήταν μικρή. Ήθελα επίσης να παίξω με μεγαλύτερα μοντέλα. Η επόμενη ιδέα ήταν να πάρω ένα NVIDIA Jetson Orin 16GB για να μπορώ να τρέχω μεγαλύτερα μοντέλα. Αλλά εδώ ήθελα κοντά στα 1000 ευρώ. Και από πείραμα γινόταν κάτι ακριβό. Να πω ότι στον υπολογιστή μου είχα ξεκινήσει να τρέχω Mixture of Experts μοντέλα σχετικά καλά μιας και ενώ τα 6 GB ήταν λίγα στην κάρτα γραφικών, είχα αναβαθμιστεί στα 64 GB ram. Αυτό το μόνο που κατάφερε ήταν να μου ανοίξει την όρεξη και όχι να με κάνει να χαρώ με ότι είχα.

Επίσης, παράλληλα, έβλεπα το πως άλλαζε συνταρακτικά ο τρόπος εργασίας στο επάγγελμά μου λόγω του ΑΙ. Από την άλλη είχα συμβόλαια με confidentiality clauses που περιόριζαν ή και σε κάποιες περιπτώσεις πρακτικά απαγόρευαν την χρήση ΑΙ. Ήδη είχα Business συνδρομή στο Copilot, το οποίο χρησιμοποιεί τον private tenant του Onedrive για τα αρχεία σου - κάτι που είναι GDPR compliant. Έτσι σε κάποιες περιπτώσεις μπορούσα να χρησιμοποιήσω αυτό, αλλά στα υπόλοιπα έργα πρακτικά δεν μπορούσα να χρησιμοποιήσω τίποτα. Η μόνη μη νομικά μπλεγμένη λύση ήταν να τρέχω ένα offline μοντέλο χωρίς σύνδεση στο Internet. Αυτό το σενάριο ήταν που στην ουσία έκανε την επένδυση σε hardware για τρέξιμο local LLM από μια χομπύστικη αναζήτηση σε ένα εργαλείο για τη δουλειά, που διευκόλυνε πολύ το να επενδύσω πια χρήματα σε αυτό.

Έτσι ξεκίνησε μια διπλή αναζήτηση. Σε πρώτο επίπεδο καταγραφή των επαγγελματικών workflows και πως θα μπορούσαν αυτά να υποστηριχθούν από πλευράς λογισμικού. Σε δεύτερο επίπεδο φυσικά hardware που να μπορούσε να τα υποστηρίξει.

Για το hardware, η πρώτη επιλογή ήταν το Nvidia DGX Spark. Προφανώς ακριβό, αλλά πολύ καλό σε αυτό που προσφέρει. Όμως είχε μια μεγάλη αβεβαιότητα. Αν τελικά ΔΕΝ χρησιμοποιούσα το ΑΙ για οποιοδήποτε λόγο ή αν το υποχρησιμοποιούσα τα ~5000 ευρώ θα πήγαιναν πρακτικά κουβά...Έτσι κοίταξα σε άλλες πλατφόρμες. Η πρώτη λύση ήταν να πάρω κάποια κάρτα γραφικών της nvidia και να τη συνδέσω με το υπάρχον laptop. Αν και 7 ετών είχε thunderbolt θύρα, όμως χαμηλής -σχετικά- ταχύτητας. Και σε αυτό το σενάριο αν δεν χρησιμοποιούσα το ΑΙ θα πήγαινε κουβά η επένδυση γιατί πια παιχνίδια δεν παίζω. Επίσης για να πάρεις κάρτες με 32 GB vram το κόστος ανεβαίνει τρελά. Τα 64 GB ήταν απλά φαντασία και το κόστος εφάμιλλο τελικά με το DGX Spark. Τελικά η λύση που μου φάνηκε πιο ελκυστική ήταν η πλατφόρμα της AMD η Ryzen Al MAX+ 395 με 128GB unified memory. Ήξερα ότι θα ήταν πιο αργό από κάρτες γραφικών της nvidia, αλλά θα μπορούσα να τρέξω μοντέλα 96-100 GB και επίσης φαινόταν πόσο ανώριμη ήταν η υποστήριξη σε λογισμικό για αυτή την πλατφόρμα που άφηνε ανοικτή την πόρτα σε βελτίωση απόδοσης απλά μέσω λογισμικού. Επίσης είχε ένα άλλο πολύ θετικό. Μπορούσε να τρέξει windows 11, οπότε αν τελικά δεν χρησιμοποιούσα τα ΑΙ χαρακτηριστικά πολύ, θα είχα ένα καινούργιο πολύ ικανό υπολογιστή. Αφού αποφάσισα την πλατφόρμα μετά είχα την επιλογή miniPC vs Laptop. Τελικά κατέληξα στη δεύτερη γιατί 3 φορές το χρόνο πάω τον υπολογιστή στο εξοχικό από όπου δουλεύω από 2 εβδομάδες για τα δύο ταξίδια και πάνω από μήνα το καλοκαίρι. Βρήκα μάλιστα ένα Laptop με 2 TB SSD στις 13 ίντσες, οπότε θα μπορούσα να αντικαταστήσω και το βασικό μου Laptop (που πήγαινε μόνο στο εξοχικό) και το laptop για τα ταξίδια (MS Surface Pro 7). Και στα δύο γραφεία έχω οθόνες/πληκτρολόγιο/ποντίκι, οπότε το Laptop μπαίνει σε μια βάση και δεν χρησιμοποιώ την οθόνη του.

Θεωρώ ότι αν κάποιος θέλει να παίξει με offline LLMs χωρίς να έχει συγκεκριμένη εφαρμογή στο μυαλό του η AMD Ryzen Al MAX+ 395 με 128GB unified memory είναι η πιο cost effective πλατφόρμα να επενδύσει. Ήδη υπάρχει λογισμικό να συνδέσεις 2/4/6 τέτοια μηχανήματα για να τρέξεις μεγαλύτερα μοντέλα. Και επίσης δεν είναι ανάγκη να είναι ακριβώς τα ίδια τα μηχανήματα, έτσι μπορεί να αναμείξεις διαφορετικών κατασκευαστών και διαφορετικών τύπων (minipc/laptops/etc). Να σημειώσω ότι άμεσος ανταγωνιστής είναι τα miniPC της Apple. Αλλά χωρίς να προσφέρουν κάτι ουσιαστικά καλύτερο για την παραπάνω χρήση, η τιμή τους είναι σημαντικά υψηλότερη και η διαθεσιμότητά τους πολύ χαμηλή για αυτά με 128GB unified ram. Και τέλος να πω ότι οι μνήμες σε όλες αυτές τις πλατφόρμες είναι soldered στη μητρική, οπότε δεν υπάρχει περιθώριο μελλοντικής αναβάθμισης. Ότι πάρεις παραμένει έτσι για πάντα.

Για το λογισμικό σε άλλο μήνυμα.
 
Last edited:
  • Like
Reactions: athlon6401
Δεν είναι πολύ πιο αργό με απλή DDR5 ram; Νόμιζα πως παίζει σημαντικό ρόλο το latency της μνήμης
 
Δεν είναι πολύ πιο αργό με απλή DDR5 ram; Νόμιζα πως παίζει σημαντικό ρόλο το latency της μνήμης
Όλα παίζουν ρόλο. Έχεις βασικά 3 δρόμους:
1. Αγοράζεις κορυφαίες κάρτες της nvidia μέχρι να φτάσεις στο επίπεδο εκείνο που θα τρέχει το μοντέλο που θέλεις. Η μνήμη φυσικά θα είναι πολύ γρήγορη.
2. Αγοράζεις κάποια πλατφόρμα με unified μνήμη - ναι η μνήμη θα είναι LPDDR5.
3. Αποφασίζεις ότι θα τρέχεις μόνο Mixture of Experts μοντέλα και πας να πάρεις μια κορυφαία κάρτα γραφικών που σε συνδυασμό με αρκετή μνήμη του συστήματος κατά προτίμηση DDR5 και μοιράζεις το μοντέλο μεταξύ μνήμης κάρτας γραφικών και μνήμης συστήματος.

Θα σου δώσω τα δικά μου benchmarks που έτρεξα στο δικό μου σύστημα. Να πω ότι δεν έχω κάνει κάποια τρελή βελτιστοποίηση ακόμη, σκέψου ότι όλα τα αποτελέσματα είναι με Vulkan llama.cpp . Ίσως με ROCm llama.cpp να είναι λίγο πιο γρήγορα τα πράγματα. Επίσης δεν έπαιξα πολύ με MTP που μπορεί να δώσει βελτίωση. Στα dense models θεωρητικά έχω να κερδίσω tok/s με βελτιστοποίηση βλέποντας τις τιμές που έχουν ποστάρει άλλοι με ακριβώς το ίδιο hardware.

qwen3.5-122b-a10b-mtp: Tokens/Second: 7.38
qwen3.6-35b-a3b-mtp: Tokens/Second: 37.24
qwen3.8-flash-next@iq4_xs: Tokens/Second: 17.21
qwen3.8-27b: Tokens/Second: 12.75
gpt-oss-120b: Tokens/Second: 33.04
Gemma-4-26b-a4b-qat: 41.66 tok/s
Gemma-4-31b-qat: 8.58 tok/s

Όπως είναι ξεκάθαρο, τα dense μοντέλα δεν τα πάνε καλά στο συνδυασμό LM Studio και υπολογιστή μου. Σίγουρα κάτι δεν κάνω σωστά, γιατί θα έπρεπε να παίρνω κοντά στα 25 tok/s για το qwen3.8-27b και παίρνω τα μισά. Για το Gemma-4-26b-a4b-qat πάλι θα έπρεπε να παίρνω κοντά στα 50. Πιο κάτω, αλλά όχι κάτι τραγικό. Βέβαια αν χρησιμοποιούσα MTP θα μπορούσα να ανέβω με αναφορές από το internet ακόμη και στα 80 tok/s. Με απλά λόγια γενικά χρειάζομαι πείραγμα για να βγάλω καλύτερη απόδοση από τα μοντέλα. Η βελτίωση θεωρητικά αναμένεται μεγαλύτερη στα dense, αλλά υπάρχει ρεαλιστικά και για τα Mixture of Experts.

Έχω κάνει μόλις 2 τεστ ως τώρα με τα παραπάνω μοντέλα. Ένα με ένα απλό Prompt μιας πρότασης για να αναπτύξει κείμενο από το χώρο μου και το δεύτερο με ένα τρομερά αναλυτικά prompt για το ίδιο πράγμα.
Τα qwen και ειδικά το 3.6 έκανε κύκλους και δεν τελείωνε ποτέ. Γενικά ανέμενα κάτι αντίστοιχο, αλλά σε καμία περίπτωση σε αυτό το βαθμό από ότι είχα διαβάσει. Ο στόχος ήταν πάντα να έχω ένα καθημερινό μοντέλο και ένα πιο εξελιγμένο για να κάνει ελέγχους ή brainstorming. Ήταν ξεκάθαρο ότι το qwen3.8-flash-next@iq4_xs έπαιζε σε άλλο επίπεδο, οπότε αυτό ήταν και το "καλό" μοντέλο.
Για καθημερινό κατέληξα στο Gemma-4-26b-a4b-qat το οποίο στην τελική είχε ελάχιστες διαφορές από τα υπόλοιπα σε ποιότητα (κάπου καλύτερο, κάπου χειρότερο), αλλά είναι πολύ γρήγορο ήδη.

Τα παραπάνω μου πήραν 6-8 ώρες όχι αυτοματοποιημένα, αλλά παραδοσιακά με δοκιμές.

Σταμάτησα και συνέχισα με το harness. Σήμερα μετά από αρκετές μέρες με το codex να τρέχει αρκετά έχω την πρώτη λειτουργική έκδοση. Όταν βρω χρόνο θα τρέξω τα 2 prompt που είχα τρέξει στα αρχικά πειράματα ώστε να δω τι βελτίωση έχω λόγω της ύπαρξης harness...αυτό ελπίζω να είναι σημαντικό. Αν όχι, θα είναι μεγάλη απογοήτευση.

Σε κάθε περίπτωση ο αρχικός σχεδιασμός ήταν τρομερά αισιόδοξος έτσι και αλλιώς, αλλά ήθελα να δω τι θα μπορούσα να κάνω.

Το βασικότερο που δεν τρέχει ακόμη (και δεν ξέρω καν αν θα μπορέσω να το στήσω) είναι να μπορεί το μοντέλο στη διάρκεια του μηνύματος να καλεί και να χρησιμοποιεί εργαλεία για μαθηματικές πράξεις αυτόματα. Μπορείς φυσικά να του πεις να φτιάξει excel για τους υπολογισμούς και να το μοιραστεί στο τέλος. Αυτό θεωρητικά υπάρχει.
Επίσης ο πλήρως αυτοματοποιημένος έλεγχος για hallucinations/factuality δεν έχω καταφέρει να δουλέψει. Αυτό που έχω υλοποιήσει είναι αυτό που κάνουμε χειροκίνητα. Να μπαίνει η απάντηση σε νέο chat χωρίς μνήμη και να τσεκάρει ανεξάρτητα hallucinations/factuality. Αρκεί προφανώς και αυτό.

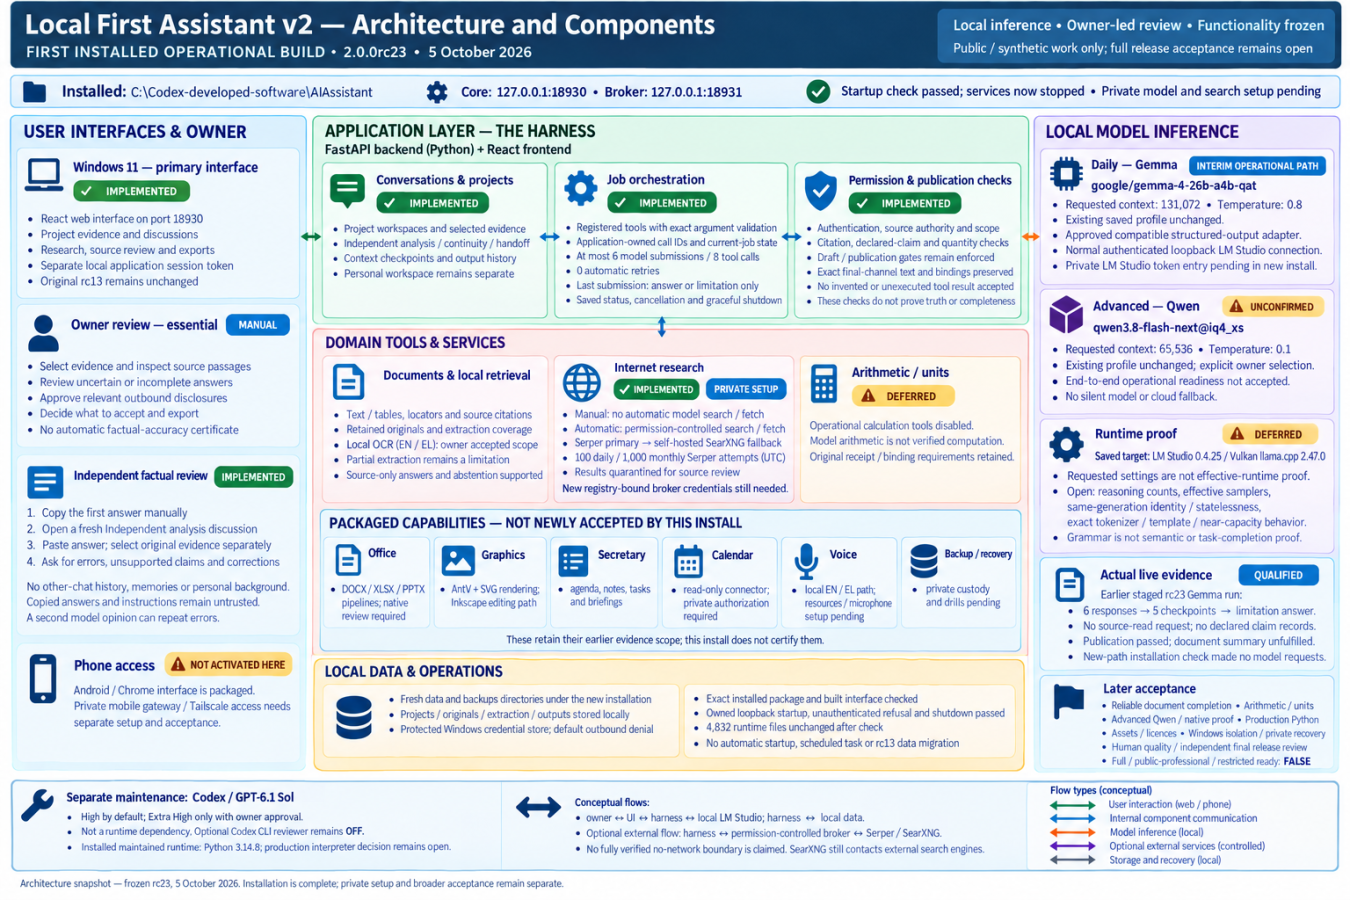
Να πω ότι ότι βλέπετε πιο κάτω είναι αποτέλεσμα:
- Τουλάχιστον 5 συζητήσεων των 1-2 ωρών με Pro μοντέλα από τον Μάιο και μετά μέχρι αρχές Αυγούστου με τα οποία έκανα ανάλυση των workflows της δουλειάς και τι ιδεατά τι θα μπορούσα να βοηθήσω με το ΑΙ. Ως εδώ δεν είχε γραφτεί ούτε μια γραμμή κώδικα.
- Λίγο μετά αποφάσισα να προχωρήσω με το επιλεγμένο hardware, οπότε το όλο concept έγινε σχεδιασμός υλοποίησης. Ακόμη στο chat με Pro μοντέλο.
- Αφού ολοκληρώθηκε ο σχεδιασμός, το Pro πάλι έγραψε όλη την πρώτη έκδοση του κώδικα.
- Στον καινούργιο υπολογιστή, αφού έστησα μόνος LM Studio και έκανα δοκιμές, έστησα το CODEX το οποίο θα αναλάμβανε την υλοποίηση και συντήρηση στον υπολογιστή αυτό.
- Πήρε 2-3 μέρες να φτιάξει όλα τα πακέτα για να είναι συμβατά μεταξύ τους και να τρέχουν όλα τα workflows.
- Κάποια πράγματα που δεν το έβλεπα να μπορεί να τα λύσει, τα έβαλα σε to-do list για αργότερα.

Τώρα βρίσκομαι στο παρακάτω και έχει έρθει η ώρα να ξεκινήσω να το χρησιμοποιώ.


1791196165870.png