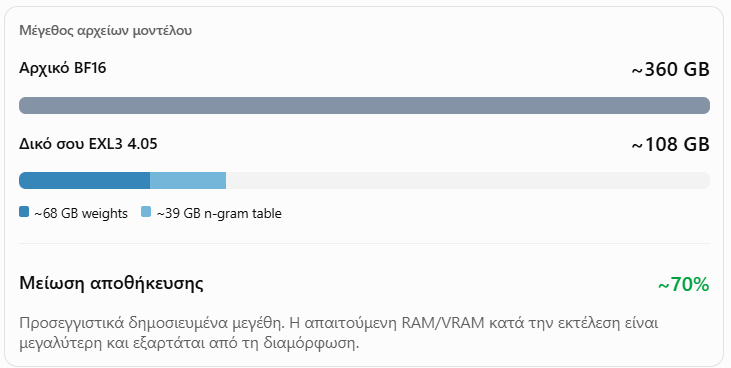
Ήθελα από την αρχή να γράψω κάποια post που εξηγούν συγκεκριμένες τεχνικές/ όρους που χρησιμοποιούμε. Το παρακάτω είναι ένα από αυτά. Το έγραψε LLM αλλά το επιμελήθηκα μετά.
Πώς λειτουργούν τα LLMs: από την εκπαίδευση και το quantization μέχρι το MTP και τα n-gram tables
Για να κατανοήσουμε τις τεχνολογίες αυτές, πρέπει να διαχωρίσουμε τέσσερα διαφορετικά ζητήματα:
- Τι γνωρίζει και τι μπορεί να κάνει ένα μοντέλο: καθορίζεται κυρίως από την αρχιτεκτονική και την εκπαίδευσή του.
- Πόσο χώρο καταλαμβάνει: εξαρτάται από τον αριθμό των παραμέτρων και την ακρίβεια με την οποία αποθηκεύονται.
- Πόση μνήμη χρειάζεται και πόσο γρήγορα εκτελείται: εξαρτάται από τη μορφή του μοντέλου, το hardware, το μήκος του κειμένου και τον μηχανισμό εκτέλεσης.
- Πόσο γρήγορα παράγει την απάντηση: μπορεί να βελτιωθεί με τεχνικές όπως το Multi-Token Prediction (MTP) και τα n-gram tables, χωρίς απαραίτητα να αλλάξει η ποιότητα του μοντέλου.
Αυτές οι τέσσερις διαστάσεις συνδέονται, αλλά δεν ταυτίζονται. Ένα μοντέλο μπορεί να είναι μικρότερο χωρίς να είναι αισθητά χειρότερο, ή να εκτελείται γρηγορότερα χωρίς να έχει αποκτήσει καμία πρόσθετη ικανότητα.
1. Πώς δημιουργείται και πώς λειτουργεί ένα LLM
Από το μηδέν μέχρι ένα εκπαιδευμένο μοντέλο
Ας θεωρήσουμε ένα LLM με 8 δισεκατομμύρια παραμέτρους, δηλαδή ένα μοντέλο 8B.
Οι παράμετροι είναι αριθμητικές τιμές, τα λεγόμενα weights, που καθορίζουν πώς το νευρωνικό δίκτυο επεξεργάζεται τις πληροφορίες.
Στην αρχή της εκπαίδευσης, οι τιμές αυτές αρχικοποιούνται χωρίς το μοντέλο να διαθέτει ουσιαστική γλωσσική γνώση.
Κατά την εκπαίδευση:
- Το μοντέλο διαβάζει τεράστιες ποσότητες κειμένου, χωρισμένες σε μικρές μονάδες που ονομάζονται tokens.
- Προσπαθεί να προβλέψει το επόμενο token με βάση όσα έχουν προηγηθεί.
- Η πρόβλεψή του συγκρίνεται με το πραγματικό επόμενο token.
- Το σφάλμα χρησιμοποιείται για να διορθωθούν σταδιακά οι παράμετροι, με τη μέθοδο backpropagation.
- Η διαδικασία επαναλαμβάνεται σε εξαιρετικά μεγάλη κλίμακα.
Για παράδειγμα, αν το μοντέλο έχει διαβάσει:
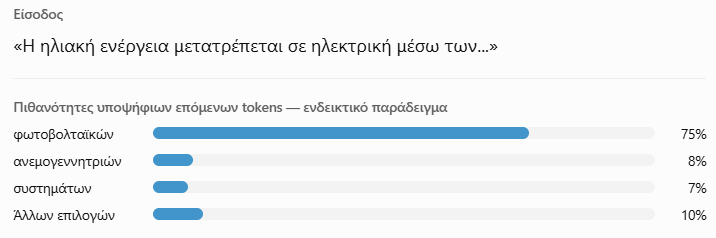
Καθώς εκπαιδεύεται, το μοντέλο μαθαίνει γλωσσικές, εννοιολογικές και άλλες στατιστικές συσχετίσεις. Δεν αποθηκεύει απλώς έναν κατάλογο έτοιμων προτάσεων.
Μετά την αρχική εκπαίδευση (pre-training), ακολουθούν συνήθως στάδια post-training, όπως supervised fine-tuning και εκπαίδευση με δεδομένα προτιμήσεων, ώστε το μοντέλο να ακολουθεί οδηγίες, να απαντά με κατάλληλο τρόπο και να ανταποκρίνεται καλύτερα σε συγκεκριμένα καθήκοντα.
Το αποτέλεσμα είναι ένα εκπαιδευμένο σύνολο παραμέτρων, μαζί με την περιγραφή της αρχιτεκτονικής και τον tokenizer.
Τι συμβαίνει όταν κατεβάζουμε και εκτελούμε το μοντέλο;
Η εκτέλεση ενός ήδη εκπαιδευμένου μοντέλου ονομάζεται inference. Δεν επαναλαμβάνουμε την εκπαίδευση.
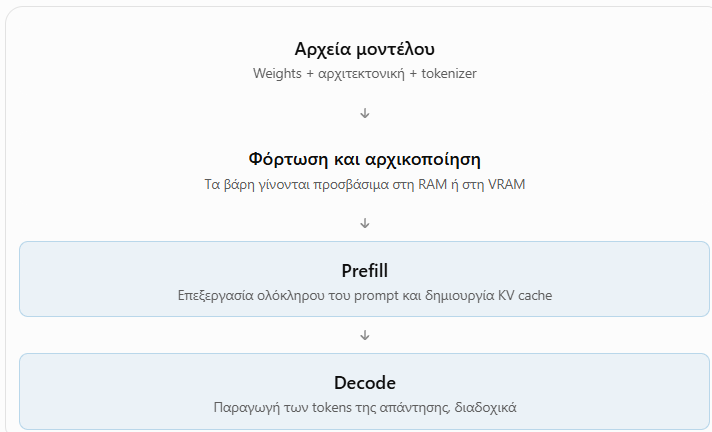
Εδώ εμφανίζεται ένας σημαντικός περιορισμός.
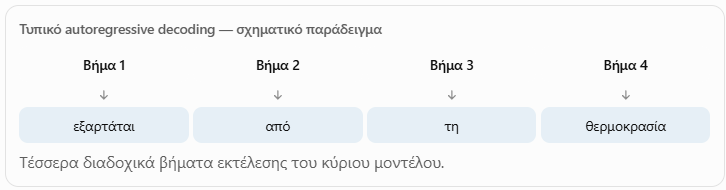
Σε ένα τυπικό autoregressive LLM, η παραγωγή είναι διαδοχική: το δεύτερο token εξαρτάται από το πρώτο, το τρίτο από τα προηγούμενα κ.ο.κ.
Επομένως, εάν ζητήσουμε μια απάντηση 1.000 tokens, το μοντέλο χρειάζεται κανονικά περίπου 1.000 διαδοχικά βήματα παραγωγής.
Αυτό εξηγεί γιατί η παραγωγή μεγάλων απαντήσεων είναι συχνά πιο αργή από την επεξεργασία ενός μεγάλου αρχικού prompt. Εξηγεί επίσης γιατί αναπτύχθηκαν το MTP και οι διάφορες μέθοδοι speculative decoding, τις οποίες θα εξετάσουμε παρακάτω.
2. Τι είναι το quantization και πώς γίνεται;
Το quantization είναι μια τεχνική αριθμητικής συμπίεσης του μοντέλου.
Η βασική ιδέα είναι απλή: αντί να αποθηκεύουμε κάθε παράμετρο με μεγάλη αριθμητική ακρίβεια, την αποθηκεύουμε με λιγότερα bits.
Σκεφτείτε ότι έχουμε μια τιμή βάρους:
0.37284651
Με περιορισμένη ακρίβεια, μπορούμε να την προσεγγίσουμε ως:
0.37
Η δεύτερη τιμή δεν είναι ακριβώς ίδια, αλλά παραμένει κοντά στην αρχική.
Στην πραγματικότητα, το quantization είναι πιο σύνθετο από την απλή στρογγυλοποίηση δεκαδικών ψηφίων. Χρησιμοποιεί διακριτές αριθμητικές στάθμες, συντελεστές κλίμακας (scales) και, σε ορισμένες μεθόδους, πρόσθετες διορθώσεις.
Ένα παράδειγμα 4-bit quantization
Έστω ότι έχουμε βάρη με τιμές μεταξύ −1 και +1.
Με ακρίβεια 4 bits, μπορούμε να κωδικοποιήσουμε 16 διαφορετικές στάθμες.
Αν ένα βάρος έχει πραγματική τιμή 0,37, το quantization το αντιστοιχίζει στην πλησιέστερη διαθέσιμη στάθμη, ανάλογα με την κλίμακα που χρησιμοποιούμε.
Η αρχική τιμή δεν διατηρείται ακριβώς. Εισάγεται ένα μικρό quantization error.
Όταν όμως επαναλάβουμε αυτή τη διαδικασία σε δισεκατομμύρια παραμέτρους, τα αριθμητικά σφάλματα μπορούν να επηρεάσουν τη συνολική συμπεριφορά του μοντέλου.
Το ζητούμενο δεν είναι απλώς να συμπιέσουμε όσο περισσότερο γίνεται. Είναι να ελαχιστοποιήσουμε το σφάλμα εκεί όπου αυτό επηρεάζει περισσότερο τις τελικές προβλέψεις.
Πόσο μειώνεται το μέγεθος;
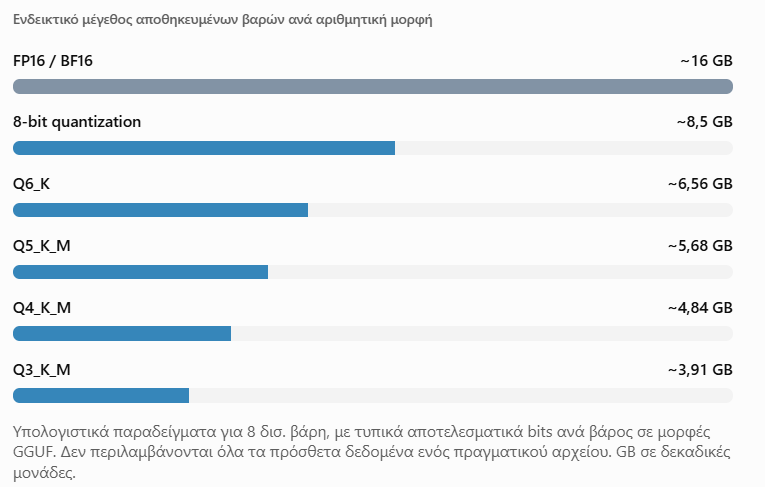
Ας χρησιμοποιήσουμε ξανά ένα υποθετικό μοντέλο 8B, δηλαδή 8 δισεκατομμύρια παραμέτρους.
Ενδεικτικό μέγεθος αποθηκευμένων βαρών ανά αριθμητική μορφή
Το μέγεθος του αρχείου προσεγγίζεται από τη σχέση:
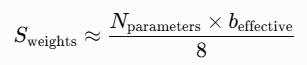
όπου beffective είναι τα πραγματικά bits ανά βάρος, συμπεριλαμβανομένου του επιμερισμένου κόστους για τις πληροφορίες κλίμακας και άλλων μεταδεδομένων quantization.
Το κρίσιμο σημείο: το 4-bit quantization μπορεί να περιορίσει το μέγεθος των βαρών ενός μοντέλου κατά περίπου 70–75% σε σχέση με το FP16, χωρίς να αφαιρέσει τις παραμέτρους ή να μειώσει την ονομαστική αρχιτεκτονική του.
Ένα 8B παραμένει 8B. Απλώς οι αριθμοί του αποθηκεύονται με μικρότερη ακρίβεια.
Γιατί βλέπουμε Q4_K_M, Q5_K_M, AWQ, GPTQ και GGUF;
Δεν είναι όλες αυτές οι ονομασίες το ίδιο πράγμα.
Το GGUF είναι μορφή αρχείου, ιδιαίτερα διαδεδομένη στη χρήση τοπικών LLMs με το llama.cpp.
Οι ονομασίες Q4_K_M, Q5_K_M και Q6_K περιγράφουν συγκεκριμένες μορφές κβαντοποίησης που υποστηρίζει το οικοσύστημα αυτό. Οι αριθμοί δείχνουν την ονομαστική ακρίβεια και τα υπόλοιπα σύμβολα προσδιορίζουν τον τρόπο κωδικοποίησης, ομαδοποίησης και χρήσης διαφορετικής ακρίβειας.
Αντίστοιχα, τα AWQ και GPTQ είναι αλγόριθμοι post-training quantization που προσπαθούν να περιορίσουν την απώλεια ακρίβειας, αξιοποιώντας πληροφορίες για τη συμπεριφορά των βαρών και των ενεργοποιήσεων του δικτύου.
Δεν είναι δηλαδή σωστό να θεωρούμε ότι όλα τα μοντέλα που αναφέρονται ως «4-bit» έχουν το ίδιο μέγεθος, την ίδια υπολογιστική απόδοση ή την ίδια ποιότητα.
LLM Compressor Docs+1
Γιατί ορισμένες μέθοδοι quantization είναι καλύτερες από άλλες;
Δεν είναι όλα τα βάρη εξίσου σημαντικά.
Μια μεταβολή της τάξης του 1% σε ένα βάρος μπορεί να έχει ελάχιστη επίδραση στην έξοδο. Η ίδια σχετική μεταβολή σε ένα άλλο βάρος μπορεί να επηρεάσει σημαντικά την πρόβλεψη.
Γι' αυτό υπάρχουν διαφορετικές προσεγγίσεις:
Το απλό round-to-nearest μετατρέπει κάθε βάρος στην πλησιέστερη διαθέσιμη τιμή.
Το group-wise quantization χωρίζει τα βάρη σε ομάδες, καθεμία με δική της κλίμακα, περιορίζοντας το σφάλμα από τις μεγάλες διαφορές μεταξύ των τιμών.
Οι μέθοδοι calibration, όπως AWQ και GPTQ, αξιοποιούν αντιπροσωπευτικά δεδομένα ώστε η συμπίεση να διατηρεί όσο γίνεται καλύτερα τη συμπεριφορά του αρχικού δικτύου.
Τέλος, το quantization-aware training (QAT) επιτρέπει στο μοντέλο να προσαρμόσει τα βάρη του κατά την εκπαίδευση ή το fine-tuning, έχοντας υπόψη τα σφάλματα της μελλοντικής κβαντοποίησης.
PyTorch+1
Άρα, η ποιότητα δεν εξαρτάται μόνο από τον αριθμό των bits, αλλά και από το πώς επιλέγουμε να τα χρησιμοποιήσουμε.
3. Πώς μετράμε την ποιότητα ενός μοντέλου μετά το quantization;
Εδώ πρέπει να ξεχωρίσουμε δύο διαφορετικές έννοιες της απόδοσης:
Model quality: Πόσο σωστά απαντά το μοντέλο;
Inference performance: Πόσο γρήγορα απαντά και με πόσους υπολογιστικούς πόρους;
Ένα quantized μοντέλο μπορεί να έχει υψηλή υπολογιστική απόδοση αλλά μειωμένη ακρίβεια. Συνεπώς, χρειαζόμαστε μετρήσεις και των δύο.
A. Perplexity (PPL): Πόσο καλά προβλέπει το κείμενο;
Το perplexity είναι μία από τις συνηθέστερες μετρικές για τη βασική γλωσσική επίδοση.
Σε απλούς όρους, μετρά πόσο «εκπλήσσεται» το μοντέλο από το πραγματικό επόμενο token ενός κειμένου.
Όσο μικρότερη είναι το perplexity, τόσο μεγαλύτερη πιθανότητα αποδίδει, κατά μέσο όρο, το μοντέλο στα πραγματικά tokens του συνόλου αξιολόγησης.
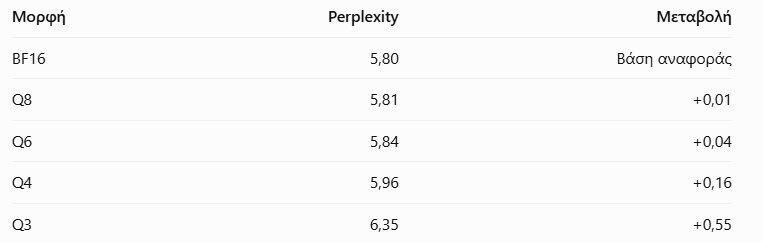
Ας υποθέσουμε ότι αξιολογούμε το ίδιο 8B μοντέλο σε διαφορετικές μορφές:
Με βάση αυτά τα αποτελέσματα, θα συμπεραίναμε ότι το Q8 και το Q6 διατηρούν σχεδόν πλήρως τη γλωσσική συμπεριφορά του αρχικού μοντέλου, ενώ το Q3 προκαλεί μεγαλύτερη απόκλιση.
Όμως το perplexity έχει έναν σημαντικό περιορισμό: δεν μας λέει απαραίτητα αν το μοντέλο εξακολουθεί να λύνει σωστά σύνθετα προβλήματα.
Ένα μοντέλο μπορεί να έχει πολύ μικρή μεταβολή perplexity και παρ' όλα αυτά να κάνει περισσότερα λάθη σε μαθηματικά, προγραμματισμό ή στην τήρηση συγκεκριμένων οδηγιών.
B. Σύγκριση πιθανότητας των tokens: KL divergence
Ένας συμπληρωματικός τρόπος είναι να συγκρίνουμε τις κατανομές πιθανοτήτων του αρχικού και του quantized μοντέλου.
Η
Kullback–Leibler divergence (KL divergence) ποσοτικοποιεί πόσο αποκλίνει η μία κατανομή από την άλλη.
Για παράδειγμα, εάν το αρχικό μοντέλο δίνει 75% πιθανότητα στη λέξη «φωτοβολταϊκών» και το quantized δίνει 74%, η διαφορά είναι μικρή.
Εάν όμως το quantized μοντέλο δίνει 35%, έχουμε πολύ μεγαλύτερη μεταβολή στη συμπεριφορά του.
Αυτές οι μετρήσεις βοηθούν να εντοπίσουμε αριθμητική υποβάθμιση, αλλά δεν αρκούν από μόνες τους για να αξιολογήσουμε την πρακτική χρησιμότητα του μοντέλου. Το llama.cpp χρησιμοποιεί τόσο perplexity όσο και KL divergence για την αξιολόγηση μορφών quantization.
C. Benchmarks πραγματικών ικανοτήτων
Γι' αυτό χρησιμοποιούμε και δοκιμασίες στις οποίες υπάρχει αναμενόμενη ή επαληθεύσιμη απάντηση.
Ενδεικτικά, το MMLU-Pro αξιολογεί γνώση και συλλογιστική σε πολλούς επιστημονικούς τομείς, το GPQA απαιτητική επιστημονική συλλογιστική, τα GSM8K/MATH μαθηματικές ικανότητες και το IFEval την τήρηση οδηγιών και περιορισμών.
Για ένα μοντέλο που πρόκειται να χρησιμοποιηθεί σε τεχνική ή επιστημονική εργασία, η αξιολόγηση πρέπει επιπλέον να περιλαμβάνει εξειδικευμένα προβλήματα του πραγματικού πεδίου εφαρμογής.
Για παράδειγμα, σε ενεργειακές εφαρμογές θα ήταν χρήσιμο να ελεγχθούν υπολογισμοί ενεργειακών ισοζυγίων, μετατροπές μονάδων, ερμηνεία τεχνικών προδιαγραφών και εξαγωγή δεδομένων από κανονιστικά κείμενα.
Αυτό έχει ιδιαίτερη σημασία διότι η υποβάθμιση δεν είναι ομοιόμορφη μεταξύ εργασιών.
Μία μελέτη που δημοσιεύθηκε στο EMNLP 2025 εξέτασε 9.700 περιπτώσεις με μεγάλα συμφραζόμενα, πέντε μεθόδους quantization και πέντε μοντέλα. Βρήκε ότι το 8-bit διατηρούσε κατά μέσο όρο σχεδόν την αρχική ακρίβεια (πτώση περίπου 0,8%), ενώ ορισμένες 4-bit διαμορφώσεις παρουσίασαν πολύ μεγάλες απώλειες σε συγκεκριμένες εργασίες μεγάλου context, που έφτασαν έως 59%. Η επιδείνωση ήταν εντονότερη σε μη αγγλόφωνες εισόδους.
Αυτό δεν σημαίνει ότι κάθε 4-bit μοντέλο είναι προβληματικό. Σημαίνει ότι τα γενικά benchmarks μπορεί να αποκρύπτουν σοβαρές αδυναμίες σε συγκεκριμένες χρήσεις, ιδιαίτερα σε μεγάλα τεχνικά κείμενα και σε γλώσσες πέρα από τα αγγλικά.
4. Τι είναι το MTP (Multi-Token Prediction);
Το MTP είναι μια τεχνική που επεκτείνει την εκπαίδευση ή/και την πρόβλεψη ενός LLM πέρα από το αμέσως επόμενο token.
Για να το κατανοήσουμε, ας συγκρίνουμε τη συμβατική παραγωγή με την παραγωγή που αξιοποιεί MTP.
Συμβατική παραγωγή
Ας ζητήσουμε από το μοντέλο να συνεχίσει τη φράση:
«Η απόδοση του φωτοβολταϊκού συστήματος...»
Το μοντέλο παράγει το πρώτο token, χρησιμοποιεί αυτό το αποτέλεσμα για να προβλέψει το δεύτερο, στη συνέχεια το τρίτο κ.ο.κ.
Τι αλλάζει με το MTP;
Σε μια αρχιτεκτονική που υποστηρίζει MTP, πρόσθετα τμήματα του δικτύου εκπαιδεύονται να προβλέπουν περισσότερα μελλοντικά tokens.
Στην περίπτωση του DeepSeek-V3, για παράδειγμα, το MTP χρησιμοποιήθηκε κυρίως ως πρόσθετος στόχος εκπαίδευσης.
Το μοντέλο δεν μαθαίνει απλώς να προβλέπει το επόμενο token αλλά λαμβάνει πρόσθετα εκπαιδευτικά σήματα και για επόμενες θέσεις. Αυτό μπορεί να βελτιώσει τις εσωτερικές αναπαραστάσεις και την αποτελεσματικότητα της εκπαίδευσης.
Τα πρόσθετα MTP modules μπορούν έπειτα είτε να παραλειφθούν κατά το inference είτε να χρησιμοποιηθούν για επιτάχυνση.
Πώς το MTP επιταχύνει το inference;
Η βασική εφαρμογή είναι το speculative decoding.
Αντί να απαιτούμε από το πλήρες μοντέλο να υπολογίσει κάθε token ξεχωριστά, χρησιμοποιούμε έναν γρήγορο μηχανισμό για να προτείνουμε περισσότερα πιθανά επόμενα tokens.
Στη συνέχεια, το κύριο μοντέλο τα ελέγχει μαζί, με υπολογισμούς που μπορούν να πραγματοποιηθούν παράλληλα.
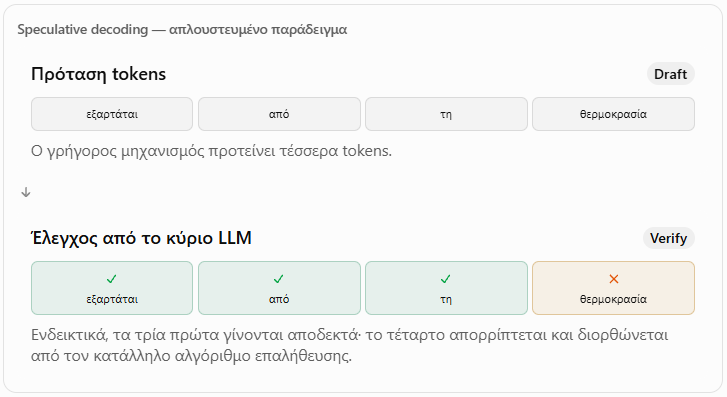
Το κέρδος προκύπτει επειδή δεν χρειάζονται απαραίτητα τέσσερις διαδοχικές εκτελέσεις του πλήρους μοντέλου για τέσσερα tokens.
Η επιτάχυνση εξαρτάται από το πόσες προτάσεις γίνονται αποδεκτές και πόσο κοστίζει η παραγωγή και η επαλήθευσή τους.
Το πιο σημαντικό: σε μια σωστά υλοποιημένη exact speculative decoding διαδικασία, η στατιστική κατανομή των τελικών απαντήσεων παραμένει ίδια με εκείνη του κύριου μοντέλου, με δεδομένο τον ίδιο μηχανισμό sampling.
Άρα, το speculative decoding δεν είναι από μόνο του μέθοδος βελτίωσης της ποιότητας. Είναι πρωτίστως μέθοδος επιτάχυνσης.
Αυξάνει το MTP το μέγεθος του αρχείου;
Εξαρτάται από το εάν τα πρόσθετα MTP modules περιλαμβάνονται στα αρχεία του μοντέλου.
Το επίσημο DeepSeek-V3 αναφέρει 671 δισεκατομμύρια παραμέτρους για το κύριο μοντέλο και περίπου 14 δισεκατομμύρια επιπλέον παραμέτρους που συνδέονται με το MTP στο δημοσιευμένο checkpoint.
Επομένως, το αρχείο με MTP μπορεί να είναι μεγαλύτερο, αλλά τα MTP modules δεν είναι υποχρεωτικό να χρησιμοποιούνται σε κάθε εγκατάσταση.
Όταν χρησιμοποιούνται, καταλαμβάνουν πρόσθετη μνήμη και απαιτούν υπολογισμούς. Το συνολικό inference μπορεί ωστόσο να γίνει γρηγορότερο εφόσον η εξοικονόμηση από τα αποδεκτά speculative tokens υπερβαίνει αυτό το πρόσθετο κόστος.
5. Τι είναι τα n-gram tables και γιατί χρησιμοποιούνται;
Ένα
n-gram είναι μια ακολουθία από
n διαδοχικά tokens.
Αν έχουμε τη φράση:
«Η ενεργειακή απόδοση του συστήματος είναι υψηλή»
και θεωρήσουμε, για λόγους απλότητας, κάθε λέξη ως ένα token, τότε:
Το «ενεργειακή απόδοση» είναι ένα 2-gram.
Το «ενεργειακή απόδοση του» είναι ένα 3-gram.
Το «ενεργειακή απόδοση του συστήματος» είναι ένα 4-gram.
Τα n-gram tables είναι πίνακες που αντιστοιχίζουν τέτοιες ακολουθίες σε πιθανές συνέχειες, συχνότητες ή ήδη παρατηρημένα μοτίβα.
Ένα απλό παράδειγμα
Έστω ότι έχουμε ένα μεγάλο τεχνικό κείμενο στο οποίο επαναλαμβάνονται ορισμένες φράσεις.
Ένας n-gram πίνακας θα μπορούσε να περιέχει:
| Ακολουθία που εντοπίστηκε | Συχνότερη συνέχεια |
|---|
| Η ενεργειακή απόδοση | του συστήματος |
| Ο συντελεστής ισχύος | είναι ίσος |
| Η εγκατεστημένη ισχύς | του φωτοβολταϊκού |
| Η ετήσια παραγωγή | ηλεκτρικής ενέργειας |
Αν το LLM έχει ήδη επεξεργαστεί ένα κείμενο που περιλαμβάνει τέτοιες φράσεις, μπορεί να χρησιμοποιήσει τον πίνακα για να προτείνει γρήγορα πιθανές συνέχειες.
Ποια είναι η σχέση τους με το speculative decoding;
Τα n-gram tables μπορούν να λειτουργούν ως ένας εξαιρετικά ελαφρύς μηχανισμός παραγωγής υποψήφιων tokens.
Αντί για ένα πρόσθετο νευρωνικό δίκτυο, όπως συμβαίνει με ένα MTP module ή ένα μικρό draft model, χρησιμοποιούμε αναζήτηση σε αποθηκευμένα μοτίβα.
Το κύριο LLM εξακολουθεί να ελέγχει τα υποψήφια tokens.
Στην πράξη, το llama.cpp παρέχει διαφορετικές υλοποιήσεις, όπως n-gram cache, απλή αναζήτηση μοτίβων στο ιστορικό και πίνακες hash. Ορισμένες μπορούν να αξιοποιήσουν και εξωτερικά αρχεία στατιστικών.
GitHub
Πότε λειτουργούν καλύτερα;
Είναι ιδιαίτερα αποτελεσματικά όταν υπάρχει επανάληψη στο αρχικό υλικό ή στην παραγόμενη απάντηση.
Για παράδειγμα, στην επεξεργασία κώδικα, στην αναδιατύπωση μεγάλων εγγράφων, στη μετατροπή πινάκων ή στην αναπαραγωγή επαναλαμβανόμενων δομών.
Είναι λιγότερο αποτελεσματικά σε ένα εντελώς νέο, σύνθετο πρόβλημα συλλογιστικής, όπου η συνέχεια δεν έχει εμφανιστεί προηγουμένως.
Η σημαντική διαφορά από το MTP είναι ότι ένας απλός n-gram μηχανισμός δεν χρειάζεται να «κατανοήσει» την πιθανή συνέχεια. Αξιοποιεί μοτίβα που έχουν ήδη παρατηρηθεί.
Αυτό τον καθιστά πολύ φθηνό υπολογιστικά, αλλά περιορίζει την ικανότητά του να προβλέπει νέες ακολουθίες.
Πόσο χώρο καταλαμβάνουν;
Συνήθως πολύ λιγότερο από το ίδιο το LLM.
Ένας n-gram πίνακας μπορεί να δημιουργείται δυναμικά από το prompt και το ιστορικό παραγωγής, οπότε δεν απαιτεί ξεχωριστό αρχείο μοντέλου.
Εναλλακτικά, μπορεί να φορτώνεται από εξωτερικό αρχείο. Τότε αυξάνονται ανάλογα ο αποθηκευτικός χώρος και η RAM.
Για παράδειγμα, η υλοποίηση
ngram-mod του llama.cpp περιγράφεται ως ελαφριά, με περίπου 16 MB μνήμης. Αυτό είναι χαρακτηριστικό της συγκεκριμένης υλοποίησης και όχι γενικό όριο για όλα τα n-gram tables.
6. Πώς επηρεάζουν όλα αυτά το download, την ταχύτητα, τη RAM και τη VRAM;
Πρώτα πρέπει να διευκρινίσουμε κάτι ιδιαίτερα σημαντικό:
Το μέγεθος του αρχείου του μοντέλου δεν ισούται με τη μνήμη που χρειάζεται κατά την εκτέλεση.
Γιατί;
Εκτός από τα weights, το inference απαιτεί χώρο για ενδιάμεσους υπολογισμούς, buffers, ενδεχόμενα draft/MTP modules και, κυρίως, την KV cache.
Τι είναι η KV cache;
Κατά την επεξεργασία ενός κειμένου, ο Transformer υπολογίζει εσωτερικές αναπαραστάσεις που χρησιμοποιούνται από τον μηχανισμό attention.
Για να μην επαναλαμβάνει όλους τους προηγούμενους υπολογισμούς σε κάθε νέο token, αποθηκεύει τις αντίστοιχες αναπαραστάσεις Keys και Values.
Αυτή είναι η KV cache.
Η μνήμη της αυξάνεται, κατά προσέγγιση, ανάλογα με το μήκος του context και τον αριθμό ταυτόχρονων αιτημάτων. Εξαρτάται επίσης από την αρχιτεκτονική attention και την ακρίβεια αποθήκευσης των Keys και Values.
NVIDIA Technical Blog
Για παράδειγμα, σε μια ενδεικτική αρχιτεκτονική με 32 layers, 8 KV heads, head dimension 128 και FP16 KV cache, έχουμε περίπου:
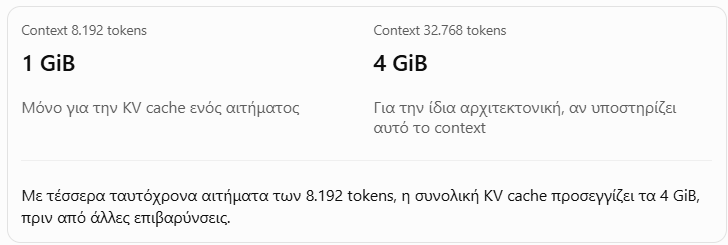
Αυτό σημαίνει ότι ένα μοντέλο Q4 με αρχείο περίπου 5 GB μπορεί να χρειαστεί πολύ περισσότερη συνολική μνήμη για να υποστηρίξει μεγάλα contexts και πολλούς ταυτόχρονους χρήστες.
Επιπλέον, το quantization των weights δεν μειώνει αυτόματα και την KV cache. Υπάρχουν ξεχωριστές τεχνικές KV-cache quantization, με δικά τους οφέλη και ενδεχόμενες απώλειες ποιότητας.
Συγκριτική επίδραση όλων των τεχνικών
| Τεχνική | Αρχείο download | RAM / VRAM | Ταχύτητα | Ποιότητα |
|---|
| Quantization 8-bit | Σημαντικά μικρότερο | Σημαντικά χαμηλότερη για weights | Συχνά βελτιώνεται | Συνήθως πολύ κοντά στην αρχική |
| Quantization 4-bit | Πολύ μικρότερο | Πολύ χαμηλότερη για weights | Συχνά βελτιώνεται | Πιθανή υποβάθμιση, ανάλογα με την εργασία |
| Quantization 2–3-bit | Εξαιρετικά μικρό | Ελάχιστη για weights | Εξαρτάται έντονα από hardware και kernels | Αυξημένος κίνδυνος υποβάθμισης |
| MTP για speculative decoding | Πρόσθετο μέγεθος αν περιλαμβάνονται MTP weights | Πρόσθετη μνήμη | Δυνητικά σημαντική επιτάχυνση | Κανονικά ίδια με το κύριο μοντέλο όταν η επαλήθευση είναι exact |
| N-gram speculation | Συνήθως αμετάβλητο | Μικρή πρόσθετη μνήμη | Επιτάχυνση κυρίως σε επαναληπτικά κείμενα | Κανονικά ίδια με το κύριο μοντέλο με exact verification |
| KV-cache quantization | Δεν αλλάζει ουσιαστικά τα model weights | Μειώνει τη μνήμη του context | Εξαρτάται από την υλοποίηση | Ενδέχεται να επηρεάσει την ακρίβεια |
Οι εκτιμήσεις αυτές είναι ποιοτικές, όχι εγγυημένες επιδόσεις. Η τελική συμπεριφορά εξαρτάται έντονα από τον συνδυασμό μοντέλου, inference engine και hardware.
Γιατί το 4-bit δεν είναι πάντα ταχύτερο από το 8-bit;
Η συμπίεση μειώνει την ποσότητα των δεδομένων που χρειάζεται να διαβαστούν από τη μνήμη.
Αυτό είναι σημαντικό γιατί μεγάλο μέρος του autoregressive decoding, ιδιαίτερα με λίγα ταυτόχρονα αιτήματα, περιορίζεται από το bandwidth της μνήμης.
Όμως τα quantized weights χρειάζονται κατάλληλους υπολογιστικούς kernels. Μπορεί να απαιτούν αποσυμπίεση ή μετατροπές πριν από τις πράξεις.
Αν το hardware υποστηρίζει ιδιαίτερα αποτελεσματικά το INT8 ή το FP8 αλλά όχι μια συγκεκριμένη 4-bit μορφή, η 8-bit υλοποίηση μπορεί να είναι ταχύτερη παρά το μεγαλύτερο μέγεθός της.
Επομένως, λιγότερα bits δεν συνεπάγονται αυτόματα μεγαλύτερη ταχύτητα. Η συμβατότητα των kernels με τον επεξεργαστή είναι καθοριστική.
GitHub+1
Το ίδιο ισχύει για CPU και GPU. Ένα μοντέλο που χωρά εξ ολοκλήρου στη VRAM μπορεί να είναι σημαντικά ταχύτερο από ένα μεγαλύτερο μοντέλο του οποίου μέρος πρέπει να παραμένει στη RAM και να μεταφέρεται μέσω PCIe.
7. Πώς μετράμε την πραγματική ταχύτητα;
Η έκφραση «το μοντέλο παράγει 50 tokens/sec» είναι χρήσιμη, αλλά δεν περιγράφει ολόκληρη την εμπειρία.
Χρειάζονται τουλάχιστον τέσσερις διακριτές μετρήσεις.
Time to First Token (TTFT): Πόσος χρόνος μεσολαβεί από την υποβολή του αιτήματος μέχρι να εμφανιστεί το πρώτο token. Επηρεάζεται ιδιαίτερα από το μέγεθος του prompt, τη διαδικασία prefill και πιθανή αναμονή σε ουρά.
Time per Output Token (TPOT): Ο μέσος χρόνος παραγωγής κάθε token μετά το πρώτο. Είναι ιδιαίτερα χρήσιμος για τη μέτρηση της ταχύτητας αποκωδικοποίησης.
Throughput: Πόσα tokens παράγει συνολικά το σύστημα ανά δευτερόλεπτο. Σε ένα server με πολλούς χρήστες, μπορεί να αυξηθεί το συνολικό throughput ακόμη κι αν μειωθεί η ταχύτητα ανά χρήστη.
Peak RAM / VRAM: Η μέγιστη μνήμη που καταλαμβάνεται κατά την εκτέλεση, συμπεριλαμβανομένων των caches και των ενδιάμεσων υπολογισμών.
Οι TTFT και TPOT αποτελούν καθιερωμένες μετρικές στα εργαλεία benchmarking του vLLM.
Στο MTP και στο n-gram speculative decoding προσθέτουμε τη μέτρηση του draft acceptance rate: τι ποσοστό των προτεινόμενων tokens γίνεται τελικά αποδεκτό.
Ωστόσο, ακόμη σημαντικότερος δείκτης είναι πόσα tokens γίνονται αποδεκτά ανά κύκλο επαλήθευσης και πόσο χρόνο κοστίζει ο κύκλος. Ένα υψηλό acceptance rate δεν συνεπάγεται αυτομάτως αντίστοιχο speedup.
Ένα πρακτικό πρωτόκολλο αξιολόγησης
Για να συγκρίνουμε αξιόπιστα τρεις εκδόσεις του ίδιου μοντέλου, π.χ. BF16, Q8 και Q4, πρέπει να χρησιμοποιήσουμε ακριβώς τα ίδια prompts, ίδιες ρυθμίσεις παραγωγής, ίδιο hardware και τον ίδιο inference engine.
Αρχικά μετράμε την ποιότητα χωρίς speculative decoding. Έτσι απομονώνουμε την επίδραση του quantization.
Στη συνέχεια κρατάμε σταθερό το quantized μοντέλο και ενεργοποιούμε διαδοχικά MTP και n-gram speculation. Έτσι μπορούμε να αποδώσουμε τις μεταβολές ταχύτητας στον μηχανισμό επιτάχυνσης και όχι στη συμπίεση των weights.
Τα tests πρέπει να καλύπτουν μικρά και μεγάλα prompts, σύντομες και μεγάλες απαντήσεις και διαφορετικά επίπεδα ταυτόχρονης χρήσης. Για στοχαστική παραγωγή χρειάζονται επαναλήψεις και κατάλληλη εκτίμηση αβεβαιότητας.
8. Τελικά, πώς επιλέγουμε την κατάλληλη διαμόρφωση;
Η βέλτιστη επιλογή δεν είναι εκείνη που παράγει το μικρότερο δυνατό αρχείο. Είναι εκείνη που ικανοποιεί ταυτόχρονα έναν αποδεκτό περιορισμό ποιότητας, τη διαθέσιμη μνήμη και τις απαιτήσεις ταχύτητας.
Ως πρακτική αφετηρία:
Για χρήση υψηλής ακρίβειας, όπως επιστημονική ανάλυση, τεχνικοί υπολογισμοί ή επεξεργασία μεγάλων κανονιστικών κειμένων, η BF16 ή μια καλή 8-bit υλοποίηση προσφέρει συνήθως πιο συντηρητική επιλογή.
Για τοπική χρήση με περιορισμένη VRAM, μια καλή Q4 ή Q5 μορφή μπορεί να προσφέρει εξαιρετικό συμβιβασμό, αρκεί να επαληθευτεί ότι διατηρεί την αναγκαία ακρίβεια στο συγκεκριμένο πεδίο εφαρμογής.
Αφού επιλεγεί το κατάλληλο quantization, μπορούμε να εξετάσουμε MTP ή n-gram speculative decoding για περαιτέρω επιτάχυνση. Δεν πρέπει να συγχέουμε αυτή τη βελτιστοποίηση με την ποιότητα του ίδιου του μοντέλου.
Η ουσιαστική σχέση μπορεί να συνοψιστεί ως εξής:
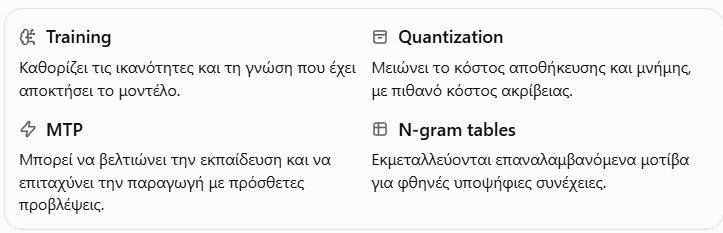
Το κεντρικό συμπέρασμα είναι ότι το quantization βελτιστοποιεί κυρίως την αναπαράσταση του μοντέλου, ενώ το speculative decoding βελτιστοποιεί τον τρόπο με τον οποίο το χρησιμοποιούμε. Είναι δύο διαφορετικά επίπεδα παρέμβασης και μπορούν να λειτουργούν συμπληρωματικά.
Για μια τεχνικά τεκμηριωμένη επιλογή χρειάζεται να εξετάζουμε από κοινού την ποιότητα, τα GB μνήμης, τα tokens/sec, τη διάρκεια του context και το συγκεκριμένο υπολογιστικό περιβάλλον. Μόνο έτσι γνωρίζουμε εάν η συμπίεση και η επιτάχυνση αποτελούν πραγματική βελτίωση και όχι απλώς μικρότερο αρχείο ή μεγαλύτερη ονομαστική ταχύτητα.