Τεχνητή Νοημοσύνη (AI). Τι είναι, τι ξέρουμε, τι αλλάζει στη ζωή και στον πολιτισμό;

Μετά από λίγες μέρες με το Mythos 5.2 και έχοντας του βάλει ορισμένα αρκετά σύνθετα tasks να ολοκληρώσει -ορισμένα εκ των οποίων τρέχουν ακόμη, παρότι εδώ και κάποιους μήνες το πιστεύω πραγματικά πως έχουμε λύσει το software engineering, συνεπώς δεν περίμενα να λύσει κάτι περισσότερο, διαπιστώνω το εξής. Πρόκειται για το πρώτο μοντέλο που αμφισβητεί επιλογές αρχιτεκτονικής ή/και ρωτάει για πιθανές αβλεψίες.

Και δεν είναι πως αμφισβητεί λάθος επιλογές αρχιτεκτονικής αλλά εκεί που πραγματικά "έμεινα" ήταν όταν μου έβαλε μέσα και ρυθμιστικές παραμέτρους του κανονιστικού πλαισίου.

Πρόκειται όντως για κάτι ιδιαίτερο και ξεχωριστό σε σχέση με ότι έχουμε μέχρι σήμερα. Εγώ τώρα πως το χρησιμοποιώ, το έχω σαν orchestrator, συζητάω μαζί του για τον τελικό στόχο, κάνω τις επιλογές αρχιτεκτονικής και μετά τα στέλνει σε sub-agents Opus 5.5 για την υλοποίηση.

Τώρα πόσο καταλήγει να κοστίζει αυτό. Σίγουρα όχι εξωφρενικά μεγαλύτερα νούμερα εφόσον τη πολλή δουλειά τη κάνει το Opus. Και τη κάνει εξαιρετικά.

View attachment 280959

Σε άλλα νέα, βγήκε και το Gemini 4 Carbon.
Λέω ευκαιρία να το δοκιμάσω λίγο από το Gemini Enterprise της δουλειάς, ας του βάλω το prompt που είχαμε κάνει εδώ δοκιμή με το 4 Argon.
Το harness είναι τόσο κακό, που μετά από 15 λεπτά βγάζει μήνυμα πως έκανε time-out και να σπάσω το request σε μικρότερα tasks. Όσο καλό μοντέλο και να είναι -που είναι, εάν το harness είναι απαράδεκτο σε τέτοιο σημείο που να σου σπάει τα νεύρα, για την καθημερινή τυπική δουλειά δεν κάνει.

Εν αντιθέσει με αυτό, στο API του, το ενσωματώσαμε σε μια από τις εφαρμογές μας άμεσα και είναι αρκετά καλύτερα τα αποτελέσματα σε σχέση με το Argon.

Τέλος, δείτε και αυτό. Μετά τη κυκλοφορία του Opus 5.5 η Anthropic πήγε πάλι στην εκθετική αύξηση επισκεψιμότητας.

View attachment 280960
Μιας και τα χρησιμοποιείς όλα κάθε Ai που πιστεύεις είναι καλύτερο σε πιο τομεα grok, Gemini, GPT, claude, copilot?
 
Δεν απαντάται σε μια γραμμή αυτό.

Για τον μέσο άνθρωπο που θέλει καλά αποτελέσματα σε διάφορα tasks, αυτή τη στιγμή η καλύτερη επιλογή είναι να πάρει την 20ευρη συνδρομή του Claude, να χρησιμοποιεί το τελευταίο μοντέλο Opus και το αποτέλεσμα που θα παίρνει είναι κοντά στο κορυφαίο διαθέσιμο και με αρκετή διαθέσιμη χρήση στη συνδρομή.

Το οικοσύστημα είναι το πιο πλήρες, έχει extensions σε office, πολύ δυνατό browser use, είναι αυτή τη στιγμή η καλύτερη εμπειρία.


Τώρα για τους υπόλοιπους που είμαστε κάπως power users και nerds.

Για προγραμματισμό, πάλι, τα μοντέλα της Anthropic είναι τα καλύτερα αυτή τη στιγμή. Τον κύριο όγκο δουλειάς εάν θέλεις να τον κάνεις με φυσιολογικό κόστος θα τον κάνει το εκάστοτε Opus ή το αντίστοιχο της OpenAI επίπεδο μοντέλου, το Sol. Αυτή τη στιγμή, το Opus είναι πολύ καλύτερο σε σχέση με το διαθέσιμο Sol, οπότε δεν υπάρχει σύγκριση εκεί. Το Astra είναι μια χαρά μοντέλο, δεν του λείπει κάτι, αλλά λόγω κόστους δεν μπορεί να είναι το βασικό μοντέλο που χρησιμοποιεί κανείς. Fable/Mythos είναι στη κορυφή σήμερα, πραγματικά μοναδικά σε αυτό που κάνουν, επίσης με υψηλό κόστος, εάν έχεις απεριόριστη χρήση API μέσω της εταιρίας για παράδειγμα, φυσικά χρησιμοποιείς αυτό.

Επειδή δεν μπορείς να κάνεις βαριά χρήση των καλών μοντέλων σε επίπεδο chat και να τρέχουν και projects, εγώ προσωπικά χρησιμοποιώ για ότι μικρό θέλω να ρωτήσω, τη συνδρομή του Gemini Enterprise. Νομίζω πληρώνουμε περίπου ~30 ευρώ/μήνα/θέση και περιλαμβάνει πρακτικά απεριόριστη χρήση στο βασικό chat. Το Gemini 4 Carbon στα μικρά tasks είναι εξαιρετικό, επίσης γράφει τα καλύτερα Ελληνικά μεταξύ των διαφόρων επιλογών (και το καινούριο Fable είναι κοντά).

Για την ίδια χρήση, εάν κάποιος έχει από τη δουλειά του το premium 365 copilot, που έχει διαθέσιμο το 6.1 Sol, μια χαρά αποτέλεσμα θα πάρει και από αυτό στα περισσότερα tasks. Ούτε και εκεί κατάφερα να τερματίσω τη χρήση του.

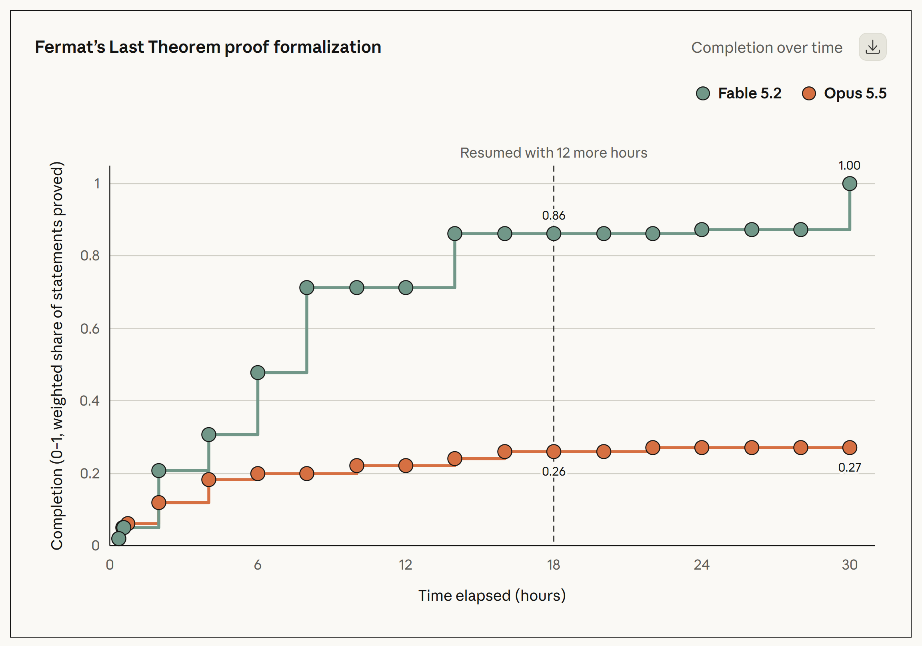
Όσον αφορά την επιστημονική έρευνα, δεν είμαι σε θέση να αξιολογήσω πρωτογενή αποτελέσματα αλλά δεν νομίζω πως είναι πρακτικά χρήσιμα στον περισσότερο κόσμο. Τι εννοώ, το σημερινό Fable 5.2 έκανε την απόδειξη του τελευταίου θεωρήματος του Fermat. Wow, καταπληκτικό, αλλά αυτό έγινε με 1000 agents να δουλεύουν επί 30 ώρες. Αντίστοιχα να ξέρετε και για το cybersecurity. Τα βασικά sweeps που βάζουμε να κάνουν τα μοντέλα με τυπικό κόστος, δεν έχουν σχέση με τις δυνατότητες τους οι οποίες για να φτάσουν στο επίπεδο που διαφημίζεται, απαιτούν πολλές ώρες αυτόνομης δουλειάς πολλών agent ταυτόχρονα με κόστος τετραψήφια-πενταψήφια νούμερα.

1794411466767.png


Για τον grok δεν έχω άποψη, είναι πολύ πίσω. Η Meta φαίνεται να έβγαλε καλά μοντέλα αλλά δεν έχει εργαλεία να τα δουλέψεις.
 
  • Like
Reactions: speedman_27
Δεν απαντάται σε μια γραμμή αυτό.

Για τον μέσο άνθρωπο που θέλει καλά αποτελέσματα σε διάφορα tasks, αυτή τη στιγμή η καλύτερη επιλογή είναι να πάρει την 20ευρη συνδρομή του Claude, να χρησιμοποιεί το τελευταίο μοντέλο Opus και το αποτέλεσμα που θα παίρνει είναι κοντά στο κορυφαίο διαθέσιμο και με αρκετή διαθέσιμη χρήση στη συνδρομή.

Το οικοσύστημα είναι το πιο πλήρες, έχει extensions σε office, πολύ δυνατό browser use, είναι αυτή τη στιγμή η καλύτερη εμπειρία.


Τώρα για τους υπόλοιπους που είμαστε κάπως power users και nerds.

Για προγραμματισμό, πάλι, τα μοντέλα της Anthropic είναι τα καλύτερα αυτή τη στιγμή. Τον κύριο όγκο δουλειάς εάν θέλεις να τον κάνεις με φυσιολογικό κόστος θα τον κάνει το εκάστοτε Opus ή το αντίστοιχο της OpenAI επίπεδο μοντέλου, το Sol. Αυτή τη στιγμή, το Opus είναι πολύ καλύτερο σε σχέση με το διαθέσιμο Sol, οπότε δεν υπάρχει σύγκριση εκεί. Το Astra είναι μια χαρά μοντέλο, δεν του λείπει κάτι, αλλά λόγω κόστους δεν μπορεί να είναι το βασικό μοντέλο που χρησιμοποιεί κανείς. Fable/Mythos είναι στη κορυφή σήμερα, πραγματικά μοναδικά σε αυτό που κάνουν, επίσης με υψηλό κόστος, εάν έχεις απεριόριστη χρήση API μέσω της εταιρίας για παράδειγμα, φυσικά χρησιμοποιείς αυτό.

Επειδή δεν μπορείς να κάνεις βαριά χρήση των καλών μοντέλων σε επίπεδο chat και να τρέχουν και projects, εγώ προσωπικά χρησιμοποιώ για ότι μικρό θέλω να ρωτήσω, τη συνδρομή του Gemini Enterprise. Νομίζω πληρώνουμε περίπου ~30 ευρώ/μήνα/θέση και περιλαμβάνει πρακτικά απεριόριστη χρήση στο βασικό chat. Το Gemini 4 Carbon στα μικρά tasks είναι εξαιρετικό, επίσης γράφει τα καλύτερα Ελληνικά μεταξύ των διαφόρων επιλογών (και το καινούριο Fable είναι κοντά).

Για την ίδια χρήση, εάν κάποιος έχει από τη δουλειά του το premium 365 copilot, που έχει διαθέσιμο το 6.1 Sol, μια χαρά αποτέλεσμα θα πάρει και από αυτό στα περισσότερα tasks. Ούτε και εκεί κατάφερα να τερματίσω τη χρήση του.

Όσον αφορά την επιστημονική έρευνα, δεν είμαι σε θέση να αξιολογήσω πρωτογενή αποτελέσματα αλλά δεν νομίζω πως είναι πρακτικά χρήσιμα στον περισσότερο κόσμο. Τι εννοώ, το σημερινό Fable 5.2 έκανε την απόδειξη του τελευταίου θεωρήματος του Fermat. Wow, καταπληκτικό, αλλά αυτό έγινε με 1000 agents να δουλεύουν επί 30 ώρες. Αντίστοιχα να ξέρετε και για το cybersecurity. Τα βασικά sweeps που βάζουμε να κάνουν τα μοντέλα με τυπικό κόστος, δεν έχουν σχέση με τις δυνατότητες τους οι οποίες για να φτάσουν στο επίπεδο που διαφημίζεται, απαιτούν πολλές ώρες αυτόνομης δουλειάς πολλών agent ταυτόχρονα με κόστος τετραψήφια-πενταψήφια νούμερα.

View attachment 280968


Για τον grok δεν έχω άποψη, είναι πολύ πίσω. Η Meta φαίνεται να έβγαλε καλά μοντέλα αλλά δεν έχει εργαλεία να τα δουλέψεις.
Για καθημερινα προβλήματα πχ πως βάφεται ένας τοίχος κτλ;
 
Για το μέσο χρήστη σήμερα η καλύτερη λύση είναι η 20δόλαρη συνδρομή του Claude.
H OpenAΙ είναι τουλάχιστον 1 γενιά πίσω. Βέβαια αυτό δεν σημαίνει ότι για τα περισσότερα τασκ αυτό δεν είναι αρκετό.

Αν έχεις μικρομεσαία επιχείρηση και θέλεις και ένα τυπικό επίπεδο ασφάλειας και GDPR πας σε Business Copilot που από όταν πήρε το Sol 6.1 είναι μια χαρά για τα περισσότερα. Στο Excel έχει και μοντέλα της Anthropic.

Gemini θα πρότεινα μόνο σε κάποιον που χρησιμοποιεί ενεργά το πλήρες οικοσύστημα της google. Έχω την Plus συνδρομή λόγω του cloud space που πληρώνω και το χρησιμοποιώ ελάχιστα γιατί το Flash 3.8 ακόμη και στο High Thinking κάνει πολλές κοτσάνες που το Sol 6.1 δεν κάνει. Είναι αστείο, αλλά νομίζω ότι με όλη τη δουλειά που έχω κάνει στο harness στο local μοντέλο που έχω, το εμπιστεύομαι περισσότερο απο το Gemini 3.8 Flash (το local τρέχει το Qwen3.8 Flash Next).

Προσωπικά συνεχίζω με την OpenAI για τον απλό λόγο ότι δεν θέλω να αλλάξω οικοσύστημα. Έχω μάθει τα χούγια της, λατρεύω το CODEX και με την Pro 100 συνδρομή ακόμη και αν κάνω όλα τα επαγγελματικά στο Astra (που είναι overkill) δεν βγαίνω εκτός ορίων.
 
  • Like
Reactions: speedman_27
Gemini 4 Hydrogen

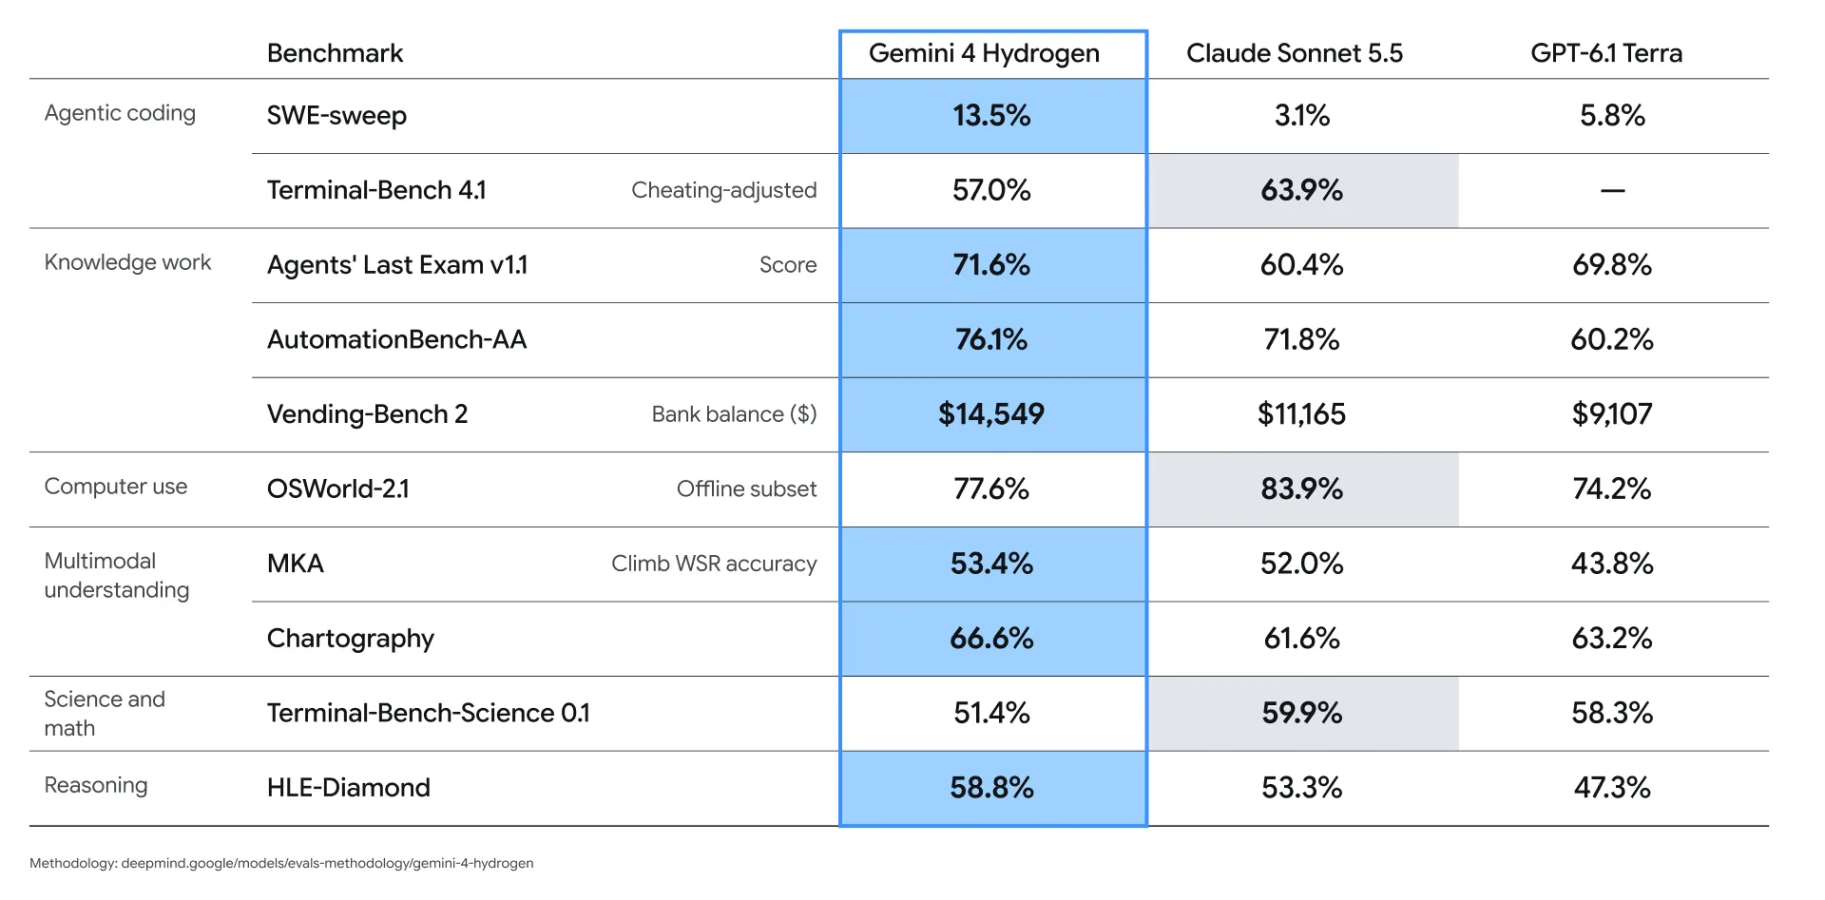
Κυκλοφόρησε το Gemini 4 Hydrogen, για τον περισσότερο κόσμο το σημαντικότερο μοντέλο της Google, εφόσον αυτό είναι διαθέσιμο σε όλους. Είτε χρησιμοποιούν το ai mode του Google Search είτε το Gemini.

1794507331343.png

1794507342435.png

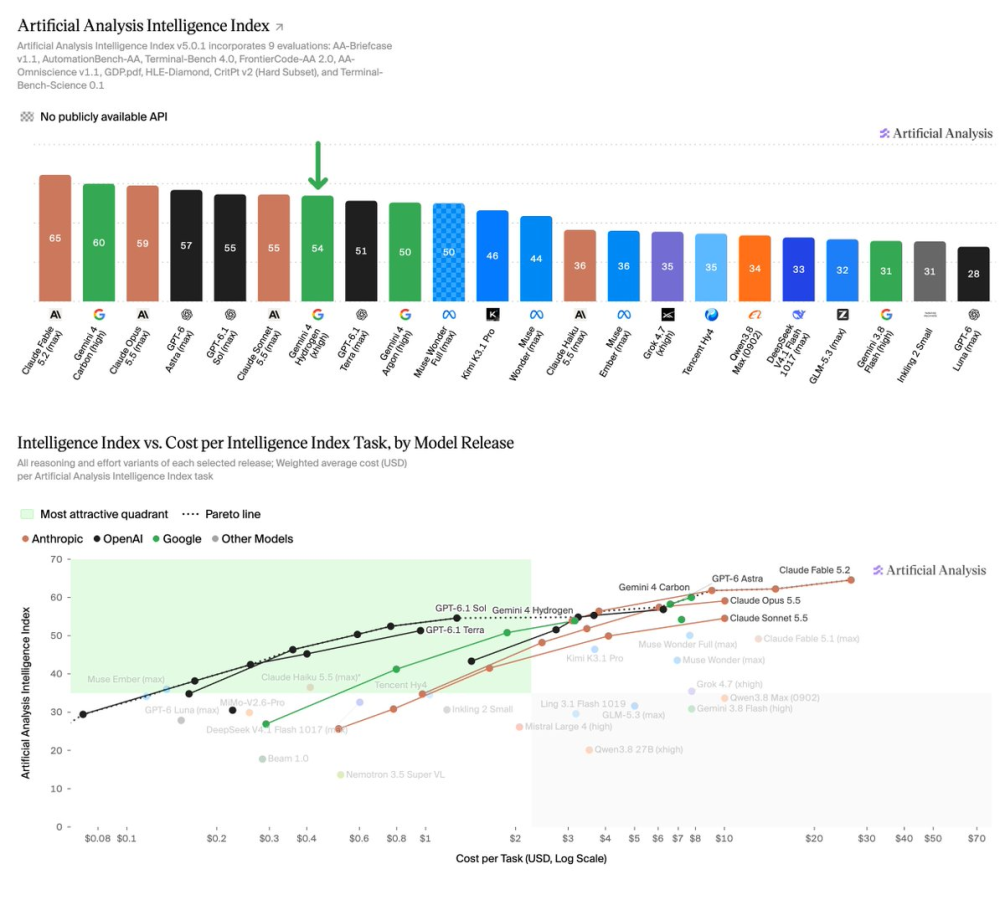
Google's new Gemini 4 Hydrogen has Intelligence just below Claude Sonnet 5.5 and GPT-6.1 Sol, at a third of Sonnet’s cost but ~2.5x that of GPT-6.1 Sol
@GoogleDeepMind
has released their third new model in six weeks. Gemini 4 Hydrogen introduces an xhigh reasoning level and scores 54 on the Artificial Analysis Intelligence Index, with strengths in visual reasoning and non-hallucination. This places it 1 point behind Claude Sonnet 5.5 (max) and GPT-6.1 Sol (max), at ~32% of Sonnet’s cost but ~2.5x that of GPT-6.1 Sol. With high reasoning, Gemini 4 Hydrogen matches the Intelligence of Gemini 4 Argon for ~19% of the Cost per Task

Key takeaways:
➤ The new xhigh reasoning level scores 54 on the Intelligence Index: xhigh is the first reasoning level above high on a Gemini model, and puts Hydrogen 1 point below Claude Sonnet 5.5 (max) and GPT-6.1 Sol (max), and 4 points ahead of Gemini 4 Argon (high). With default (high) reasoning, Gemini 4 Hydrogen scores 51, just behind GPT-6.1 Sol (xhigh, 52) and Claude Opus 5.5 (high, 52)
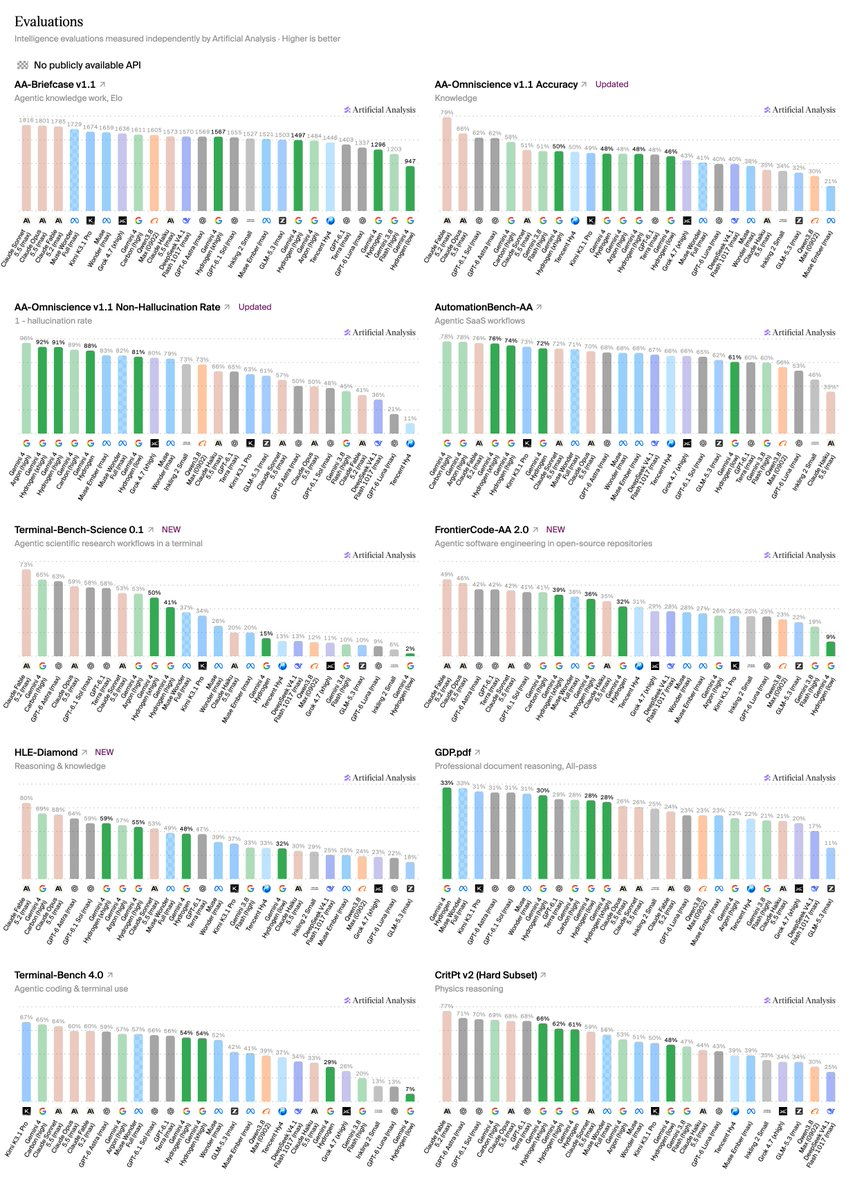
➤ Strong visual reasoning, presentation and non-hallucination: On GDP.pdf, a visual reasoning benchmark over long documents, it scores 33% all-pass on medium reasoning, the tied #1 score on the benchmark. On AA-Omniscience, Hydrogen has one of the lowest hallucination rates recorded at 8%, compared with 43% for Claude Sonnet 5.5 (max) and 52% for GPT-6.1 Sol (max). On AA-Briefcase, our agentic knowledge work evaluation, graders rate Hydrogen's presentation above other Gemini models, including Carbon
➤ Weaker on agentic terminal work: Hydrogen scores 54% on Terminal-Bench 4.0 and 50% on Terminal-Bench-Science 0.1, covering agentic coding and scientific research workflows in the terminal. Claude Sonnet 5.5 (max) scores 64% and 53%, and GPT-6.1 Sol (max) scores 56% and 58%. xhigh reasoning helps on the science tasks, lifting Terminal-Bench-Science from 41% at high to 50%, but makes no difference on Terminal-Bench 4.0 (54% at both). Science scores are even across domains, from 46% in earth sciences to 53% in physical sciences
➤ Low cost for its intelligence, with high token use at xhigh: Hydrogen is priced at $1.50/$7.50 per million input/output tokens. At xhigh it costs ~32% as much per task as Claude Sonnet 5.5 (max) for near-equal intelligence, but ~2.5x as much as GPT-6.1 Sol (max). xhigh nearly doubles output tokens compared with high for a 3 point gain in Intelligence, and Cost per Task falls from $3.16 at xhigh to $1.87 at high. Medium ($0.80) and low ($0.29) cost less again, but score 41 and 27 on the Intelligence Index
➤ On the Time per Task vs. Intelligence Pareto frontier: Gemini 4 Hydrogen has an output speed of ~200 output tokens per second. With high, medium, and low reasoning effort, Gemini 4 Hydrogen is on the Time per Task vs. Intelligence Pareto frontier, meaning no models are both more intelligent and have a lower Time per Task

Τα πλήρη Benchmarks