Δεν απαντάται σε μια γραμμή αυτό.
Για τον μέσο άνθρωπο που θέλει καλά αποτελέσματα σε διάφορα tasks, αυτή τη στιγμή η καλύτερη επιλογή είναι να πάρει την 20ευρη συνδρομή του Claude, να χρησιμοποιεί το τελευταίο μοντέλο Opus και το αποτέλεσμα που θα παίρνει είναι κοντά στο κορυφαίο διαθέσιμο και με αρκετή διαθέσιμη χρήση στη συνδρομή.
Το οικοσύστημα είναι το πιο πλήρες, έχει extensions σε office, πολύ δυνατό browser use, είναι αυτή τη στιγμή η καλύτερη εμπειρία.
Τώρα για τους υπόλοιπους που είμαστε κάπως power users και nerds.
Για προγραμματισμό, πάλι, τα μοντέλα της Anthropic είναι τα καλύτερα αυτή τη στιγμή. Τον κύριο όγκο δουλειάς εάν θέλεις να τον κάνεις με φυσιολογικό κόστος θα τον κάνει το εκάστοτε Opus ή το αντίστοιχο της OpenAI επίπεδο μοντέλου, το Sol. Αυτή τη στιγμή, το Opus είναι πολύ καλύτερο σε σχέση με το διαθέσιμο Sol, οπότε δεν υπάρχει σύγκριση εκεί. Το Astra είναι μια χαρά μοντέλο, δεν του λείπει κάτι, αλλά λόγω κόστους δεν μπορεί να είναι το βασικό μοντέλο που χρησιμοποιεί κανείς. Fable/Mythos είναι στη κορυφή σήμερα, πραγματικά μοναδικά σε αυτό που κάνουν, επίσης με υψηλό κόστος, εάν έχεις απεριόριστη χρήση API μέσω της εταιρίας για παράδειγμα, φυσικά χρησιμοποιείς αυτό.
Επειδή δεν μπορείς να κάνεις βαριά χρήση των καλών μοντέλων σε επίπεδο chat και να τρέχουν και projects, εγώ προσωπικά χρησιμοποιώ για ότι μικρό θέλω να ρωτήσω, τη συνδρομή του Gemini Enterprise. Νομίζω πληρώνουμε περίπου ~30 ευρώ/μήνα/θέση και περιλαμβάνει πρακτικά απεριόριστη χρήση στο βασικό chat. Το Gemini 4 Carbon στα μικρά tasks είναι εξαιρετικό, επίσης γράφει τα καλύτερα Ελληνικά μεταξύ των διαφόρων επιλογών (και το καινούριο Fable είναι κοντά).
Για την ίδια χρήση, εάν κάποιος έχει από τη δουλειά του το premium 365 copilot, που έχει διαθέσιμο το 6.1 Sol, μια χαρά αποτέλεσμα θα πάρει και από αυτό στα περισσότερα tasks. Ούτε και εκεί κατάφερα να τερματίσω τη χρήση του.
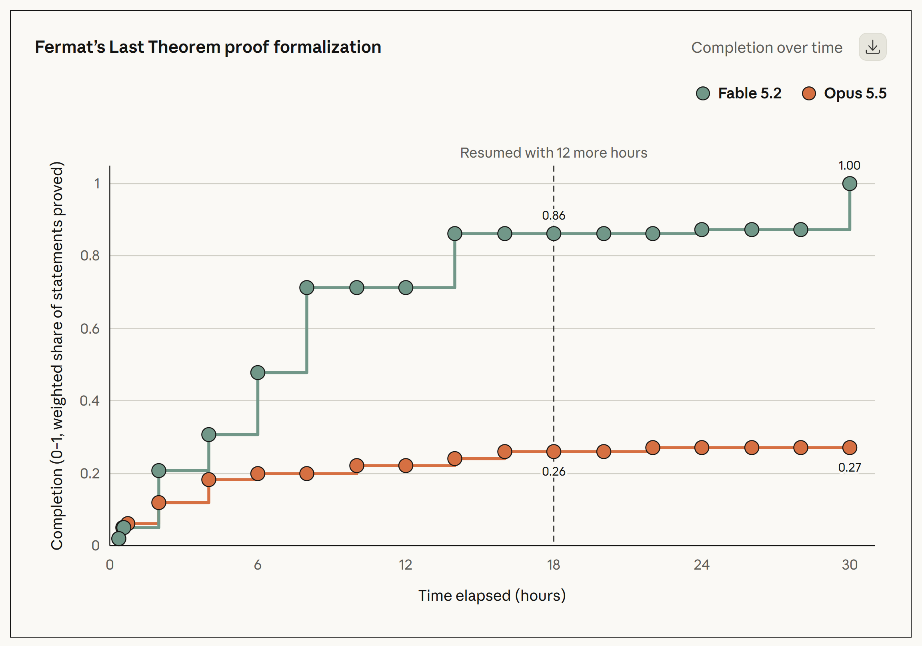
Όσον αφορά την επιστημονική έρευνα, δεν είμαι σε θέση να αξιολογήσω πρωτογενή αποτελέσματα αλλά δεν νομίζω πως είναι πρακτικά χρήσιμα στον περισσότερο κόσμο. Τι εννοώ, το σημερινό Fable 5.2 έκανε την απόδειξη του τελευταίου θεωρήματος του Fermat. Wow, καταπληκτικό, αλλά αυτό έγινε με 1000 agents να δουλεύουν επί 30 ώρες. Αντίστοιχα να ξέρετε και για το cybersecurity. Τα βασικά sweeps που βάζουμε να κάνουν τα μοντέλα με τυπικό κόστος, δεν έχουν σχέση με τις δυνατότητες τους οι οποίες για να φτάσουν στο επίπεδο που διαφημίζεται, απαιτούν πολλές ώρες αυτόνομης δουλειάς πολλών agent ταυτόχρονα με κόστος τετραψήφια-πενταψήφια νούμερα.
View attachment 280968
Για τον grok δεν έχω άποψη, είναι πολύ πίσω. Η Meta φαίνεται να έβγαλε καλά μοντέλα αλλά δεν έχει εργαλεία να τα δουλέψεις.