Τεχνητή Νοημοσύνη (AI). Τι είναι, τι ξέρουμε, τι αλλάζει στη ζωή και στον πολιτισμό;

Βγήκε το GPT 6.1 Terra

Να είμαι ειλικρινής δεν έχω πειστεί γιατί χρειάζεται αυτό το μοντέλο. Ούτε στο 5.6 πήγε καταπληκτικά από εμπορικής άποψης, δεν βλέπω γιατί αυτό θα αλλάξει τώρα.
Το Sol είναι αρκετά οικονομικό και efficient, καλύτερα να χρησιμοποιεί κανείς εκείνο.
1793039805713.png

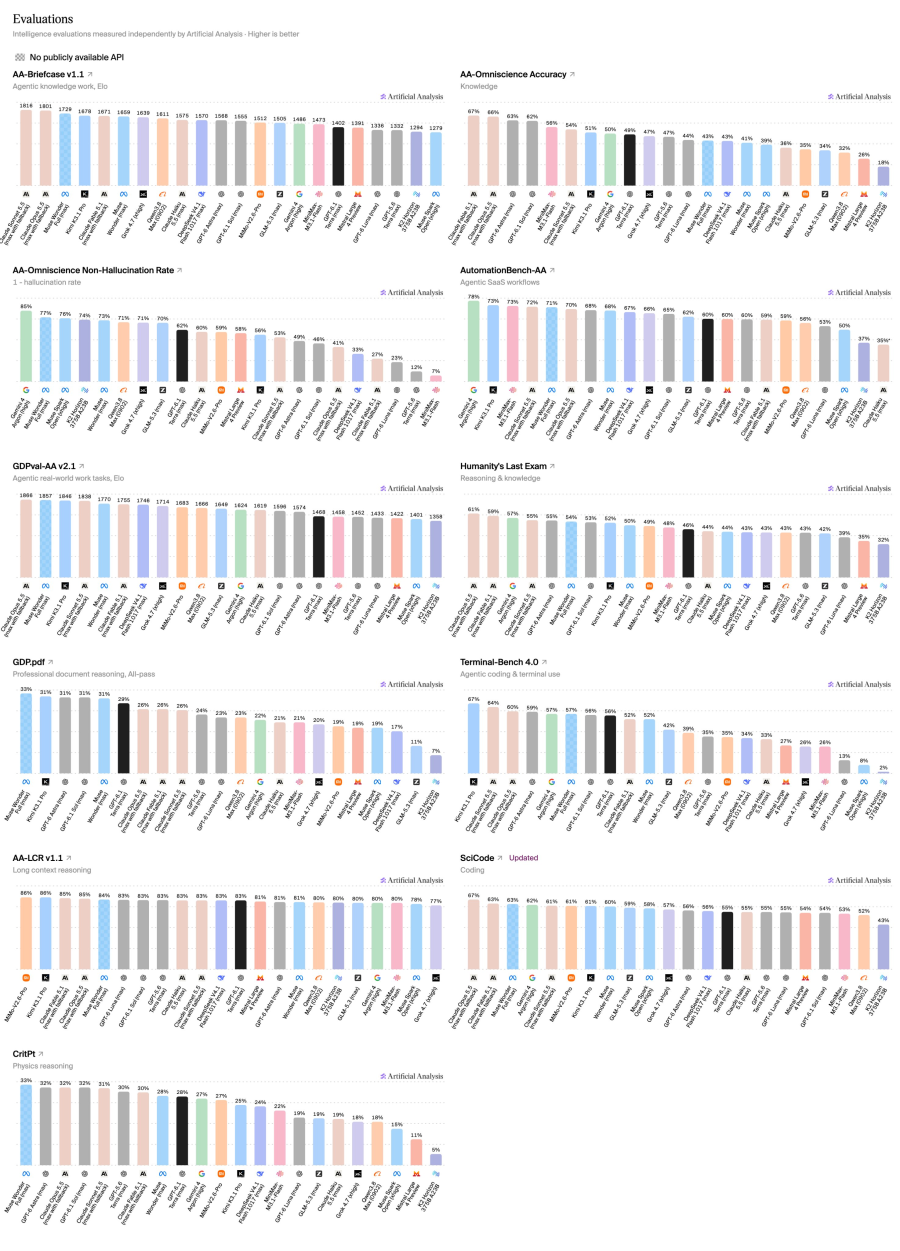
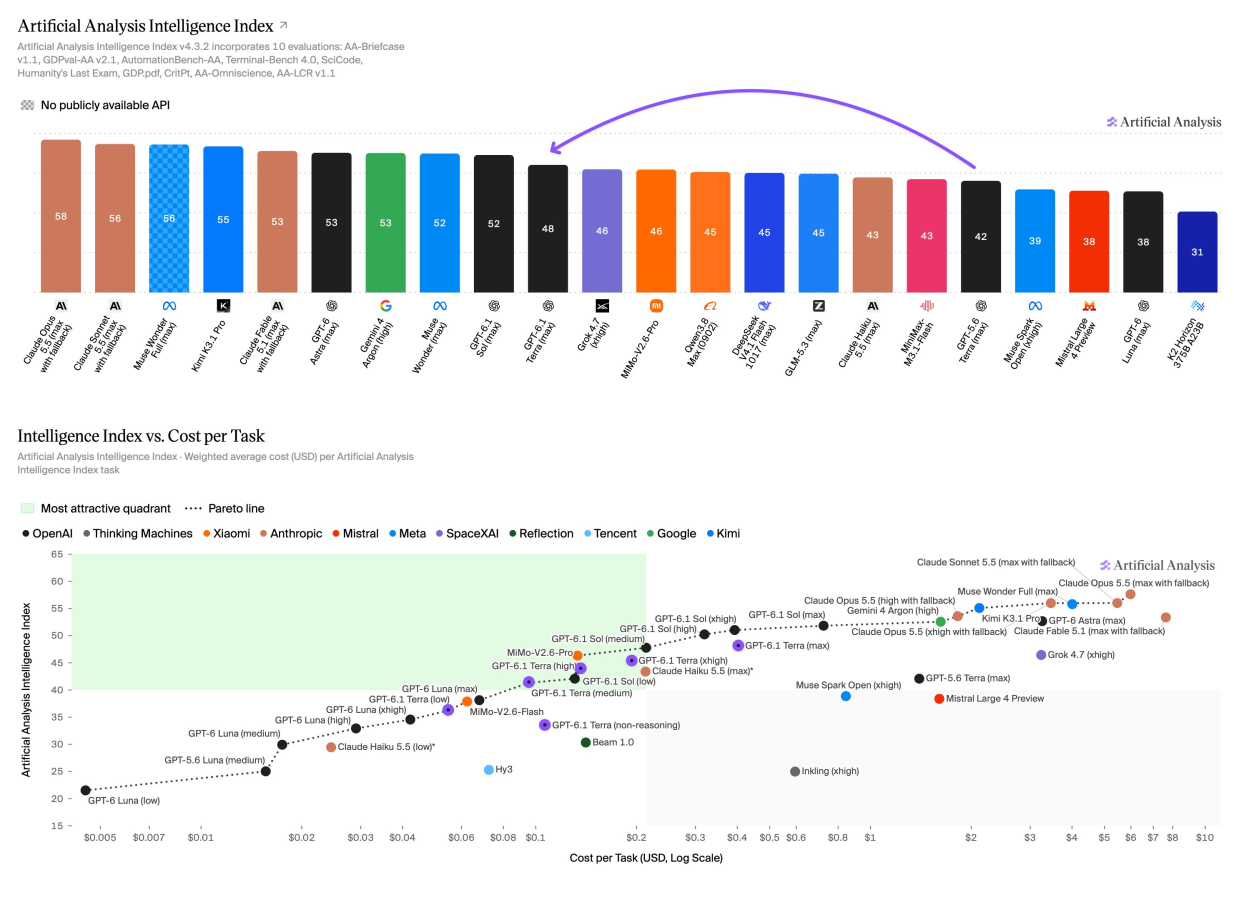
OpenAI has released GPT-6.1 Terra, pushing the cost efficiency frontier. It is the first Terra-class model since GPT-5.6, and is more intelligent for less than a third of the costPricing per token is half or less that of GPT-5.6 Terra - at $1/$5 per million input/output tokens vs $2/$12 for the previous model. Cache write has also halved, now at $1.25 per million tokens. Cached input is one quarter at $0.05 vs $0.20 per million tokens.Key takeaways:
➤ Pareto-optimal for Intelligence vs Cost at low and medium effort: At max effort, GPT-6.1 Terra gains 6 points in the Artificial Analysis Intelligence Index over GPT-5.6 Terra, at less than a third of the cost per task ($0.40 vs $1.40). At lower effort levels the gain is larger, between 7 and 13 points. The low and medium effort levels are Pareto-optimal for cost efficiency, while the other effort levels sit behind the frontier. At max effort, the model scores 4 points below GPT-6.1 Sol and 10 points above GPT-6 Luna in the Intelligence Index.
➤ Pushes the Coding Agent Index cost efficiency frontier: With a score of 48 in the newly released Artificial Analysis Coding Agent Index v2.0, the model is 6 points below GPT-6.1 Sol (54) and 17 points above GPT-6 Luna (31). The xhigh and low effort settings sit on the frontier of cost efficiency in the Coding Agent Index, while other effort levels are behind the frontier.
➤ 50 point drop in hallucination rate: GPT-6.1 Terra guesses 38% of the time when it does not know the answer to a question in AA-Omniscience, our private knowledge and hallucination benchmark. Previously, GPT-5.6 Terra's hallucination rate was 88%. This significant reduction in hallucination is coupled with a 2 point increase in AA-Omniscience accuracy - meaning the model simultaneously answers more questions correctly.
➤ 20 point jump in Terminal-Bench 4.0, small improvements across most evaluations: The model makes significant progress in the terminal-based agentic benchmark, Terminal-Bench 4.0, with a gain of ~20 points, now rivaling GPT-6.1 Sol at max effort. Gains across most other evaluations are smaller, for example, 5 points in GDP.pdf.

Όλα τα Benchmarks:


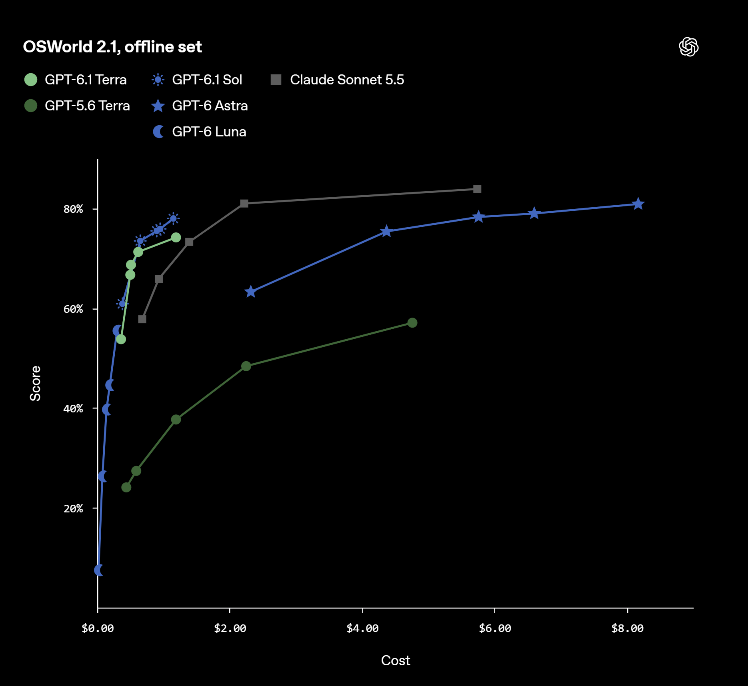
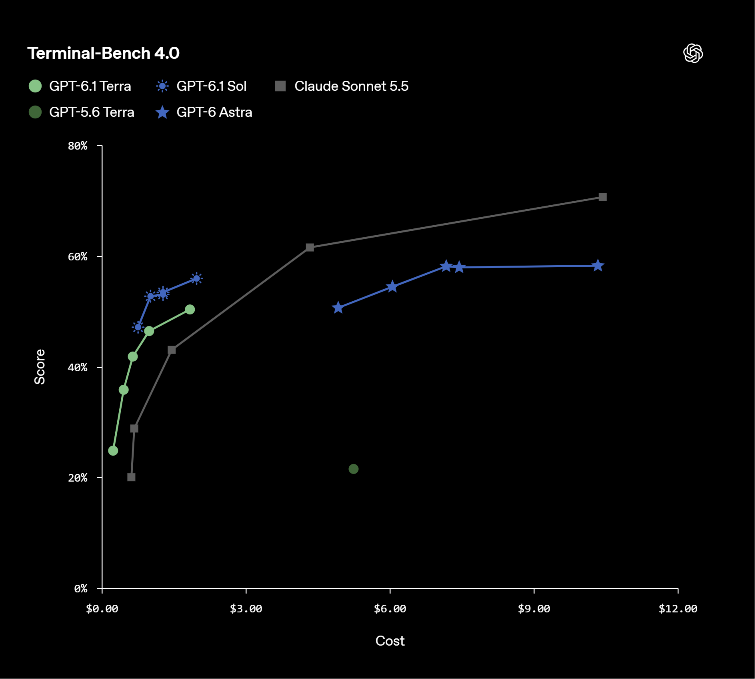
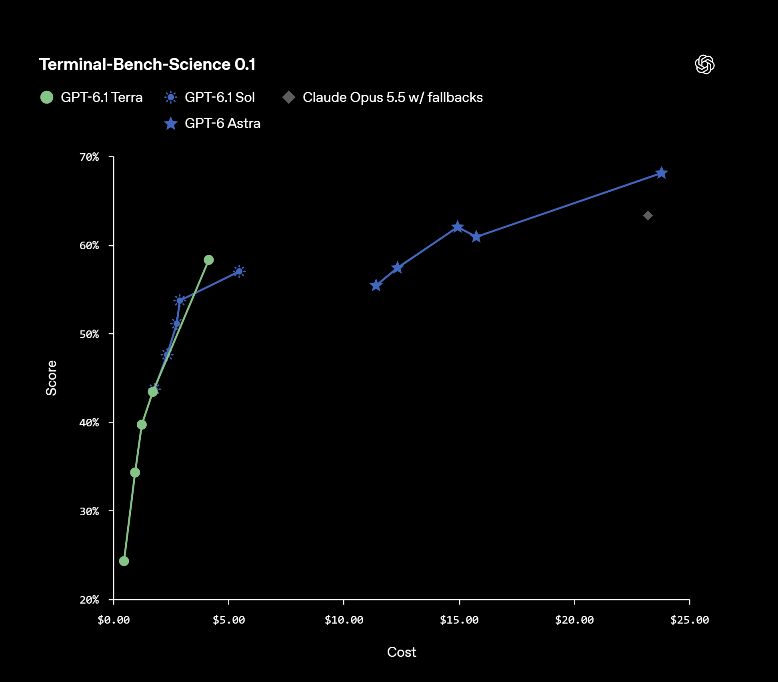
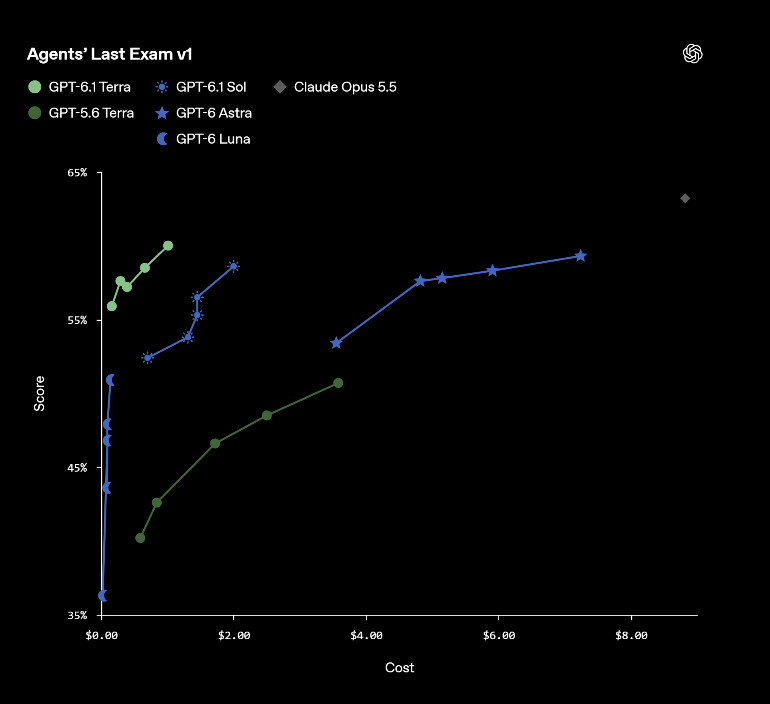
Τα benchmarks της OpenAI:
1793040228984.png 1793040244954.png

1793040265886.png 1793040285940.png
 
Όντως το terra είναι περίεργο μοντέλο. Αν πας στο luna έχεις τουλάχιστον σχεδόν μηδενικό κόστος. Θα είχε νόημα αν υπήρχε μόνο εξελιγμένος router και υπήρχαν gains σε διαχείριση workload σε data center.
Πάντως το Luna σε Max Thinking μέσω codex με Browser plugin ενεργοποιημένο δουλεύει μια χαρά για να ψάχνει πραγματικά ξενοδοχεία / αεροπορικά εισιτήρια μέσω γνωστών πλατφορμών κάτι που πρακτικά δεν δουλεύει καλά μέσω των κλασσικών interfaces χωρις να ξοδεύεις usage από Sol/Astra.
 
Last edited:
Καλό είναι αλλά όχι αυτό που περίμενα.
Πρόκειται επί της ουσίας για ένα business assistant, όχι personal assistant.

Αρχικά, για να γίνει δουλειά, το συνέδεσα με το εταιρικό μου email, ημερολόγιο και αρχεία.
Σήμερα έπιασε κάποια στιγμή ένα ticket που ήμουν CCd στο Google Cloud. Ρώτησε εάν θέλω να βοηθήσει και από περιέργεια του απάντησα ναι, διάβασε τις συνομιλίες, πρότεινε ένα σετ από 9 ερωτήσεις αφού τσέκαρε τα αρχεία της υποδομής -οι οποίες όντως είχαν νόημα, διάβασε τα terms της σύμβασης υποστήριξης που έχουμε και έκανε και ένα draft στην ομάδα των dedicated technical advisors μας.

Θα το έβαζα να τα τρέξει; Όχι, αλλά επειδή ο owner του ticket έχει εις βάθος γνώση του προϊόντος και των υλοποιήσεων, ήξερε τι ρώτησε στοχευμένα και έχει εμπειρία σχετικά με το πότε μιλάς με τους technical advisors και πότε με το support. Σε περίπτωση που δεν είσαι σε enterprise επίπεδο εταιρίας τεχνολογίας και πρόκειται για μια εταιρία με το μέσο επίπεδο IT, αυτά που ρώτησε και ο τρόπος που το προσέγγισε, είναι σαφώς ανώτερα από το τι θα έκανε ο IT.

Άλλη περίπτωση, μου ήρθαν στο SAP ενημερώσεις για αποδοχή κάποιων PO (purchase orders). Πάλι ρώτησε εάν θέλω να κάνει ένα cross check. Βρήκε στο αρχείο τα RFQs, τις απαντήσεις από τους vendors, συνέκρινε τις προτάσεις, σωστά έγραψε ότι έγραψε αλλά η δουλειά είχε ήδη γίνει, expert ήταν αυτός που έβαλε το PO και τα είχε ήδη δεί.

Επειδή κάπου εκεί κατάλαβα πως σε τέτοια tasks δεν μας χρειάζεται, το έβαλα να ανανεώσει ένα API guide που έχουμε. Διάβασε την αλληλογραφία, δες τα αρχεία και το documentation, βασίσου στο προηγούμενο api guide, το repository είναι εκεί, προσέθεσε και ορισμένα παραδείγματα που θα βοηθήσουν τους integrators και τέσταρε τα σε dev server ώστε να βεβαιωθείς πως δουλεύουν.

Αυτό το έκανε άριστα. Το ερώτημα είναι, δεν θα το έκαναν και τα projects; Θα το έκαναν. Η διαφορά είναι πως μιλάς σε έναν assistant που δεν χρειάζεται να του ορίσεις workspace, πάει και καλεί όποια λειτουργία και εργαλείο χρειάζεται κάθε φορά και απλά γίνεται αυτό που ζητάς.

Και κάτι ακόμη, βρήκε κάποια interactions με emails που είχα, ήταν προγραμματισμένα meetings που δεν είχα περάσει στο ημερολόγιο μου. Προσφέρθηκε να τα περάσει, μια χαρά λειτουργεί αυτό.

Τι δεν κάνει τώρα.
Του ζήτησα να μου ψάξει 2-3 προϊόντα σε όλα τα Ευρωπαϊκά amazon, να βρεί τις τιμές και διαθεσιμότητα. Έχει μπλοκαρισμένη πρόσβαση, έκανε google searches, πραγματικά αποτελέσματα δεν γύρισε.
Του ζήτησα να μου αγοράσει ένα μπλε σκούρο φούτερ από την alo, άνοιξε εκεί κάτι σαν browser, αλλά δεν έχει πρόσβαση στο pc σου, τρέχει αποκλειστικά σε VM. Δεν μπορεί να κάνει end to end συναλλαγές όπως δυνητικά θα μπορούσε η κανονική εφαρμογή.
Σε επαγγελματικό περιβάλλον και εφόσον η εταιρία μου μου είχε δώσει πρόσβαση προφανώς θα τον ενεργοποιούσα, είτε αυτόν, είτε τον copilot scout είτε κάποιο DOT από OpenAI. Αλήθεια, έχεις χρησιμοποιήσει για να συγκρίνεις κάποιον από τους άλλους;

Στη δική μου περίπτωση που πρακτικά δουλεύω μόνος, έχω ακόμη κολλήματα να δώσω πλήρες access σε email / calendars / αρχεία στο σκληρό (αν και όλα τα αρχεία είναι σε Business Onedrive) σε κάποιον agent.
Προς το παρόν ότι μου έρχεται στο μυαλό ότι χρειάζομαι το υλοποιώ τοπικά. Βέβαια τίποτα δεν είναι proactive σε αυτή τη φάση. Όλα τα task είναι συγκεκριμένα και προκαθορισμένα και μόνο με read-only attributes σε mail/calendar. Άσε που όπου μπορώ δεν βάζω ΑΙ στη μέση αλλά φτιάχνω παραδοσιακό λογισμικό να το υλοποιήσει.
 
Έχουμε connectors με το 365 στο Gemini Enterprise και το Claude.
Στο Claude, επειδή εδώ και καιρό οι agents έχουν έναν αυτόματο classifier, για να κάνει οτιδήποτε "επικίνδυνο", όπως να διαγράψει ένα αρχείο, χρειάζεται τη ρητή σου εντολή. Τέτοια θέματα δεν είχαμε ποτέ. Αυτό που στο εταιρικό Enteprise έχουμε κλειδωμένο είναι τα Fable/Mythos για χρήση εκτός Claude Code εφόσον δεν έχουν ZDR (Zero data retention). Έπεσε το μάτι μου σε μια επικοινωνία για το πως θα διορθωθεί και αυτό αλλά νομίζω η λύση δεν είναι ακόμα σε production.

Εάν δουλεύεις μόνος, όλο αυτό έχει πολύ μεγαλύτερο value.

Αλήθεια, έχεις χρησιμοποιήσει για να συγκρίνεις κάποιον από τους άλλους;

Το Gemini Spark έχω χρησιμοποιήσει μόνο, αλλά όχι για δουλειά.
Στη δουλειά, για αυτά που εγώ χρειάζομαι AI, θεωρώ πως τα projects του claude είναι ο ιδανικός τρόπος να δουλεύεις. Μιλάς με τον coordinator και κάνει ότι χρειάζεται σε sessions μόνος του.

Το Duet το χρησιμοποίησα σήμερα για παράδειγμα, να μου βάλει 2 meeting στο calendar. Του το έκανα dictate φωνητικά, εάν το έγραφα, ίδιο χρόνο θα μου έπαιρνε να το κάνω εγώ.
 
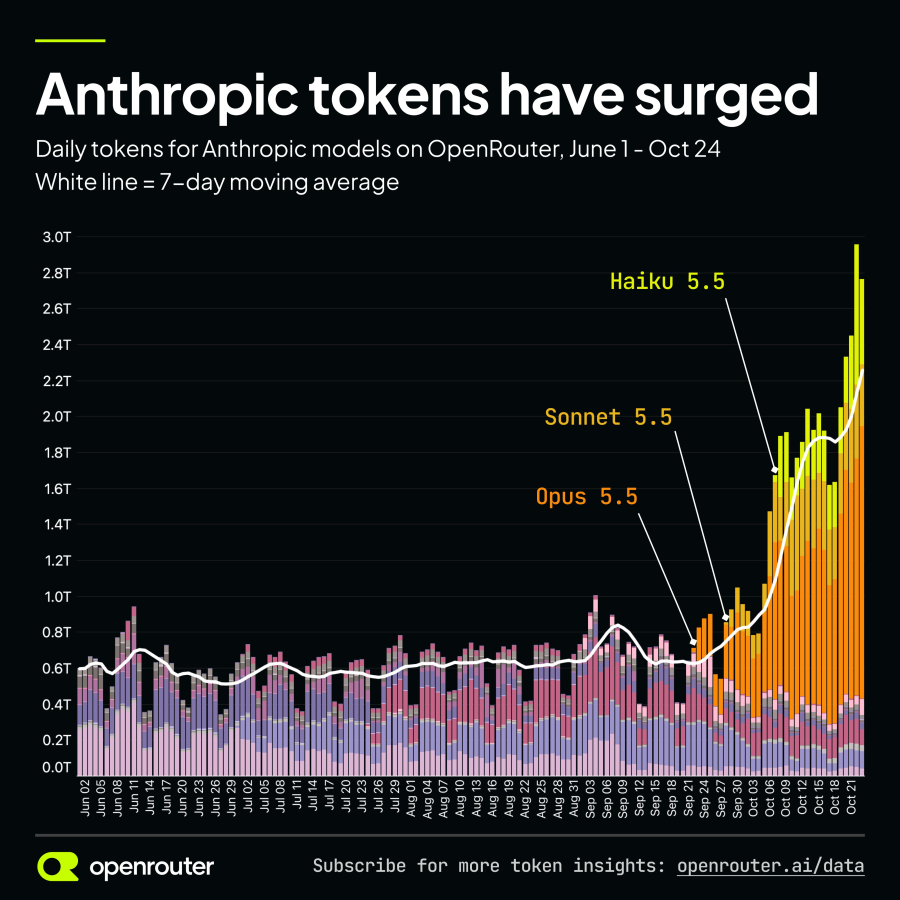
Η Anthropic κατέθεσε το S1 που είναι ένα από τα βήματα πριν το ΙΡΟ.

Αυτό που έκανε εντύπωση είναι ότι γράφουν:
" ...Each version of a Claude model assists in building the next, helping to compress development timelines and produce compounding improvements in the speed at which we innovate. We refer to this recursive dynamic as “closing the loop,” and we believe it is one of the most significant structural advantages in frontier AI..."

Αυτό όμως είναι αυτό ακριβώς που ο Αμαντέι έχει πει ότι είναι ο μεγαλύτερος κίνδυνος από το ΑΙ και έχει ζητήσει να περιοριστεί/ρυθμιστεί. Στην πράξη όμως λένε ότι έχουν πατήσει το κουμπί και προχωράνε. Do as I say don't do as I do...
 
Ότι και να λένε, όποιος και να το λέει, ζούμε υπερ-μαραθώνιο. Ούτε η Google κρατάει κρυφό πως είμαστε στο RSI.
Το προϊόν είναι το μοντέλο και όσο αυτά είναι μπροστά, έχεις πελάτες, έχεις έσοδα, έχεις εταιρία εν τέλει.

1793093420068.png
 
Περάσαμε και στο πεδίο της φυσικής μετά τα μαθηματικά.
Στις 26 Οκτωβρίου 2026, η OpenAI ανακοίνωσε τρεις νέες εντυπωσιακές επιστημονικές ανακαλύψεις:
  • Μαθηματικά: Μια νέα απόδειξη που φέρεται να επιλύει σημαντικές εικασίες δεκαετιών, μεταξύ των οποίων και η περίφημη εικασία Kakeya.
  • Πληροφορική: Την ανατροπή της Υπόθεσης Εκθετικού Χρόνου (ETH), μιας θεμελιώδους παραδοχής για τη δυσκολία επίλυσης ορισμένων υπολογιστικών προβλημάτων.
  • Θεωρητική Φυσική: Μαθηματικές αποδείξεις για την ύπαρξη κβαντικών θεωριών πεδίου, συμπεριλαμβανομένης της κβαντικής χρωμοδυναμικής, που περιγράφει την ισχυρή πυρηνική αλληλεπίδραση.
Η λέξη εντυπωσιακό δεν μπορεί να μεταδώσει αυτό που βιώνουμε...
 
Σήμερα μου πέταξε δωρεάν τρεις μήνες Gemini AI pro μια προσφορά από την asus .

Την έβαλα για να δοκιμάσω από περιέργεια το Antigravity με Gemini 4 Argon .

Στα 23€ το μήνα δίνει πολλά bonus όπως τον αποθηκευτικό χώρο, την προσβαση και το integration που κάνει σε όλα τα εργαλεία της Google .

Δεν ξέρω πόσο πίσω ειναι από τα καλά μοντέλα της OpenAI, Anthropic ακόμη και της Meta. Αλλά αυτό που μου έβγαλε ως αποτέλεσμα με προβλημάτισε.

Πάντα όταν δοκιμάζω ένα νέο μοντέλο του δίνω έναν κώδικα που έχει γνωστά bug που τα έχω διορθώσει για να δω αν θα τα βρει και πως θα προτείνει λύση. Φυσικά επειδή είναι κώδικας που αφορά εργαλείο η αποτελεσματικότητα δοκιμάζεται σε πραγματικές συνθήκες.

Λοιπόν... Βρήκε περισσότερα από αυτά που είχε βρει το sol 5.6 . Έδωσε διαφορετικές λύσεις που στην πράξη με άφησαν άφωνο και διόρθωσε ένα πρόβλημα που με βασάνιζε 6 μήνες...

Οπότε εδώ έρχεται ένα ερώτημα.
Δεν έχουν όλα τα μοντέλα μια βάση με το πως πρέπει να είναι η γραφή κώδικα; Οπως την μαθαίνει ένας προγραμματιστης απο τα βιβλια; Γιατί πραγματικά είναι σαν δύο διαφορετικοί προγραμματιστες με διαφορετική προσέγγιση. Εμένα αυτό με μπερδεύει γιατί ακόμη και με το GLM 5.3 είδα παρόμοια προσέγγιση με το Chagpt . Εδώ ειναι κάτι άλλο...
Δεν έχω εμπειρία από Claude για να δω αν μοιάζει με αυτό.
 
Η Google στη κορυφή και πάλι.
Κυκλοφόρησαν το Gemini 4 Carbon

Βέβαια κατά τον τυπικό τρόπο κυκλοφορίας τους, δεν είναι δημόσια διαθέσιμο.
Εντυπωσιακό πως το κυκλοφόρησαν στην ίδια τιμή με το Argon.

1793224887142.png

1793224847192.png

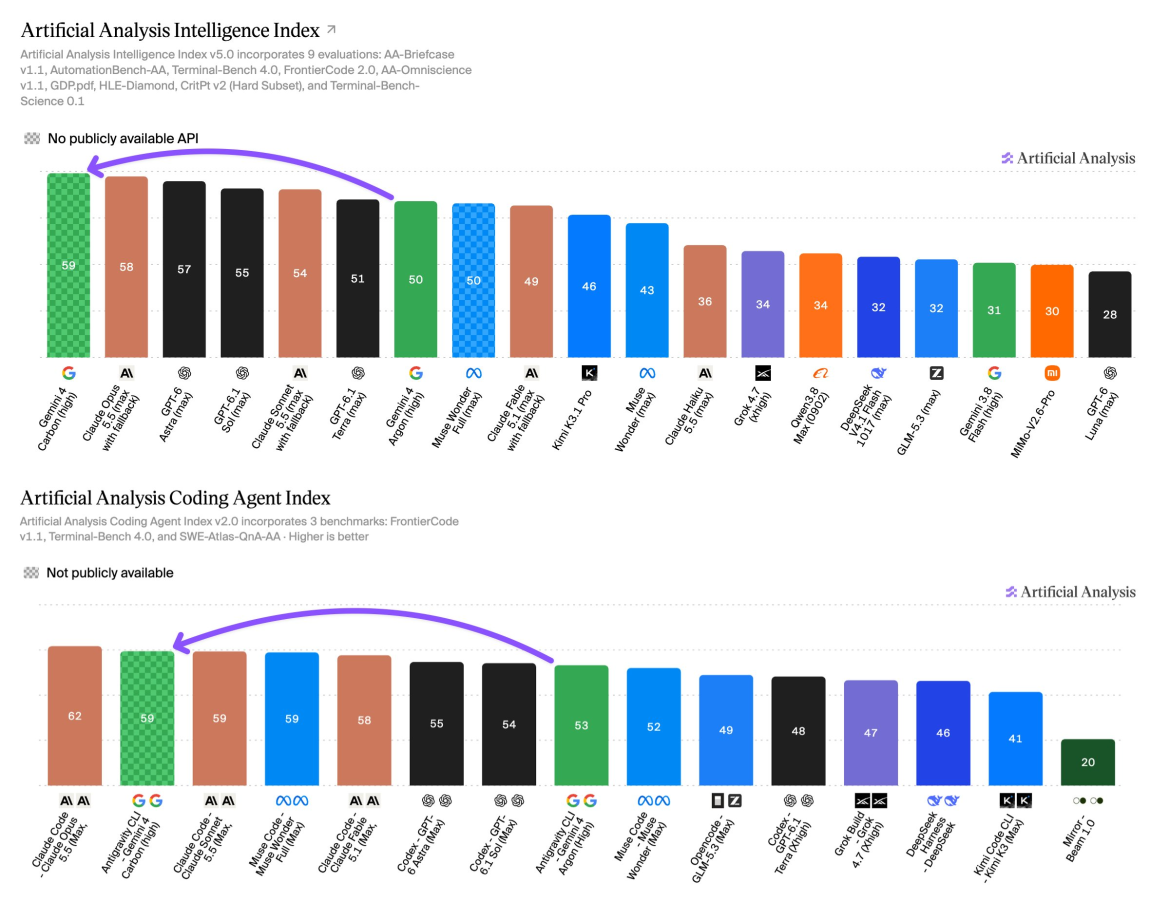
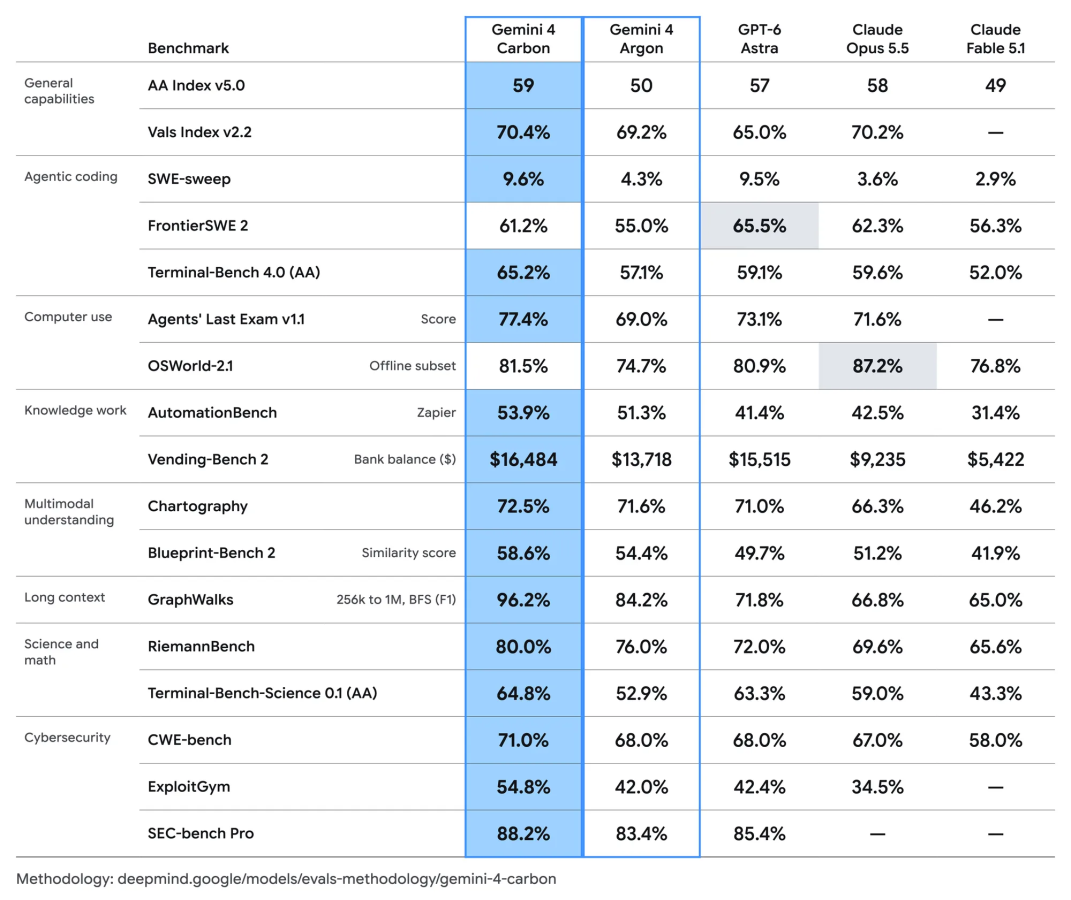
Google’s Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5, and second only to Claude Opus 5.5 on the Artificial Analysis Coding Agent IndexGemini 4 Carbon scores 59 on Intelligence Index v5, driven by leading performance in complex reasoning, knowledge, and scientific tasks. It also has large gains in coding and knowledge work, particularly when compared to other Gemini models, but it is not leading in all these areas.As with launch of Gemini 4 Argon, Gemini 4 Carbon is being rolled out to selected users and is not yet publicly available. Google is offering a 50% launch discount, with no confirmed end date. All our charts and figures use standard pricing for both Gemini 4 Carbon and Argon.Key results for Gemini 4 Carbon with high reasoning:
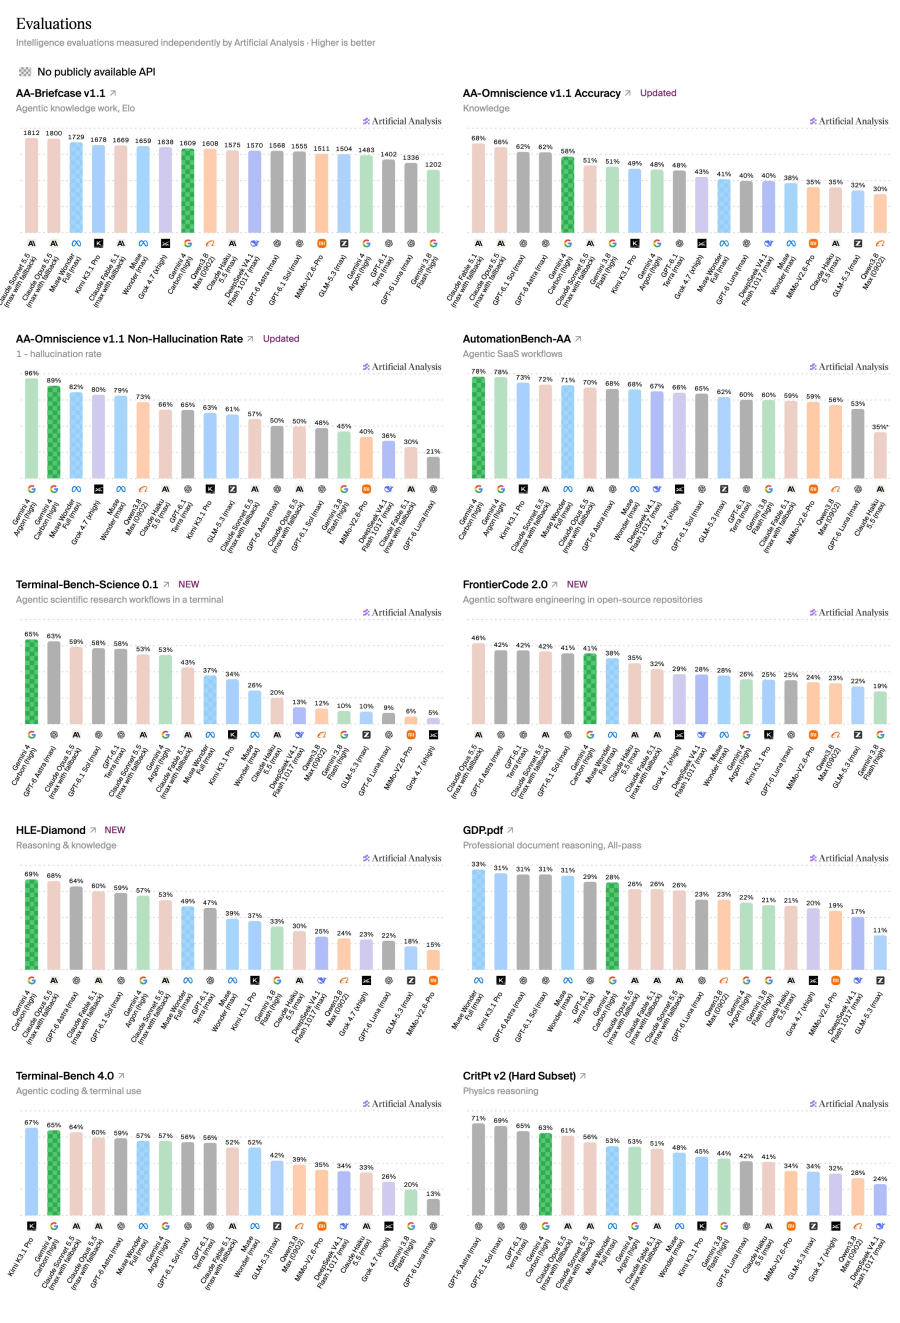
➤ Gemini 4 Carbon leads the Intelligence Index v5, with the #1 score in 4 of the 9 Index evaluations: HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA. Carbon makes substantial gains elsewhere but is not leading in coding and knowledge work
➤ Behind only Claude Opus 5.5 on coding agents: With Antigravity CLI, Gemini 4 Carbon (high) scores 59 only 3 points behind Claude Code with Claude Opus 5.5 (max, 62) on the Artificial Analysis Coding Agent Index. Carbon ranks second on both Terminal-Bench 4.0 (64%) and FrontierCode v1.1 (51%), behind Claude Opus 5.5 (max) at 56%. Google has historically underperformed in this area and so this improvement stands out
➤ Improved agentic knowledge work, but not yet leading: On AA-Briefcase, Gemini 4 Carbon (high) scores 1609 Elo, a 126-point improvement over Gemini 4 Argon (high, 1483), but still behind models including Grok 4.7 (xhigh, 1638), Muse Wonder (max, 1659) and Kimi K3.1 Pro (1678). The largest gain comes from Presentation, up 293 Elo to 1598, alongside a 120-point improvement in Analytical Quality to 1671➤ Lower Cost per Task than Claude Opus 5.5 for comparable overall intelligence: Gemini 4 Carbon costs $7.76 per Intelligence Index task, ~23% less than Claude Opus 5.5 (max, $10.04) but ~1.2x GPT-6 Astra (max, $6.25). It uses 123k output tokens per task, 29% fewer than Claude Opus 5.5 (max, 173k). At the same $4/$20 standard pricing, its Cost per Task is in line with Gemini 4 Argon ($7.68), while scoring 9 points higher on the Intelligence Index
➤ Leading AA-Omniscience v1.1 score, with low hallucination: Gemini 4 Carbon scores 54 on our recently updated AA-Omniscience v1.1, 6 points ahead of Claude Opus 5.5 (max, 48) and 8 points ahead of Gemini 4 Argon (46). Accuracy (% correct) rises 10 points over Argon to 58%, while its hallucination rate rises from 4% to 11%. This is still the second lowest of any model, behind only Argon, compared with 50% for both Claude Opus 5.5 (max) and GPT-6 Astra (max)

Τα πλήρη Benchmarks