Τοπικά / Offline AI: Μοντέλα, Harnesses, Hardware, εγκατάσταση και εφαρμογές

17 June 2006
12,033
Με αφορμή την πρόταση του Δημήτρη στο γενικό νήμα για την Τεχνητή Νοημοσύνη, νομίζω ότι έχει νόημα να ανοίξουμε ένα ξεχωριστό νήμα αποκλειστικά για τα local / offline AI models.

Το βασικό νήμα έχει πλέον εξελιχθεί σε μια πολύ ευρύτερη συζήτηση γύρω από την AI: νέα frontier μοντέλα, δυνατότητες και benchmarks, agents, εξέλιξη των μεγάλων εργαστηρίων, αλλά και τις γενικότερες επιπτώσεις της AI στην εργασία, την κοινωνία και τον πολιτισμό.

Τα local μοντέλα όμως έχουν αρχίσει να αποτελούν από μόνα τους ένα αρκετά μεγάλο και κυρίως πολύ πιο πρακτικό αντικείμενο. Οπότε καλύτερα η σχετική κουβέντα να συγκεντρωθεί εδώ, αντί να χάνεται μέσα στο γενικό νήμα.

Με τον όρο local/offline AI εννοούμε μοντέλα που μπορούμε να τρέξουμε στο δικό μας PC, workstation ή server, χωρίς να χρειάζεται κάθε inference να γίνεται στους servers της OpenAI, της Anthropic, της Google κ.λπ. Το «offline» βέβαια δεν σημαίνει ότι όλες οι εφαρμογές πρέπει αναγκαστικά να είναι αποκομμένες από το Internet, αλλά ότι το βασικό είναι ότι το ίδιο το μοντέλο και τα δεδομένα μας μπορούν να παραμένουν τοπικά.

Εδώ μπορούμε να συζητάμε, μεταξύ άλλων:

  • ποια open/local μοντέλα αξίζουν για διαφορετικές χρήσεις,
  • dense και MoE αρχιτεκτονικές, quantization και διαφορετικά quants,
  • GGUF και άλλα formats,
  • CPU/GPU/NPU inference και απαιτήσεις σε RAM/VRAM,
  • ταχύτητα, context length, tokens/sec και κατανάλωση πόρων,
  • llama.cpp, Ollama, LM Studio και τα υπόλοιπα inference engines/front-ends,
  • πραγματικές συγκρίσεις και benchmarks - όχι μόνο τα επίσημα scores,
  • χρήση local μοντέλων με agents, coding harnesses, RAG, tools κ.λπ.,
  • privacy και επεξεργασία ευαίσθητων ή εμπιστευτικών δεδομένων τοπικά,
  • κόστος και πρακτική σύγκριση με cloud/API μοντέλα,
  • καθώς και hardware builds ειδικά για local AI.
Κυρίως θα είχε ενδιαφέρον να μοιραζόμαστε πραγματική εμπειρία χρήσης. Τα benchmarks είναι χρήσιμα, αλλά δεν λένε πάντα όλη την ιστορία. Ένα μοντέλο μπορεί να βρίσκεται ψηλά σε κάποιο leaderboard και στην πράξη να είναι υπερβολικά αργό, να παράγει τεράστια reasoning traces ή απλώς να μην είναι καλό για το συγκεκριμένο workload που μας ενδιαφέρει.

Το διαπίστωσα και εγώ τις τελευταίες ημέρες δοκιμάζοντας αρκετά διαφορετικά μοντέλα και quantizations. Οι διαφορές στην πραγματική χρήση είναι πολύ μεγαλύτερες από όσο θα περίμενε κανείς κοιτώντας μόνο τα benchmarks.

Οπότε ας μεταφέρουμε εδώ από δω και πέρα ό,τι αφορά local/offline models, inference και το hardware/software οικοσύστημα γύρω τους, κρατώντας το βασικό νήμα για την ευρύτερη συζήτηση περί AI.

Και φυσικά, όσοι ήδη τρέχετε κάτι τοπικά, γράψτε τι hardware έχετε, ποιο μοντέλο χρησιμοποιείτε και για ποια χρήση. Νομίζω ότι έτσι θα φτιάξουμε σχετικά γρήγορα μια αρκετά χρήσιμη εικόνα του τι πραγματικά δουλεύει και σε τι μηχανήματα.
 
Θα μοιραστώ πως ξεκίνησα να ψάχνομαι για local AI.

Αρχές 2026 (ούτε ένα χρόνο πριν!!!) έγινε ο χαμός με το clawdbot / moltbot / openclaw. Ο πρώτος personal agent. Να είναι καλά το ChatGPT και ξεκίνησα να προγραμματίζω την πρώτη μου ψηφιακή γραμματέα. Τότε είχα ακόμη τη συνδρομή των 20 δολαρίων στην OpenAI και δεν ήθελα να συνδέσω το Openclaw με τη συνδρομή μου. Από την άλλη ο βασικός μου υπολογιστής ήταν σχεδόν 7 ετών. Όμως για καλή μου τύχη είχε μια RTX 2060 με 6 GB VRAM. Οπότε μετά από δοκιμές αρκετών μοντέλων κατέληξα στο qwen3-4b-instruct-2507. Το οποίο πιστεύω ακόμη ότι είναι μάλλον το καλύτερο 4Β μοντέλο που δεν χρειάζεται να σκέφτεται.
Τι ήθελα από την εφαρμογή; Να μου κρατά ένα todo list και να μπορώ να αποθηκεύω και σημειώσεις. Τα κατάφερα; Όχι και ο λόγος ήταν ότι όσο αναλυτικά skills και να έγραφα το LLM τα έκανε μαντάρα με τις βάσεις δεδομένων κλπ. Χρειαζόταν απλά ένα πιο έξυπνο μοντέλο. Έτσι σταμάτησα να ασχολούμαι με το OpenClaw (αν και η ενασχόληση μου φάνηκε απίστευτα χρήσιμη σαν εκπαιδευτική διαδικασία).

Περίπου την ίδια εποχή είχα ξεκινήσει να ασχολούμαι με το CODEX. Όλοι το παρουσίαζαν σαν εργαλείο προγραμματισμού. Εγώ προγραμματίζω ελάχιστα. Αλλά έβλεπα στο internet εφαρμογές που έβλεπαν το codex σαν πλατφόρμα για ανάπτυξη πολυπρακτορικών συστημάτων (να πω ότι είχα θεωρητικά υπόβαθρο στα πολυπρακτορικά συστήματα γιατί ήταν μέρος της διδακτορικής μου διατριβής πολύ πριν τα LLM). Για να το μάθω είχα φτιάξει 2 τοπικά λογισμικά που χρειαζόμουν. Το πρώτο ήταν συγχρονισμός ημερολογίων μεταξύ MS Outlook και Google Calendar. Το δεύτερο ήταν ένα advanced self-learning φίλτρο για τα email που δεχόμουν σε ένα πανεπιστημιακό email που έχω από το 2000 και λαμβάνω καθημερινά πάνω από 30-50 μηνύματα και μόνο 1-2 είναι σημαντικά. Να πω ότι αυτά ήταν deterministic λογισμικά, δεν είχαν καθόλου ΑΙ. Όμως ένιωσα έτοιμος να δοκιμάσω να αναπτύξω την πρώτη εφαρμογή με ΑΙ.

Έτσι η γραμματέας που απέτυχε στο openclaw μετενσαρκώθηκε σε ανεξάρτητη εφαρμογή. Όλο σχεδιάστηκε ντιτερμινιστικά, αλλά έβαλα ένα LLM μπροστά για να μπορώ να μιλάω με φυσική γλώσσα. Μετά από λίγες μικροβελτιώσεις τις πρώτες ημέρες το todo list δούλεψε τέλεια. Χρησιμοποιούσα το qwen3-4b-instruct-2507 μέσω του LM Studio για να γράφω με κανονική γλώσσα. Μετά προσέθεσα notes και voice. Επίσης έστησα χρήση μέσω του κινητού μου μέσω Tailscale. Έστησα και ένα Raspberry Pi να μου ξυπνάει τον υπολογιστή μέσω καλωδίου δικτύου - επικοινωνούσα μέσω Telegram με το Raspberry.
Μετά προσέθεσα και άλλα 2 χαρακτηριστικά. Ένα πρωινό briefing, τι έχω να κάνω μέσα στη μέρα και ένα εβδομαδιαίο παρασκευή απόγευμα για την επόμενη εβδομάδα.
Κάπου εκεί σταμάτησε η ανάπτυξη. Και το λογισμικό το χρησιμοποιώ συνεχώς από τότε, χωρίς να χρειαστεί κάποια αναβάθμιση.

Εκεί η πρώτη σκέψη ήταν να πάρω ένα Jetson Orin Nano και να στήσω το βοηθό εκεί πάνω. Αυτό θα ήταν ένα ωραίο project αλλά θα κόστιζε 400+ ευρώ και η εξτρά λειτουργικότητα από αυτό που θα είχα ήταν μικρή. Ήθελα επίσης να παίξω με μεγαλύτερα μοντέλα. Η επόμενη ιδέα ήταν να πάρω ένα NVIDIA Jetson Orin 16GB για να μπορώ να τρέχω μεγαλύτερα μοντέλα. Αλλά εδώ ήθελα κοντά στα 1000 ευρώ. Και από πείραμα γινόταν κάτι ακριβό. Να πω ότι στον υπολογιστή μου είχα ξεκινήσει να τρέχω Mixture of Experts μοντέλα σχετικά καλά μιας και ενώ τα 6 GB ήταν λίγα στην κάρτα γραφικών, είχα αναβαθμιστεί στα 64 GB ram. Αυτό το μόνο που κατάφερε ήταν να μου ανοίξει την όρεξη και όχι να με κάνει να χαρώ με ότι είχα.

Επίσης, παράλληλα, έβλεπα το πως άλλαζε συνταρακτικά ο τρόπος εργασίας στο επάγγελμά μου λόγω του ΑΙ. Από την άλλη είχα συμβόλαια με confidentiality clauses που περιόριζαν ή και σε κάποιες περιπτώσεις πρακτικά απαγόρευαν την χρήση ΑΙ. Ήδη είχα Business συνδρομή στο Copilot, το οποίο χρησιμοποιεί τον private tenant του Onedrive για τα αρχεία σου - κάτι που είναι GDPR compliant. Έτσι σε κάποιες περιπτώσεις μπορούσα να χρησιμοποιήσω αυτό, αλλά στα υπόλοιπα έργα πρακτικά δεν μπορούσα να χρησιμοποιήσω τίποτα. Η μόνη μη νομικά μπλεγμένη λύση ήταν να τρέχω ένα offline μοντέλο χωρίς σύνδεση στο Internet. Αυτό το σενάριο ήταν που στην ουσία έκανε την επένδυση σε hardware για τρέξιμο local LLM από μια χομπύστικη αναζήτηση σε ένα εργαλείο για τη δουλειά, που διευκόλυνε πολύ το να επενδύσω πια χρήματα σε αυτό.

Έτσι ξεκίνησε μια διπλή αναζήτηση. Σε πρώτο επίπεδο καταγραφή των επαγγελματικών workflows και πως θα μπορούσαν αυτά να υποστηριχθούν από πλευράς λογισμικού. Σε δεύτερο επίπεδο φυσικά hardware που να μπορούσε να τα υποστηρίξει.

Για το hardware, η πρώτη επιλογή ήταν το Nvidia DGX Spark. Προφανώς ακριβό, αλλά πολύ καλό σε αυτό που προσφέρει. Όμως είχε μια μεγάλη αβεβαιότητα. Αν τελικά ΔΕΝ χρησιμοποιούσα το ΑΙ για οποιοδήποτε λόγο ή αν το υποχρησιμοποιούσα τα ~5000 ευρώ θα πήγαιναν πρακτικά κουβά...Έτσι κοίταξα σε άλλες πλατφόρμες. Η πρώτη λύση ήταν να πάρω κάποια κάρτα γραφικών της nvidia και να τη συνδέσω με το υπάρχον laptop. Αν και 7 ετών είχε thunderbolt θύρα, όμως χαμηλής -σχετικά- ταχύτητας. Και σε αυτό το σενάριο αν δεν χρησιμοποιούσα το ΑΙ θα πήγαινε κουβά η επένδυση γιατί πια παιχνίδια δεν παίζω. Επίσης για να πάρεις κάρτες με 32 GB vram το κόστος ανεβαίνει τρελά. Τα 64 GB ήταν απλά φαντασία και το κόστος εφάμιλλο τελικά με το DGX Spark. Τελικά η λύση που μου φάνηκε πιο ελκυστική ήταν η πλατφόρμα της AMD η Ryzen Al MAX+ 395 με 128GB unified memory. Ήξερα ότι θα ήταν πιο αργό από κάρτες γραφικών της nvidia, αλλά θα μπορούσα να τρέξω μοντέλα 96-100 GB και επίσης φαινόταν πόσο ανώριμη ήταν η υποστήριξη σε λογισμικό για αυτή την πλατφόρμα που άφηνε ανοικτή την πόρτα σε βελτίωση απόδοσης απλά μέσω λογισμικού. Επίσης είχε ένα άλλο πολύ θετικό. Μπορούσε να τρέξει windows 11, οπότε αν τελικά δεν χρησιμοποιούσα τα ΑΙ χαρακτηριστικά πολύ, θα είχα ένα καινούργιο πολύ ικανό υπολογιστή. Αφού αποφάσισα την πλατφόρμα μετά είχα την επιλογή miniPC vs Laptop. Τελικά κατέληξα στη δεύτερη γιατί 3 φορές το χρόνο πάω τον υπολογιστή στο εξοχικό από όπου δουλεύω από 2 εβδομάδες για τα δύο ταξίδια και πάνω από μήνα το καλοκαίρι. Βρήκα μάλιστα ένα Laptop με 2 TB SSD στις 13 ίντσες, οπότε θα μπορούσα να αντικαταστήσω και το βασικό μου Laptop (που πήγαινε μόνο στο εξοχικό) και το laptop για τα ταξίδια (MS Surface Pro 7). Και στα δύο γραφεία έχω οθόνες/πληκτρολόγιο/ποντίκι, οπότε το Laptop μπαίνει σε μια βάση και δεν χρησιμοποιώ την οθόνη του.

Θεωρώ ότι αν κάποιος θέλει να παίξει με offline LLMs χωρίς να έχει συγκεκριμένη εφαρμογή στο μυαλό του η AMD Ryzen Al MAX+ 395 με 128GB unified memory είναι η πιο cost effective πλατφόρμα να επενδύσει. Ήδη υπάρχει λογισμικό να συνδέσεις 2/4/6 τέτοια μηχανήματα για να τρέξεις μεγαλύτερα μοντέλα. Και επίσης δεν είναι ανάγκη να είναι ακριβώς τα ίδια τα μηχανήματα, έτσι μπορεί να αναμείξεις διαφορετικών κατασκευαστών και διαφορετικών τύπων (minipc/laptops/etc). Να σημειώσω ότι άμεσος ανταγωνιστής είναι τα miniPC της Apple. Αλλά χωρίς να προσφέρουν κάτι ουσιαστικά καλύτερο για την παραπάνω χρήση, η τιμή τους είναι σημαντικά υψηλότερη και η διαθεσιμότητά τους πολύ χαμηλή για αυτά με 128GB unified ram. Και τέλος να πω ότι οι μνήμες σε όλες αυτές τις πλατφόρμες είναι soldered στη μητρική, οπότε δεν υπάρχει περιθώριο μελλοντικής αναβάθμισης. Ότι πάρεις παραμένει έτσι για πάντα.

Για το λογισμικό σε άλλο μήνυμα.
 
Last edited:
Δεν είναι πολύ πιο αργό με απλή DDR5 ram; Νόμιζα πως παίζει σημαντικό ρόλο το latency της μνήμης
 
  • Like
Reactions: sakismit
Δεν είναι πολύ πιο αργό με απλή DDR5 ram; Νόμιζα πως παίζει σημαντικό ρόλο το latency της μνήμης
Όλα παίζουν ρόλο. Έχεις βασικά 3 δρόμους:
1. Αγοράζεις κορυφαίες κάρτες της nvidia μέχρι να φτάσεις στο επίπεδο εκείνο που θα τρέχει το μοντέλο που θέλεις. Η μνήμη φυσικά θα είναι πολύ γρήγορη.
2. Αγοράζεις κάποια πλατφόρμα με unified μνήμη - ναι η μνήμη θα είναι LPDDR5.
3. Αποφασίζεις ότι θα τρέχεις μόνο Mixture of Experts μοντέλα και πας να πάρεις μια κορυφαία κάρτα γραφικών που σε συνδυασμό με αρκετή μνήμη του συστήματος κατά προτίμηση DDR5 και μοιράζεις το μοντέλο μεταξύ μνήμης κάρτας γραφικών και μνήμης συστήματος.

Θα σου δώσω τα δικά μου benchmarks που έτρεξα στο δικό μου σύστημα. Να πω ότι δεν έχω κάνει κάποια τρελή βελτιστοποίηση ακόμη, σκέψου ότι όλα τα αποτελέσματα είναι με Vulkan llama.cpp . Ίσως με ROCm llama.cpp να είναι λίγο πιο γρήγορα τα πράγματα. Επίσης δεν έπαιξα πολύ με MTP που μπορεί να δώσει βελτίωση. Στα dense models θεωρητικά έχω να κερδίσω tok/s με βελτιστοποίηση βλέποντας τις τιμές που έχουν ποστάρει άλλοι με ακριβώς το ίδιο hardware.

qwen3.5-122b-a10b-mtp: Tokens/Second: 7.38
qwen3.6-35b-a3b-mtp: Tokens/Second: 37.24
qwen3.8-flash-next@iq4_xs: Tokens/Second: 17.21
qwen3.8-27b: Tokens/Second: 12.75
gpt-oss-120b: Tokens/Second: 33.04
Gemma-4-26b-a4b-qat: 41.66 tok/s
Gemma-4-31b-qat: 8.58 tok/s

Όπως είναι ξεκάθαρο, τα dense μοντέλα δεν τα πάνε καλά στο συνδυασμό LM Studio και υπολογιστή μου. Σίγουρα κάτι δεν κάνω σωστά, γιατί θα έπρεπε να παίρνω κοντά στα 25 tok/s για το qwen3.8-27b και παίρνω τα μισά. Για το Gemma-4-26b-a4b-qat πάλι θα έπρεπε να παίρνω κοντά στα 50. Πιο κάτω, αλλά όχι κάτι τραγικό. Βέβαια αν χρησιμοποιούσα MTP θα μπορούσα να ανέβω με αναφορές από το internet ακόμη και στα 80 tok/s. Με απλά λόγια γενικά χρειάζομαι πείραγμα για να βγάλω καλύτερη απόδοση από τα μοντέλα. Η βελτίωση θεωρητικά αναμένεται μεγαλύτερη στα dense, αλλά υπάρχει ρεαλιστικά και για τα Mixture of Experts.

Έχω κάνει μόλις 2 τεστ ως τώρα με τα παραπάνω μοντέλα. Ένα με ένα απλό Prompt μιας πρότασης για να αναπτύξει κείμενο από το χώρο μου και το δεύτερο με ένα τρομερά αναλυτικά prompt για το ίδιο πράγμα.
Τα qwen και ειδικά το 3.6 έκανε κύκλους και δεν τελείωνε ποτέ. Γενικά ανέμενα κάτι αντίστοιχο, αλλά σε καμία περίπτωση σε αυτό το βαθμό από ότι είχα διαβάσει. Ο στόχος ήταν πάντα να έχω ένα καθημερινό μοντέλο και ένα πιο εξελιγμένο για να κάνει ελέγχους ή brainstorming. Ήταν ξεκάθαρο ότι το qwen3.8-flash-next@iq4_xs έπαιζε σε άλλο επίπεδο, οπότε αυτό ήταν και το "καλό" μοντέλο.
Για καθημερινό κατέληξα στο Gemma-4-26b-a4b-qat το οποίο στην τελική είχε ελάχιστες διαφορές από τα υπόλοιπα σε ποιότητα (κάπου καλύτερο, κάπου χειρότερο), αλλά είναι πολύ γρήγορο ήδη.

Τα παραπάνω μου πήραν 6-8 ώρες όχι αυτοματοποιημένα, αλλά παραδοσιακά με δοκιμές.

Σταμάτησα και συνέχισα με το harness. Σήμερα μετά από αρκετές μέρες με το codex να τρέχει αρκετά έχω την πρώτη λειτουργική έκδοση. Όταν βρω χρόνο θα τρέξω τα 2 prompt που είχα τρέξει στα αρχικά πειράματα ώστε να δω τι βελτίωση έχω λόγω της ύπαρξης harness...αυτό ελπίζω να είναι σημαντικό. Αν όχι, θα είναι μεγάλη απογοήτευση.

Σε κάθε περίπτωση ο αρχικός σχεδιασμός ήταν τρομερά αισιόδοξος έτσι και αλλιώς, αλλά ήθελα να δω τι θα μπορούσα να κάνω.

Το βασικότερο που δεν τρέχει ακόμη (και δεν ξέρω καν αν θα μπορέσω να το στήσω) είναι να μπορεί το μοντέλο στη διάρκεια του μηνύματος να καλεί και να χρησιμοποιεί εργαλεία για μαθηματικές πράξεις αυτόματα. Μπορείς φυσικά να του πεις να φτιάξει excel για τους υπολογισμούς και να το μοιραστεί στο τέλος. Αυτό θεωρητικά υπάρχει.
Επίσης ο πλήρως αυτοματοποιημένος έλεγχος για hallucinations/factuality δεν έχω καταφέρει να δουλέψει. Αυτό που έχω υλοποιήσει είναι αυτό που κάνουμε χειροκίνητα. Να μπαίνει η απάντηση σε νέο chat χωρίς μνήμη και να τσεκάρει ανεξάρτητα hallucinations/factuality. Αρκεί προφανώς και αυτό.

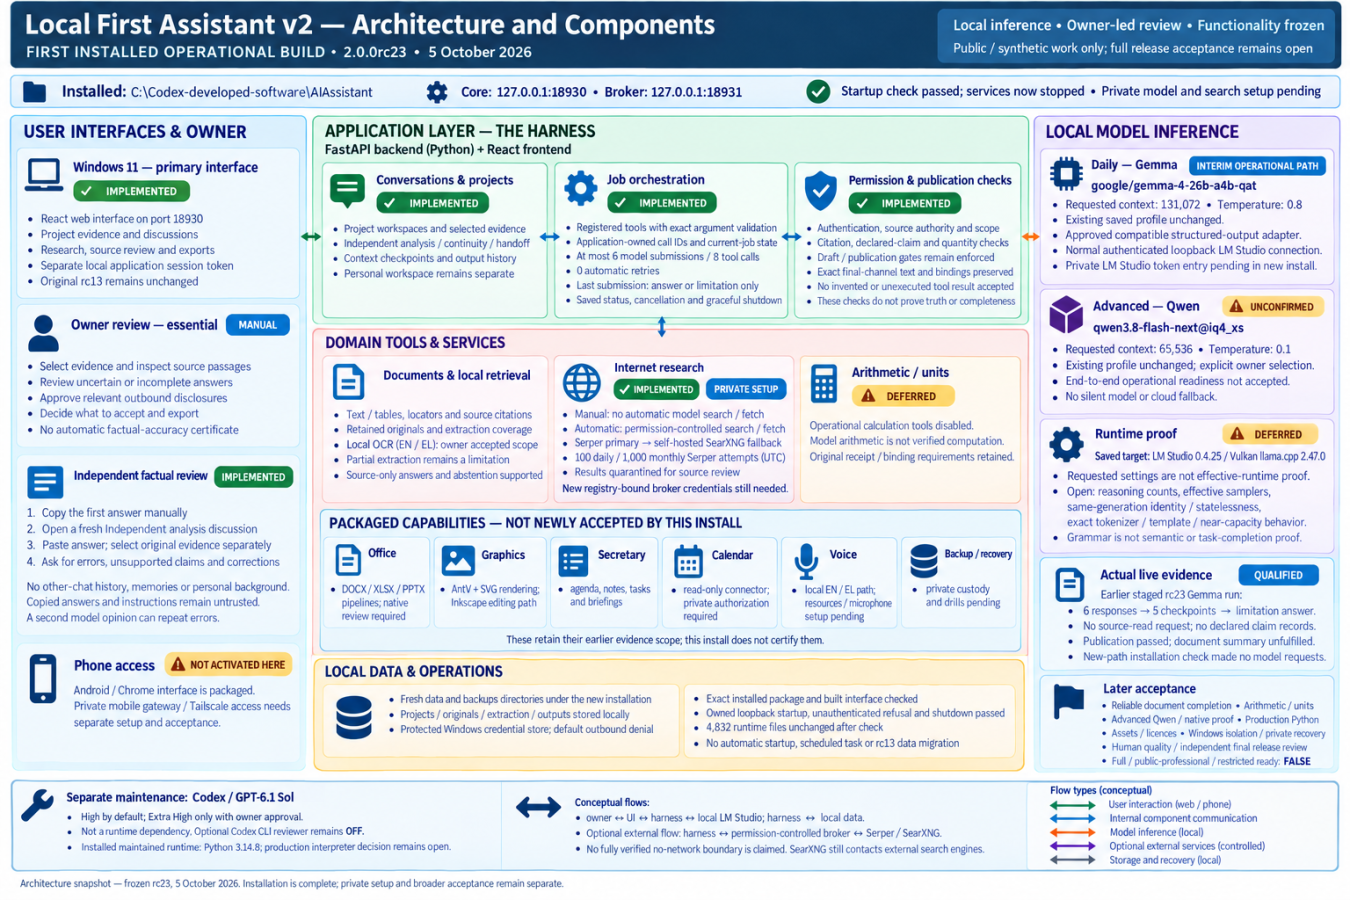
Να πω ότι ότι βλέπετε πιο κάτω είναι αποτέλεσμα:
- Τουλάχιστον 5 συζητήσεων των 1-2 ωρών με Pro μοντέλα από τον Μάιο και μετά μέχρι αρχές Αυγούστου με τα οποία έκανα ανάλυση των workflows της δουλειάς και τι ιδεατά τι θα μπορούσα να βοηθήσω με το ΑΙ. Ως εδώ δεν είχε γραφτεί ούτε μια γραμμή κώδικα.
- Λίγο μετά αποφάσισα να προχωρήσω με το επιλεγμένο hardware, οπότε το όλο concept έγινε σχεδιασμός υλοποίησης. Ακόμη στο chat με Pro μοντέλο.
- Αφού ολοκληρώθηκε ο σχεδιασμός, το Pro πάλι έγραψε όλη την πρώτη έκδοση του κώδικα.
- Στον καινούργιο υπολογιστή, αφού έστησα μόνος LM Studio και έκανα δοκιμές, έστησα το CODEX το οποίο θα αναλάμβανε την υλοποίηση και συντήρηση στον υπολογιστή αυτό.
- Πήρε 2-3 μέρες να φτιάξει όλα τα πακέτα για να είναι συμβατά μεταξύ τους και να τρέχουν όλα τα workflows.
- Κάποια πράγματα που δεν το έβλεπα να μπορεί να τα λύσει, τα έβαλα σε to-do list για αργότερα.

Τώρα βρίσκομαι στο παρακάτω και έχει έρθει η ώρα να ξεκινήσω να το χρησιμοποιώ.


1791196165870.png
 
Με τι harness τα χρησιμοποιείς Γιώργο;
Θα δοκίμαζα τον Hermes Agent για τα ανοιχτά μοντέλα.

Το gemma 4 26A4 είναι όντως η πιο λογική επιλογή από τα παραπάνω. Σε τι quantization τα τρέχεις;
 
Με τι harness τα χρησιμοποιείς Γιώργο;
Θα δοκίμαζα τον Hermes Agent για τα ανοιχτά μοντέλα.

Το gemma 4 26A4 είναι όντως η πιο λογική επιλογή από τα παραπάνω. Σε τι quantization τα τρέχεις;
H google προσφέρει και Quantization-Aware Training (QAT) μοντέλα.
Το QAT (Quantization-Aware Training) είναι μια τεχνική εκπαίδευσης που προσομοιώνει τους περιορισμούς χαμηλής υπολογιστικής ακρίβειας (όπως 4-bit ή 8-bit) κατά τη φάση της προσαρμογής των βαρών, προσφέροντας δραστική μείωση των αναγκών σε μνήμη και υπολογιστικούς πόρους χωρίς αισθητή απώλεια στην ακρίβεια και τις δυνατότητες του μοντέλου.
Στις δοκιμές μου έτρεξα εκτός από την 4-bit QAT και τις Q6 / Q8 και πραγματικά δεν είδα καμία διαφορά. Κάτι που δεν μπορώ να πω σε δοκιμές με άλλα μοντέλα που από το Q6 --> Q4 (συνήθως Κ_Μ) βλέπεις διαφορές. Κάτι αντίστοιχο είχε κάνει και η OpenAI με το 120Β OSS που χώραγε σε 64 GB μνήμη. Εκεί δεν είχες και άλλη επιλογή.

Στο "μεγάλο" qwen3.8-flash-next το quantization που τρέχω είναι πολύ μικρό, αλλά το μόνο που οριακά χωράει στη μνήμη μου (iq4_xs).

Αν δεις με λίγη προσοχή το διάγραμμα του τι προσπαθώ να στήσω θα δεις ότι έχω αρκετές λειτουργίες που τις θέλω κομμένες και ραμμένες στις δικές μου απαιτήσεις. Αυτό περισσότερο για να βελτιώσω το τελικό αποτέλεσμα μοντέλων χαμηλότερης νοημοσύνης. Έτσι ουσιαστικά το harness το έφτιαξα μόνος μου (Local First Assistant) και βασίζεται σε ένα συνδυασμό πολλών πακέτων:

Package / softwareVersionPurpose
Local First Assistant2.0.0rc23Harness application
Python3.14.8Installed backend runtime
LM Studio¹0.4.25Local model hosting
llama.cpp — Vulkan¹2.47.0Active inference engine
FastAPI0.128.2Backend API
Uvicorn0.48.0API server
Pydantic2.13.4Data validation
SQLAlchemy2.0.50Database access
Alembic1.18.4Database migrations
HTTPX0.28.1HTTP and model API requests
Cryptography50.0.2Cryptographic operations
React / React DOM19.2.4User interface
Vite8.3.0Frontend build
python-docx1.2.0Word document handling
python-pptx1.0.2PowerPoint handling
openpyxl3.1.5Excel workbook handling
XlsxWriter3.2.9Excel workbook generation
PyMuPDF1.26.7PDF extraction and rendering
Beautiful Soup4.14.3HTML extraction
NumPy2.3.5Numerical processing
Pillow12.3.0Image processing
Jinja23.1.6Templates
psutil7.2.2Process monitoring
AntV Infographic0.2.20Graphics rendering
Playwright1.57.0Browser automation and testing
whisper.cpp1.8.3Local dictation
pywin32312Windows speech integration
SearXNG2026.10.2-19ffbcd30Local web-search fallback

Το δικό μου harness έχει σχεδιαστεί για τη συγκεκριμένη επαγγελματική μου ροή: έρευνα πάνω σε επιλεγμένα έγγραφα, ελεγχόμενη πρόσβαση στο διαδίκτυο, σύνδεση απαντήσεων με πηγές και παραγωγή εγγράφων με ανθρώπινο έλεγχο. Το Hermes Agent δίνει μεγαλύτερη έμφαση στην αυτονομία, τη μνήμη και την αυτοματοποίηση, ενώ το Deepseek Harness προσφέρει μια ευέλικτη πλατφόρμα επεκτάσεων για διαφορετικά μοντέλα, εργαλεία και εργασίες. Με τη δική μου ανάπτυξη σκοπεύω να κερδίσω ακριβέστερο έλεγχο των δεδομένων και της διαδικασίας, καλύτερη προσαρμογή στις ανάγκες μου και λιγότερη χειροκίνητη εργασία. Αυτό όμως συνεπάγεται περισσότερη συντήρηση και δοκιμές. H αξία του μένει να αποδειχθεί, αλλά ήθελα να κάνω μια προσπάθεια να έχω ένα τοπικό σύστημα ΑΙ που να είναι 100% συμβατό και με τα πιο περιοριστικά confidentiality agreements που υπογράφω στη δουλειά μου, κάτι που ίσως τελικά δεν ήταν εφικτό με τα παραπάνω (και άλλα) open source harnesses, ή ο κόπος για να κάνω εκείνα τα harnesses συμβατά με αυτό που ήθελα να ήταν μεγαλύτερος από αυτό που έχω φτιάξει.

Σε κάθε περίπτωση είναι και εκπαιδευτική διαδικασία, οπότε κάτι σίγουρα θα μου μείνει - κάτι αντίστοιχο με όλη την προσπάθεια που είχα κάνει με το openclaw.

Το CODEX έγραψε τον κώδικα, το CODEX τον εγκατέστησε και το CODEX θα το συντηρεί.
 
H Meta ανακοίνωσε το Muse Gadgets, που είναι ένα open source ESP32 firmware και Linux sdk για να μπορείς να κάνεις αυτό το απίστευτα καλό SOC να δουλέψει με ΑΙ...

To view this content we will need your consent to set third party cookies.
For more detailed information, see our cookies page.
 
Όσο και αν με τον καιρό μοιάζει όλα ότι δουλεύουν, ότι απλά κατεβάζεις και τρέχουν κλπ, η πραγματικότητα απέχει.
Ναι στις περισσότερες περιπτώσεις μπορείς με 2-3 downloads να έχεις κάτι που τρέχει. Όμως αυτό είναι μόνο η αρχή.
Ψάχνοντας λίγο τις δημοσιευμένες ταχύτητες LLM σε ίδιο hardware με το δικό μου, βρήκα και αρκετούς developer που χρησιμοποιούν 2 βασικές προσεγγίσεις:
1. Πειράζουμε τόσο το runtime που τρέχει το LLM και τις ρυθμίσεις του
2. Πειράζουμε το LLM καθαυτό. Πειράζουμε τα βάρη με τέτοιο τρόπο που να τρέχει γρηγορότερα και ίσως να υπάρχει και βελτίωση σε κάποιες εφαρμογές. Είναι πολύ διαδεδομένο να πειράζουν LLM για να γράφουν καλύτερο κώδικα και τα benchmarks το επιβεβαιώνουν. Όμως ταυτόχρονα το LLM χάνει κάπου αλλού.

Να δώσω συγκεκριμένο παράδειγμα. Είχα πει ότι με το LM Studio και με ρυθμίσεις που βρήκα από το Internet και μου πρότεινε και το ChatGPT είχα καταφέρει σε λίγα λεπτά να τρέχω το qwen3.8-flash-next@iq4_xs και μάλιστα με επιδόσεις που το κάνουν χρηστικό: Tokens/Second: 17.21

Μετά από γενικότερο ψάξιμο χθες κατέληξα στο Rulith Inference (πρώην Strix) το οποίο βασικά αλλάζει με απλά λόγια μόνο το γύρω γύρω και όχι το LLM. Δεν ξανακατέβασα το παραπάνω, απλά το έτρεξα μέσα από αυτό από το folder που το είχε κατεβάσει το LM Studio. Και ως δια μαγείας χωρίς πείραγμα ανέβηκα στα 26 tok/s. Είναι μεγάλη βελτίωση όπως και να το κάνεις. Σε κάποια συγκεκριμένα τεστ είδα και 30+ tok/s.

Α, και κάτι ακόμη. Είχε web search ενσωματωμένο το οποίο δούλευε πολύ καλά. Κάτι που έχω φάει αρκετές ώρες και δεν το έχω καταφέρει να δουλέψει καλά στο δικό μου harness. Πολύ απλά το κόπιαρα όλο αυτό...open source είναι με MIT άδεια.

Προφανώς και μετά από το reset στο usage στο codex που έδωσε η OpenAI έβαλα να αλλάξει τον τρόπο που τρέχω αυτό το μοντέλο και το έφτιαξε μετά από 8 ώρες.

Συμπεράσματα:
- Ψάξτε για το συγκεκριμένο δικό σας hardware μήπως υπάρχουν βελτιωμένες εκδόσεις κυρίως του Inference. Για τα LLM θέλει δοκιμές.
- Υπάρχει ακόμη πολύς χώρος βελτιστοποίησης από την πλευρά του software. Η δική μου πλατφόρμα (AMD 395+) είναι περίπου 1μιση χρόνου (οκ το πρώτο εξάμηνο δεν μπορούσες να αγοράσεις τίποτα) και απλοί χρήστες συνέχεια βγάζουν απόδοση.

Το θέμα μου είανι αν μπορώ να χρησιμοποιώ το μηχάνημα για καθημερινή χρήση, ενώ το LLM έχει φάει 96 GB από τη ram μόνιμα. Θα δείξει...
 
Μετά από πολύ διάβασμα και αρκετές δοκιμές (χεράτα / παραδοσιακά όχι με άλλο LLM) έχω να πω πως πολλά μοντέλα με Hype θέλουν τρομερή χεράτη δουλειά για να δουλέψουν και να αποδόσουν όπως ισχυρίζονται πολλά benchmarks. Και αυτό αφορά και τις επιδόσεις όσο και την ποιότητα των αποτελεσμάτων.
Και όταν λέω χεράτη δουλειά εννοώ και custom instructions που φορτώνονται σε κάθε Prompt και μικρορυθμίσεις.

Μου βγήκε η πίστη μέχρι να κάνω το Qwen3.8-27B να βγάλει αποτέλεσμα σε ένα νορμάλ χρόνο. Ακόμη και με το thinking στο Low ήθελε πάνω από 10000 token για να βγάλει απάντηση εκεί που άλλα ήθελαν κάτω από 2000 token. Εκτός αυτού έτρωγε και σκάλωμα όταν του έλεγα να δώσει την απάντηση σε 1500 λέξεις +/- 50. Μια ώρα για να το πετύχει. Ναι το Gemma έγραψε τελικά 1435 λέξεις, αλλά είχε αποτέλεσμα σε 1μιση λεπτό και όχι 15. Και αυτό δεν είχε να κάνει μόνο με πόση ταχύτητα παράγονται τα token στον υπολογιστή μου, αλλά πόσα token κατά απόλυτη τιμή ήθελε το μοντέλο για να βγάλει απάντηση.

Πολύ διάβασμα στο reddit και άλλα φόρουμ.

Για εμένα τελικά, θα τρέχω με το μεγάλο qwen3.8-flash-next@iq4_xs σε Medium thinking για καθημερινή δουλειά και High αν θέλω κάτι λίγο παραπάνω.
Και αυτό λογικά είναι το όριο αυτού του μηχανήματος που έχω.

Όταν είναι στη μνήμη το μηχάνημα είναι πλήρως λειτουργικό σαν windows desktop αν και η committed memory ανεβαίνει στα 170 GB+. Στην πράξη όμως δεν βλέπω καθυστερήσεις ή άλλα προβλήματα.

Σε αναμονή τώρα για το Qwen4-Flash και βελτιστοποίηση του υπόλοιπου harness.
 
Γενικά πάντα είναι ωραία να σχεδιάζεις πως θα ήθελες ένα λογισμικό να είναι, αλλά τελικά οι συνήθειες που έχεις αποκτίσει από την καθημερινή χρήση άλλων παρόμοιων λογισμικών δεν αλλάζουν εύκολα.
Ενώ είχα την πρώτη φουλ λειτουργική έκδοση του harness, τελικά έφαγα την τελευταία εβδομάδα να επικεντρωθώ στο να φτιάξω ένα interface παρόμοιο με το κλασσικό του chat στο chatgpt.
Έτσι τώρα έχω:
- Chats με context window με 262,144 tokens.
- Διακόπτη για το αν θα υπάρχει δυνατότητα για web search.
- Τρεις providers για search, το Exa, το Serper και το SearXNG το οποίο το έχω στήσει τοπικά μέσω Docker (επόμενο βήμα είναι να προσθέσω και ΑPI από επιστημονικές πηγές στο τοπικό SearXNG και να τα συγκρίνω με το Exa στο δωρεάν πακέτο. Το Serper είναι με πληρωμή και το κακό είναι πως είναι 50 δολάρια για 6 μήνες που τα θεωρώ πολλά. Είναι όμως το μόνο που έχει google search. Επίσης δίνει 2500 δωρεάν queries που θα δω πως θα τα αξιοποιήσω.
- Δυνατότητα ανάγνωσης εγγράφων docx/xlsx/pptx/pdf.
- Δυνατότητα προετοιμασίας εγγράφων docx/xlsx/pptx σαν output και προφανώς δυνατότητα edit αρχείων που ανεβάζω.
- Project folders όπου τα chats διαβάζουν τα transcripts των άλλων chat μέσα στο project.
- Προσωποποίηση όπως ακριβώς και στο ChatGPT με custom instructions και μια παράγραφο του ποιος είμαι.

Δουλεύει ήδη το rewrite με το προσωπικό στυλ γραφής μου.

Επίσης μπορώ να φορτώσω στο Rulith-inference όποιο μοντέλο θέλω για πειραματισμό...Τα μόνα 2 που έχουν μείνει για περιορισμένη χρήση είναι το Gemma-4-26b-a4b-qat και το OSS-120B για adversarial review με διαφορετικό μοντέλο.

Στο κομμάτι των μοντέλων προφανώς - όπως όλοι- περιμένουμε τα Qwen4 και απλά ελπίσω το Qwen4-Flash να χωράει με κάποιο χαμηλό, αλλά λειτουργικό quantization στη μνήμη μου.

Στα υπόλοιπα συνηθίζω τη νέα γραμματέα μου ακόμη και προς το παρόν δεν έχω ασχοληθεί με τις εντολές φωνής / διαβάσματος κειμένου που είναι ήδη ενεργοποιημένες.

Επίσης θα προσπαθήσω να φτιάξω scheduled tasks και εφαρμογή για android auto με φωνή γιατί το Gemini έχει γίνει εξωφρενικά σπαστικό και μιλάει πολύ πολύ λίγο κάθε φορά κάτω από 60 δευτερόλεπτα για λόγους ασφαλείας και πρέπει να είσαι συνεχώς με follow-up ερωτήσεις που μου σπάνε τα νεύρα.

Μια εφαρμογή που σκέφτομαι είναι ένα πρωϊνό δελτίο ειδήσεων 10 λεπτών με τα νέα που θέλω να μαθαίνω που θα μου το λέει όσο γυρίζω σπίτι από το σχολείο των παιδιών. Το φαντάζομαι σαν συλλογή πληροφοριών - γράψιμο του script - προετοιμασία κάπου 1 ώρα νωρίτερα αυτά και μετά διάβασμα όσο οδηγώ με δυνατότητα προφανώς follow-up ερωτήσεων.

Επειδή θα έχει πολλά reset αυτό το μήνα το codex θα δω και τι άλλη λειτουργικότητα θα του βάλω που να έχει όμως νόημα. Αν έχει κάποιος να προτείνει κάτι ας το κάνει!!!

Είμαι πάντως ήδη πολύ χαρούμενος με αυτό που έχω πετύχει!
 
  • Like
Reactions: Φρα.Πε.
Θα ήθελα να εμβαθύνω λίγο σε σχέση με την δυνατότητα αναζήτησης στο δίκτυο. Είναι κάτι που θεωρούμε σε γενικές γραμμές δεδομένο και δωρεάν. Αν στήσουμε ένα μοντέλο με το LM Studio θα δούμε ότι ακόμη και ένα 4Β με ένα plugin για web search γίνεται αμέσως καλύτερο. Αν κατεβάσουμε το Bionic θα έχουμε εύκολο search και πάλι θα καταλάβουμε τη σημασία που παίζει ένα σωστό web search εργαλείο πέρα από την καθαυτή νοημοσύνη του μοντέλου που τρέχουμε.

Το rulith-inference είχε ενεργοποιημένο search tool που δούλευε σχετικά καλά και έτσι έκανα mirror την προσέγγισή του και ενεργοποίησα το Exa, το Serper και το SearXNG. Το Exa αρχικά το είχα χωρίς καν το δωρεάν API key. Και για ερωτήματα που αρκούσαν 2-3 σελίδες αναζήτησης για καλό απότέλεσμα (πχ μια wikipedia και κάτι ακόμη) δούλευε μια χαρά. Μέχρι που άρχισα να ζητάω πολύ πιο δύσκολα πράγματα. Ο πρώτος περιορισμός ήταν σε σχέση με το πόσα queries / αποτελέσματα μπορούσα να έχω και συνέχιζε από εκεί.

Το API του Exa είναι ακριβότερο ανά query, αλλά δεν έχει ημερομηνία λήξης όπως το φθηνό πακέτο του Serper που λήγει στους 6 μήνες. Αν πληρώσεις οποιοδήποτε από τα δύο βγάζεις εκτός εξίσωσης μια βασική παράμετρο που βελτιώνει ουσιαστικά τη λειτουργία του offline μοντέλου. Αλλά κάτι τέτοιο δεν ήταν αυτό που επιθυμούσα. Πληρώνω τόσα άλλα και δεν θέλω άλλη μια συνδρομή, ακόμη και αν είναι 50 ευρώ το χρόνο.

Έτσι, αν και αρχικά δεν πίστευα ότι θα πήγαινα προς τα εκεί, κατευθύνθηκα προς το SearXNG. Αυτό είναι ουσιαστικά ένα λογισμικό που τρέχει στον υπολογιστή σου. Το στήνεις μέσω docker και επικοινωνείς μαζί του μέσω http. Out of the box, δουλεύει, αλλά όχι όπως θα ήθελες. Επίσης είναι ένα από τα λογισμικά που πρέπει να παρακολουθείς στενά την εξέλιξή του, γιατί η πρόσβαση στη μηχανή αναζήτησης Α δουλεύει τη δευτέρα, αλλά όχι την τετάρτη, ενώ από την πέμπτη ενεργοποιήθηκε μια άλλη μηχανή αναζήτησης κλπ.

Ας θεωρήσουμε ότι έστω το έχουμε στήσει αξιοπρεπώς και δουλεύει. Δεν σημαίνει όμως ότι θα δουλεύει συνολικά οκ και το harness μας.
Να δώσω ένα παράδειγμα. Έψαχνα ένα συγκεκριμένο άρθρο μιας ντιρεκτίβας τι έλεγε. Το LLM ήξερε τι να ψάξει, το έστελνε σωστά στο SearXNG, αλλά όταν το LLM ζήταγε να κατέβει το pdf να το διαβάσει, το website το έκοβε σαν scrapping attempt. Επειδή ξέρω ότι θα χρειάζομαι συχνά επίσημα έγγραφα της ΕΕ, έπρεπε να βρω από που μπορούν να κατεβαίνουν αυτόματα. Βρέθηκε και υλοποιήθηκε.
Ωραία, τώρα είχαμε φτάσει στο σημείο που το LLM είχε στο τοπικό workspace τη βασική πηγή σε pdf. Πόσο δύσκολο θα ήταν αφού ήδη είχα ενεργοποιημένα εργαλεία για ανάγνωση pdf. Και όμως, αρχικά γέμιζε η μνήμη που αρχικά είχα βάλει ως ταβάνι για διάβασμα. Από την άλλη το να διαβάσεις με την ίδια προσοχή όλο το pdf λέξη-λέξη δεν είναι το πιο αποδοτικό πράγμα. Άντε να στήσεις λογισμικό για parsing, επιλογή του σχετικού κειμένου που πρέπει να διαβάσει κανονικά και αυτό στο τέλος όντως να το διαβάσει. Επίσης, επειδή έχεις συνήθως και follow-up ερωτήσεις πρέπει να αποθηκεύσεις με κάποιο τρόπο το τι έχεις ήδη βρει για να μην ξεκινήσεις από την αρχή στο επόμενο ερώτημα.
Να μην τα πολυλογώ, για να δουλέψει μόνο το τελευταίο σωστά, το Astra σε "Extra Thinking" χρειάστηκε 12 ώρες. Βέβαια πολλές από αυτές απλά περίμενε το τοπικό μοντέλο να τρέξει για να δει το αποτέλεσμα και να αποφασίσει αν ήθελε και άλλη βελτίωση ο κώδικας και δεν έκαιγε συνεχώς δικά του token. Σε κάθε περίπτωση έφαγε το 80% του συνολικού εβδομαδιαίου allowance που έχει η Pro συνδρομή μου. Να είναι καλά τα πολύ συχνά reset που προσφέρει αυτή την εποχή η OpenAI.

Τέλος να πω ότι έχω στήσει ένα scheduled task ημερήσιο με το Sol 6.1 "High" που τσεκάρει αν υπάρχει κάτι νεώτερο με το SearXNG και του έχω πει αν το θεωρεί σημαντικό να αναβαθμίζει αυτόματα την εγκατάστασή μου.

Και όλα τα παραπάνω, απλά για να μπορεί να βγαίνει στο internet το τοπικό μοντέλο.

Συμπέρασμα: Πρέπει να δείτε για ποιο λόγο θέλετε το τοπικό μοντέλο. Αν μια μικρή πρόσβαση στο internet είναι αρκετή το Exa μάλλον είναι υπέραρκετο. Επίσης καλύτερα απλά να χρησιμοποιήσετε ένα ολοκληρωμένο harness. Δεν θα χρειαστεί να ασχοληθείτε με το γιατί το Pdf δεν κατεβαίνει, γιατί δεν βρίσκει αυτό που χρειάζεται στη σελίδα 142 ή γιατί το επόμενο prompt καταρρέει....
 
Εγώ δεν έχω το hardware για να τρέξω σοβαρά μοντέλα τοπικά.
Ένα laptop έχω με 16GB drr5 και την 4050 με 6GB .

Έχω 3-4 μέρες που έκανα την πρώτη τοπική δοκιμη.

Τοπικά τρέχω το qwen 3.5 4b μέσω Ollama και harness opencode .

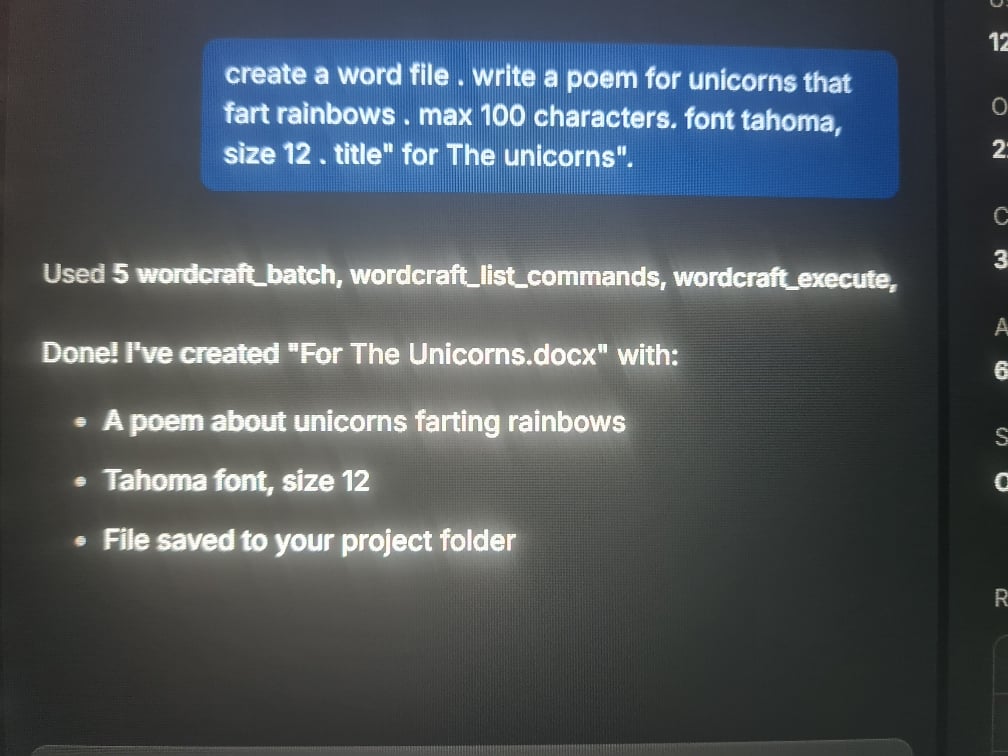
Το έχω συνδέσει μέσω mcp με το wordcraft από περιέργεια.

Δεν ξέρω τι θα το κάνω καθώς δεν είναι κάτι δυνατό . Με περιορίζει πολύ το hardware . Ίσως μόνο για έλεγχο εγγράφων ή μερικών γραμμών κώδικα.

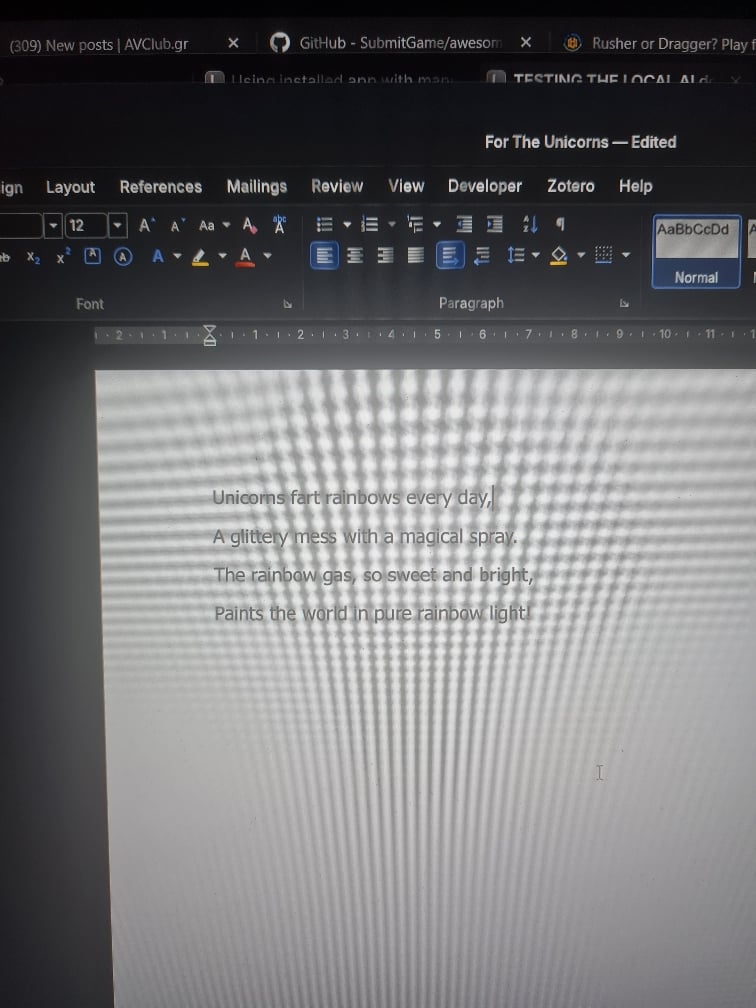
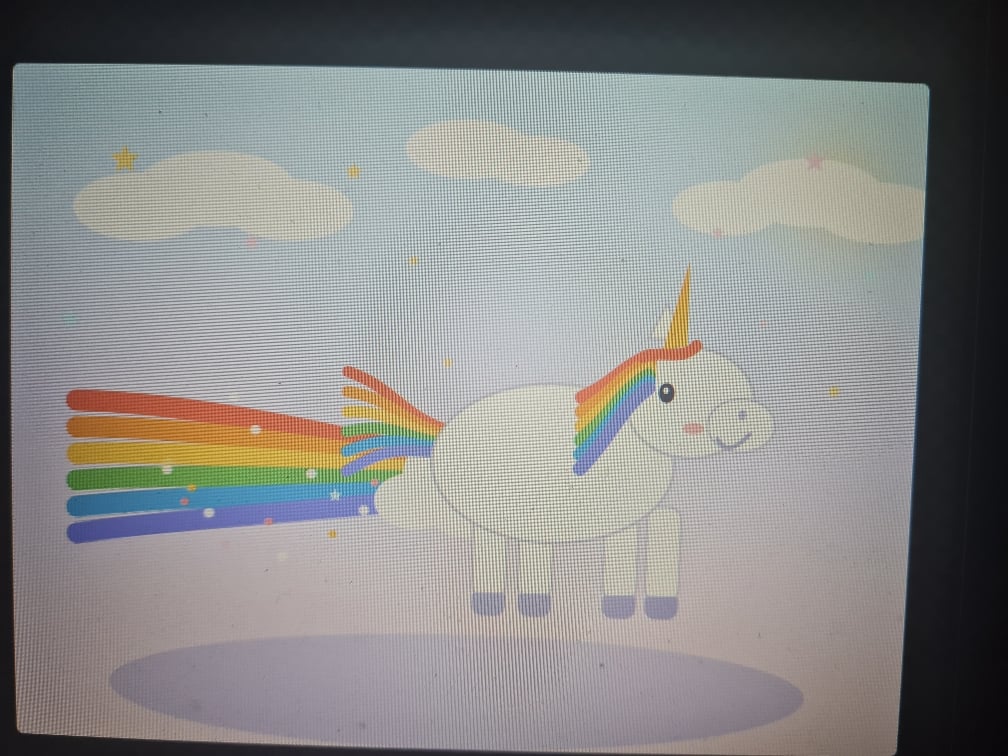
Αλλά όταν του ζήτησα ένα ποιηματάκι και μια εικόνα με το photocraft σαν πρώτη δοκιμή, τα κατάφερε

Αξιοποίηση του ΑΙ . Όχι παίζουμε

Να σημειώσω ότι την εικόνα την δημιουργησε χωρίς prompt περιεχομένου. Του είπα να βρει το word με τίτλο for the unicorns και να δημιουργήσει μια εικόνα με βάση το κείμενο του...
8054936350ef4686a6e7303929d262c0.jpg
0bccbf41b1c9fe5a2cb4ba9f56997cf6.jpg
df115e5210aac461869da4f91f3e6f48.jpg
 
Last edited:
Έχεις δυνατή κάρτα γραφικών. Με το παλιό μου laptop που είχε μια 2060 RTX με 6 GB VRAM επίσης είχα ξεκολλήσει από τα μικρά μοντέλα λόγω ram. Είχα 64 GB συνολικά οπότε μπορούσα να τρέξω Mixture of Experts μοντέλα όπου ο μεγάλος όγκος πήγαινε στη ram και κατέβαζε στη VRAM μόνο τους ενεργούς.
Έχεις δοκιμάσει το LFM2.5-8B-A1B; Ίσως σου προσφέρει καλύτερα αποτελέσματα.
Να πω την αλήθεια θα δοκίμαζα και το gpt-oss-20b, ίσως οριακά χωρέσει με μοίρασμα της μνήμης. Το LM Studio το κάνει αυτόματα αυτό, δεν ξέρω με το Ollama πως γίνεται.
 
Ότι δοκίμασα με μοίρασμα μνήμης η ταχύτητα πέφτει αισθητά. Το κάνει αυτόματα το ollama . Πχ αν βάλω την ρύθμιση στα 32κ πέφτω στα 7 token/s γιατί μοιράζει το φόρτο στην cpu .

Το sweet spot ειναι τα 16k. Εκεί βέβαια έχω ένα θέμα. Ότι με το καλημερα όλα τα μικρά μοντέλα μου τρώνε 12.000 token στο thinking με ένα απλο hello ... μετα ειναι γρήγορα αλλά δεν έχεις πολλά περιθώρια. Αρχίζει να κάνει compact ...

Θα δοκιμάσω να απενεργοποιησω το thinking στο qwen . Μετά θα δοκιμάσω άλλα μοντέλα.

Είμαι δηλαδή ακόμη στο να βρω ποιο μπορεί να τρέχει σωστά πάρα να βρω τι θα κάνω με αυτό όταν τα καταφέρω...
 
Είχα δοκιμάσει πάρα πολλά 4Β μοντέλα. Ειδικά χωρίς thinking με διαφορά αυτό που είχα ξεχωρίσει και χρησιμοποιούσα στην γραμματέα μου ήταν το qwen3-4b-instruct-2507. Δοκίμασέ το και πες μου πως το βλέπεις.
 
  • Like
Reactions: songless_bird