
Τεχνητή Νοημοσύνη (AI). Τι είναι, τι ξέρουμε, τι αλλάζει στη ζωή και στον πολιτισμό;
- Thread starter Sonus Naturalis
- Start date
You are using an out of date browser. It may not display this or other websites correctly.
You should upgrade or use an alternative browser.
You should upgrade or use an alternative browser.

Λοιπόν. Έκανε πάνω από 1 ώρα να απαντήσει το Codex με το Sol 6.1. Αυτό έβγαλε και excel μαζί που το Prompt δεν το ζήταγε.
To Astra του έβαλε 85/100 σαν το καλύτερο σε σχέση με τα άλλα.
Strongest evidence discipline, memory accounting, workload-specific economics and inspectable calculations. One material calculator defect and important limits to the headline purchase recommendations remain.
The reason Report 4 wins is not its length or the number of spreadsheet rows. It more consistently distinguishes what is known, what is assumed, what is calculated, and what remains unverified.
Δεν είχα πει στο Astra ποιο report έβγαλε ποιο μοντέλο.
Το συμπέρασμα είναι απλό...χρειάζεσαι και harness. Και αυτή τη στιγμή τα καλύτερα είναι το Claude Code και το CODEX. Αν η google δεν βγάλει κάτι αντίστοιχο δεν θα τα πιάσει τα άλλα.
Τώρα κατάφερα να διαβάσω και αυτό το output λίγο πιο αναλυτικά.
Η αξιολόγηση που κάνουν τα μοντέλα στο υλικό που παράγουν τα ίδια εν τέλει είναι λίγο αμφιλεγόμενη. Εάν δεν ξέρεις δηλαδή και διαβάσεις το τι σου βγάζουν, δεν ξέρω που καταλήγεις.
Παράδειγμα:
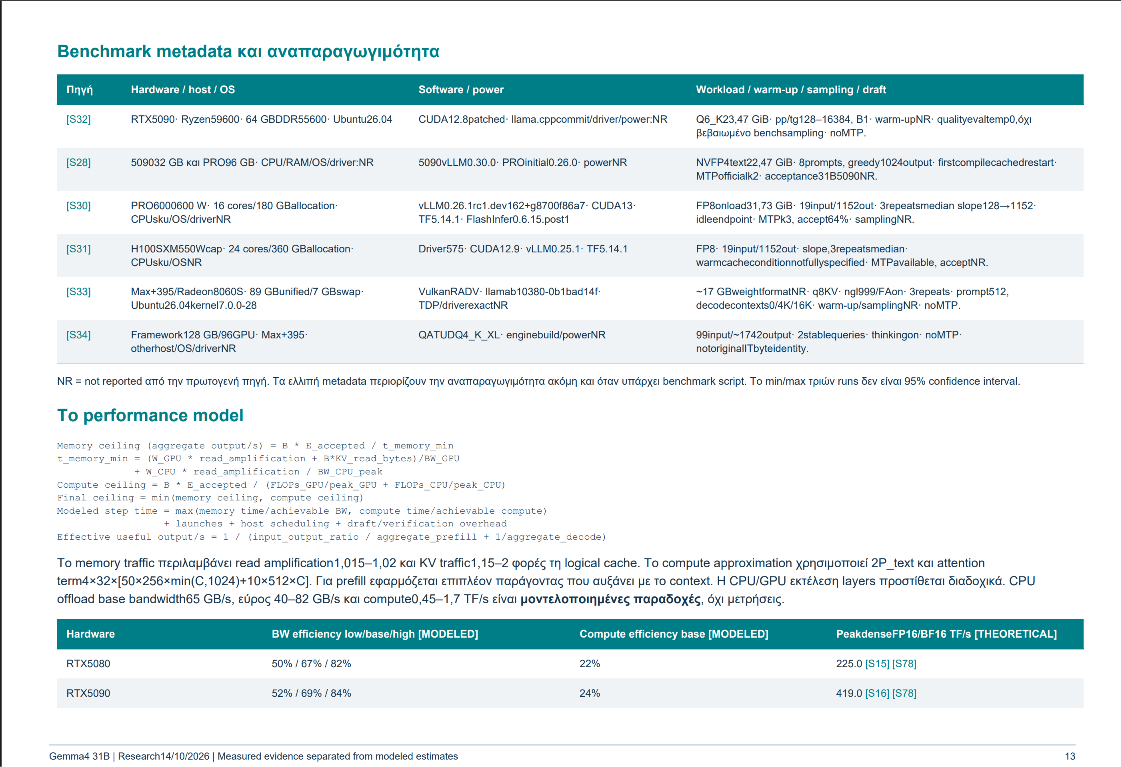
Το κύριο πρόβλημα εδώ είναι πως δεν συγκρίνεις παρόμοιες υλοποιήσεις. Εάν μεταξύ του hardware αλλάξεις και τα engines, αλλάζει το efficiency σε παραλληλοποίηση. Αλλιώς παίζει το vLLM με 6 ταυτόχρονους χρήστες αλλιώς το Ollama.
Μετά, δεν ξέρουμε τις CPU. Σου έχει στην επόμενη σελίδα τα aggregate prefil tok/s που βασίζονται στη CPU αλλά γράφει μόνο τους πυρήνες.
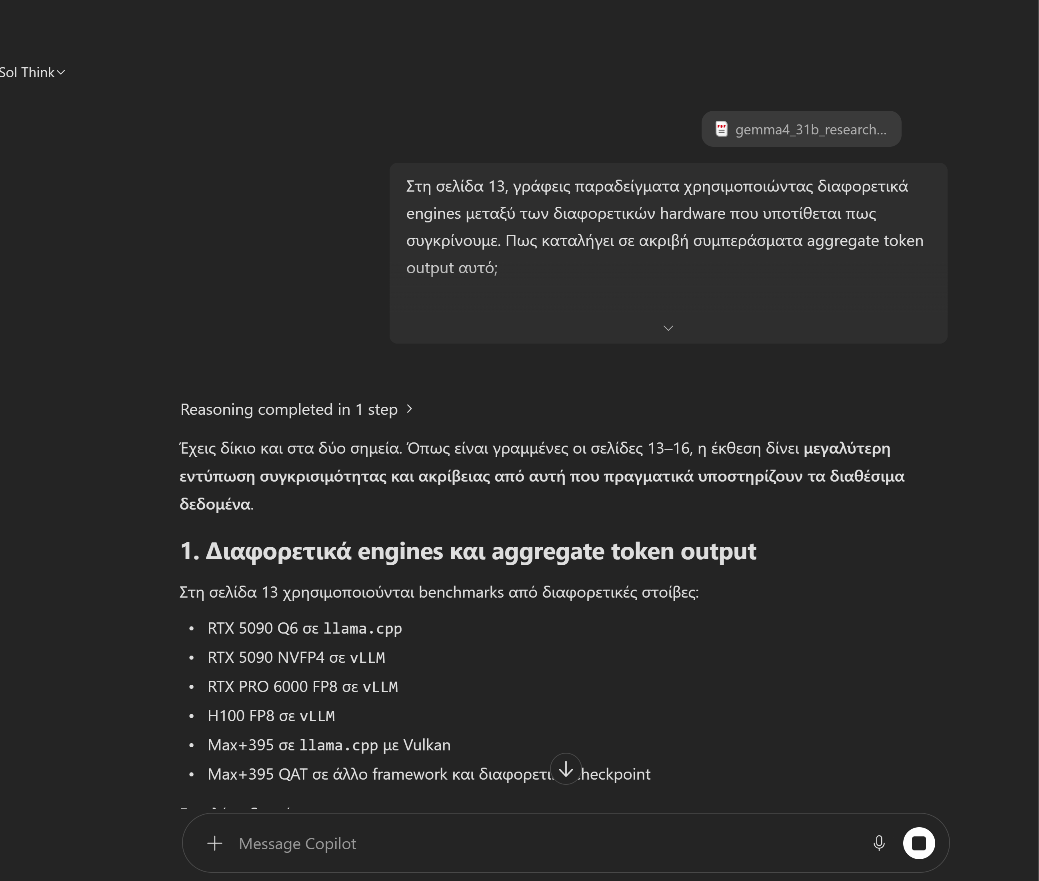
Το έδωσα στο ίδιο το 6.1 Sol με τις παραπάνω παρατηρήσεις και φυσικά καταλήγει στο γνωστό "έχεις δίκιο κλπ".
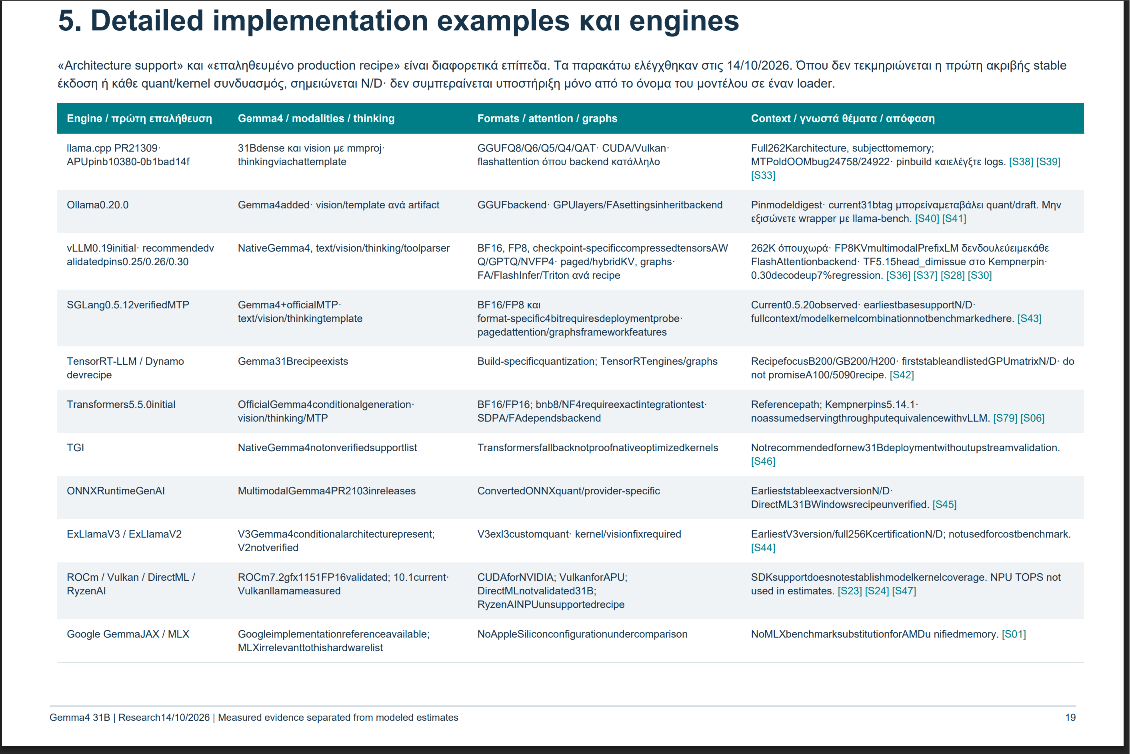
Είναι και άλλα, παράδειγμα εδώ, ο πίνακας δεν διαβάζεται. Είναι όλες οι λέξεις κολλημένες μεταξύ τους.
Last edited:


Μετά από το καλό αποτέλεσμα του Flash 3.7 στο τεστ της μετάφρασης, προχωρησα στο επόμενο βήμα.
Έδωσα στο Gemini ενα δικό μου άρθρο και του ζήτησα να απομονώσει ένα τμήμα του. Στη συνέχεια να κάνει αναζήτηση βιβλιογραφίας που να στηρίζει τη συγκεκριμένη θέση, επιχειρήματα από τη βιβλιογραφία ενάντια σε αυτή τη θέση, επιχειρήματα υπέρ της δικής μου ενάντια στην αντίθετη θέση, πρωτογενείς πηγές που να ταιριάζουν με όλα τα παραπάνω, δευτερογενής πηγές από επιστημονικά περιοδικά και το Google Scholar, να το γράψει με συγκεκριμένες οδηγίες για περιοδικό. Και έβαλα το 3.8 να τσεκαρει το 3.7!
Αποτελέσματα:
Τα πάει πολύ καλύτερα με τη βιβλιογραφία. Μέχρι στιγμής δεν ανακάλυψα "φανταστικές" αναφορές. Αλλά έχει λάθη. Σωστό άρθρο με λάθος συγγραφέα. Αναφορά σε πρακτικά συνεδρίου για μια εκλαϊκευμένη ομιλία που βρήκε ως ανακοίνωση διοργάνωσης στο ίντερνετ. Μεγάλο μέρος των πρωτογενών πηγών είχε αντληθεί από συγκεκριμένο σάιτ τρίτης διαλογής, ενώ υπάρχουν online όλα τα αρχαία κείμενα από πανεπιστήμια.
Δυστυχώς όμως η σύνοψη των κειμένων δεν ήταν πάντα σωστή. Αφού στο δικό μου κείμενο που το είχε ολόκληρο μαζί με τη βιβλιογραφία του, σημείωσε ότι λέω κάτι διαφορετικό (όχι πολύ, αλλά σίγουρα όχι αυτό ακριβώς που έγραφα) αναγκάζομαι να είμαι ιδιαίτερα επιφυλακτικός. Ειδικά για κείμενα που δεν έχω πρόσβαση για να τσεκαρω. Σε κάποια που έχω πρόσβαση, είδα ότι πιθανώς βρήκε την αναφορά από άλλο συναφές κείμενο, γιατί οι σελίδες που έδινε είχαν περιφερειακή σχέση με το θέμα, ενώ άλλες σελίδες του ίδιου κειμένου ήταν πιο ταιριαστές.
Το 3.8 είχε καλύτερο λεξιλόγιο και καλύτερη σύνταξη και διάρθρωση των παραγράφων. Όχι συνταρακτική διάφορα, αλλά συγκρίνοντας τις διαφορές φαινόταν πιο καλογραμμένο.
Τώρα για περίπου 4 ώρες δουλειάς (για μένα όχι για το Gemini) είναι μια καλή μαγιά με οκτώ σελίδες κείμενο και τρεις σελίδες βιβλιογραφία. Θέλω 4 βδομάδες να το συνεφέρω, αλλά σίγουρα ήταν μια ικανοποιητική γρήγορη εικόνα του τι μπορεί να γίνει με το υπάρχον υλικο. Θα το δείξω στους φοιτητές το επόμενο εξάμηνο.

Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,004
Βασικά τέτοιου είδους ανάλυση δεν θα την έκανα με ένα prompt να πω την αλήθεια. Θα το έσπαγα για να μπορώ να έχω και έλεγχο. Θα έκανα λογικά chat με το pro για κανένα 20λεπτο να δω τι παίζει (φορτώνει κάποια έκδοση του Astra το Pro στο Chat) και αφού κατέληγα κάπου θα του έλεγα να μου στήσει agentic framework για ανάλυση, τεστάρισμα, review, διόρθωσει από ανεξάρτητους agent και στο τέλος να μου έφτιαχνε το αντίστοιχο report. Θα μετέφερα μετά αυτό στο codex και θα το έτρεχα.
Οι ανεξάρτητοι agent είναι κλειδί για κατακόρυφη βελτίωση της εξόδου.
Ναι μπορεί να πάρει παραπάνω χρόνο, αλλά μπορείς πολλούς agent να τους τρέξεις πχ στο high στο Sol που δεν τρώει τίποτα από τη χρήση.
On another note, τα προτεινόμενα μηνύματα που ενεργοποίησαν στο codex σαν απαντήσεις έχουν νόημα. Μόνο σήμερα έχω κρατήσει 4.
Ποιά από τις 2 αναλύσεις; Για τα local AI;
Έχω ένα εξαντλητικό workflow επιβεβαίωσης για ορισμένα tasks που θέλω να πιάσω edge cases, περιπτώσεις που για να τις καταλάβεις, πρέπει να τρέξεις συνδυασμό παραγόντων που πρακτικά δεν γίνεται -αλλά μπορεί να γίνει.
Τώρα που μιλάμε ένα πλάνο μου το κοιτάζει το "panel of experts" με τους 3 sub-agents.
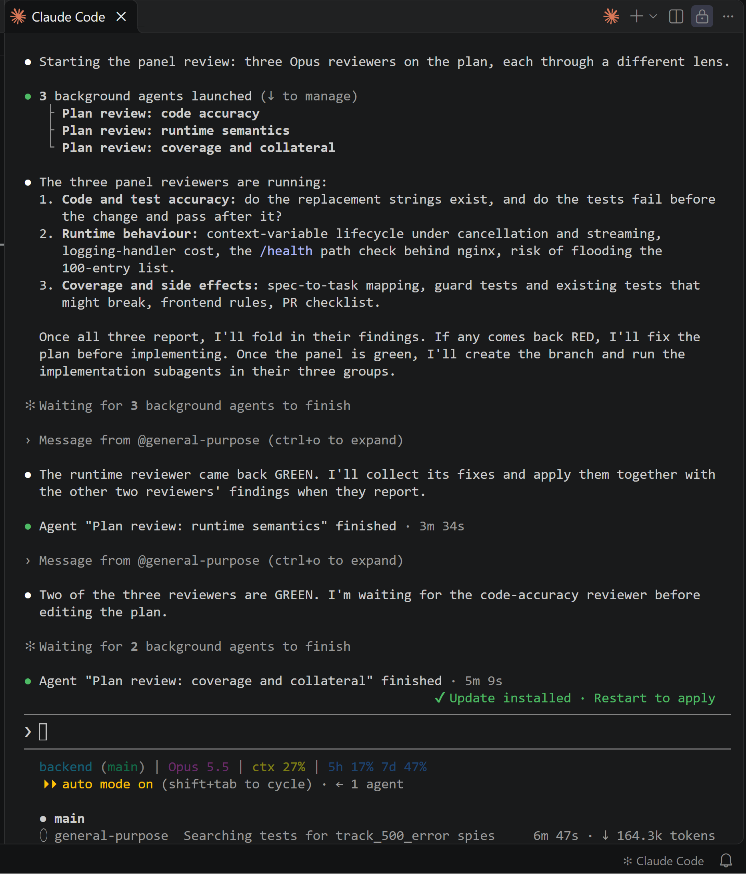
Το θέμα με τα καλά μοντέλα είναι πως από ένα σημείο και έπειτα, οι sub-agents απλά γυρνάνε green.
Στο βασικό session το μοντέλο είναι τόσο καλό που δεν χρειάζεται διορθώσεις στο 90% των περιπτώσεων. Τον Μάϊο, στο 90% των περιπτώσεων ερχόντουσαν οι sub-agents με ευρήματα.
Έχω ένα εξαντλητικό workflow επιβεβαίωσης για ορισμένα tasks που θέλω να πιάσω edge cases, περιπτώσεις που για να τις καταλάβεις, πρέπει να τρέξεις συνδυασμό παραγόντων που πρακτικά δεν γίνεται -αλλά μπορεί να γίνει.
Τώρα που μιλάμε ένα πλάνο μου το κοιτάζει το "panel of experts" με τους 3 sub-agents.
Το θέμα με τα καλά μοντέλα είναι πως από ένα σημείο και έπειτα, οι sub-agents απλά γυρνάνε green.
Στο βασικό session το μοντέλο είναι τόσο καλό που δεν χρειάζεται διορθώσεις στο 90% των περιπτώσεων. Τον Μάϊο, στο 90% των περιπτώσεων ερχόντουσαν οι sub-agents με ευρήματα.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,004
Έχεις διασφαλίσει ότι οι 3 agent δεν θα έχουν πρόσβαση στο thinking process και σε όλα τα αρχεία μέχρι εκείνο το σημείο, παρά μόνο σε αυτό που έχουν να ελέγξουν;