Τεχνητή Νοημοσύνη (AI). Τι είναι, τι ξέρουμε, τι αλλάζει στη ζωή και στον πολιτισμό;
- Thread starter Sonus Naturalis
- Start date
You are using an out of date browser. It may not display this or other websites correctly.
You should upgrade or use an alternative browser.
You should upgrade or use an alternative browser.

Λοιπόν. Έκανε πάνω από 1 ώρα να απαντήσει το Codex με το Sol 6.1. Αυτό έβγαλε και excel μαζί που το Prompt δεν το ζήταγε.
To Astra του έβαλε 85/100 σαν το καλύτερο σε σχέση με τα άλλα.
Strongest evidence discipline, memory accounting, workload-specific economics and inspectable calculations. One material calculator defect and important limits to the headline purchase recommendations remain.
The reason Report 4 wins is not its length or the number of spreadsheet rows. It more consistently distinguishes what is known, what is assumed, what is calculated, and what remains unverified.
Δεν είχα πει στο Astra ποιο report έβγαλε ποιο μοντέλο.
Το συμπέρασμα είναι απλό...χρειάζεσαι και harness. Και αυτή τη στιγμή τα καλύτερα είναι το Claude Code και το CODEX. Αν η google δεν βγάλει κάτι αντίστοιχο δεν θα τα πιάσει τα άλλα.
Τώρα κατάφερα να διαβάσω και αυτό το output λίγο πιο αναλυτικά.
Η αξιολόγηση που κάνουν τα μοντέλα στο υλικό που παράγουν τα ίδια εν τέλει είναι λίγο αμφιλεγόμενη. Εάν δεν ξέρεις δηλαδή και διαβάσεις το τι σου βγάζουν, δεν ξέρω που καταλήγεις.
Παράδειγμα:
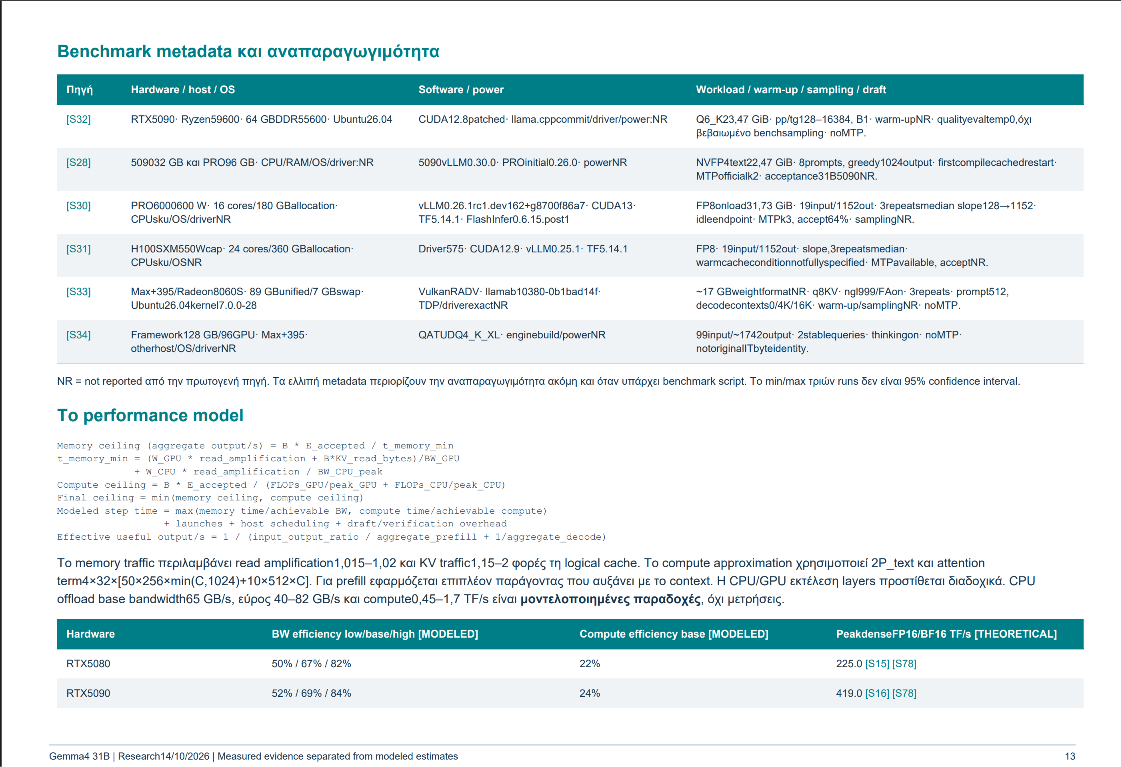
Το κύριο πρόβλημα εδώ είναι πως δεν συγκρίνεις παρόμοιες υλοποιήσεις. Εάν μεταξύ του hardware αλλάξεις και τα engines, αλλάζει το efficiency σε παραλληλοποίηση. Αλλιώς παίζει το vLLM με 6 ταυτόχρονους χρήστες αλλιώς το Ollama.
Μετά, δεν ξέρουμε τις CPU. Σου έχει στην επόμενη σελίδα τα aggregate prefil tok/s που βασίζονται στη CPU αλλά γράφει μόνο τους πυρήνες.
Το έδωσα στο ίδιο το 6.1 Sol με τις παραπάνω παρατηρήσεις και φυσικά καταλήγει στο γνωστό "έχεις δίκιο κλπ".
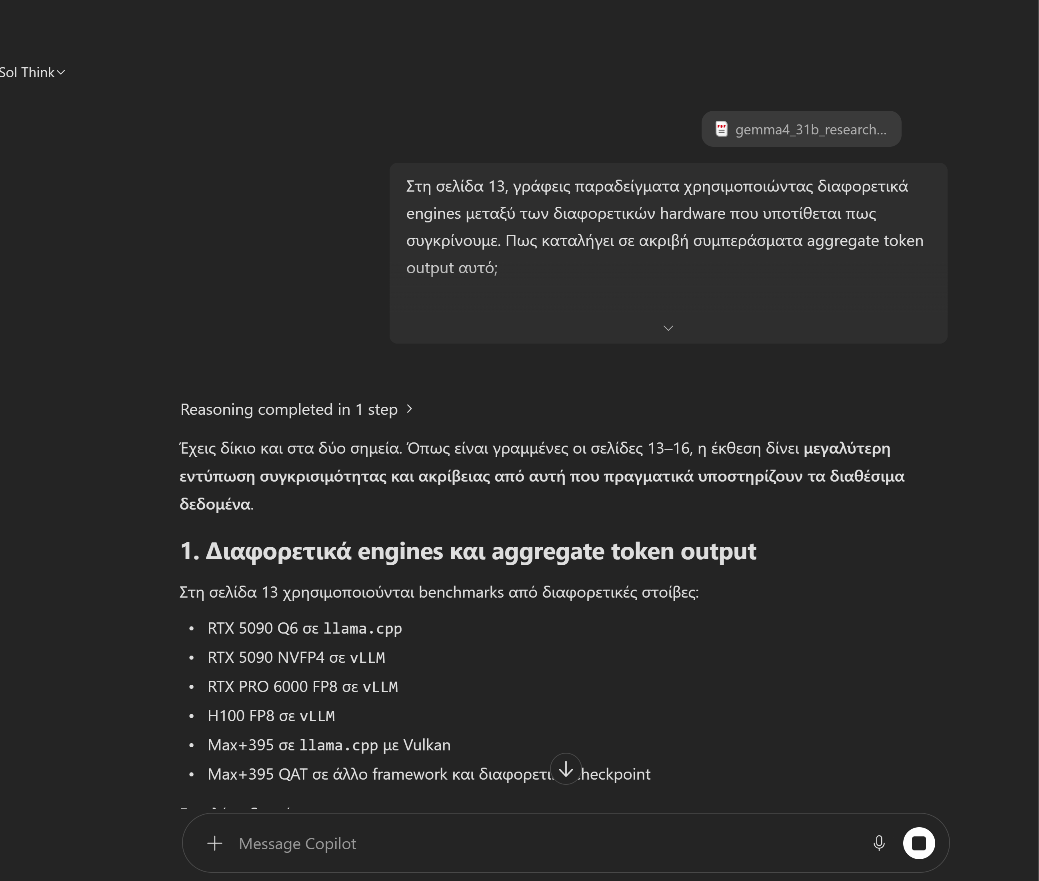
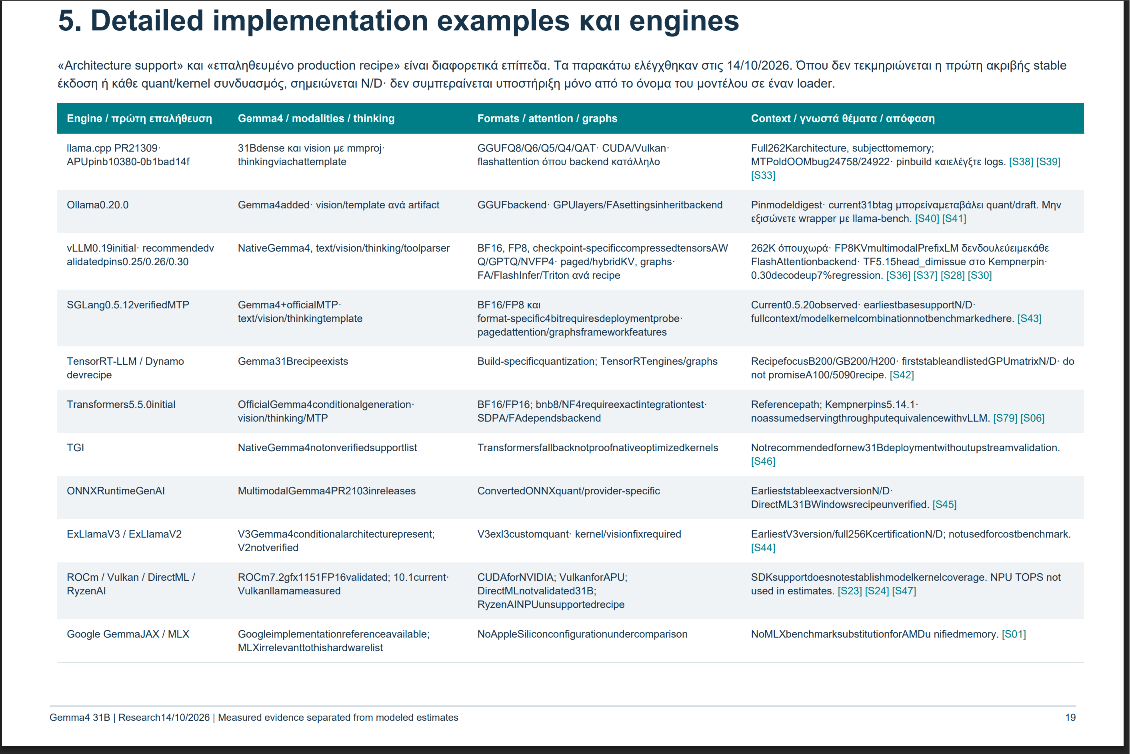
Είναι και άλλα, παράδειγμα εδώ, ο πίνακας δεν διαβάζεται. Είναι όλες οι λέξεις κολλημένες μεταξύ τους.
Last edited:


Μετά από το καλό αποτέλεσμα του Flash 3.7 στο τεστ της μετάφρασης, προχωρησα στο επόμενο βήμα.
Έδωσα στο Gemini ενα δικό μου άρθρο και του ζήτησα να απομονώσει ένα τμήμα του. Στη συνέχεια να κάνει αναζήτηση βιβλιογραφίας που να στηρίζει τη συγκεκριμένη θέση, επιχειρήματα από τη βιβλιογραφία ενάντια σε αυτή τη θέση, επιχειρήματα υπέρ της δικής μου ενάντια στην αντίθετη θέση, πρωτογενείς πηγές που να ταιριάζουν με όλα τα παραπάνω, δευτερογενής πηγές από επιστημονικά περιοδικά και το Google Scholar, να το γράψει με συγκεκριμένες οδηγίες για περιοδικό. Και έβαλα το 3.8 να τσεκαρει το 3.7!
Αποτελέσματα:
Τα πάει πολύ καλύτερα με τη βιβλιογραφία. Μέχρι στιγμής δεν ανακάλυψα "φανταστικές" αναφορές. Αλλά έχει λάθη. Σωστό άρθρο με λάθος συγγραφέα. Αναφορά σε πρακτικά συνεδρίου για μια εκλαϊκευμένη ομιλία που βρήκε ως ανακοίνωση διοργάνωσης στο ίντερνετ. Μεγάλο μέρος των πρωτογενών πηγών είχε αντληθεί από συγκεκριμένο σάιτ τρίτης διαλογής, ενώ υπάρχουν online όλα τα αρχαία κείμενα από πανεπιστήμια.
Δυστυχώς όμως η σύνοψη των κειμένων δεν ήταν πάντα σωστή. Αφού στο δικό μου κείμενο που το είχε ολόκληρο μαζί με τη βιβλιογραφία του, σημείωσε ότι λέω κάτι διαφορετικό (όχι πολύ, αλλά σίγουρα όχι αυτό ακριβώς που έγραφα) αναγκάζομαι να είμαι ιδιαίτερα επιφυλακτικός. Ειδικά για κείμενα που δεν έχω πρόσβαση για να τσεκαρω. Σε κάποια που έχω πρόσβαση, είδα ότι πιθανώς βρήκε την αναφορά από άλλο συναφές κείμενο, γιατί οι σελίδες που έδινε είχαν περιφερειακή σχέση με το θέμα, ενώ άλλες σελίδες του ίδιου κειμένου ήταν πιο ταιριαστές.
Το 3.8 είχε καλύτερο λεξιλόγιο και καλύτερη σύνταξη και διάρθρωση των παραγράφων. Όχι συνταρακτική διάφορα, αλλά συγκρίνοντας τις διαφορές φαινόταν πιο καλογραμμένο.
Τώρα για περίπου 4 ώρες δουλειάς (για μένα όχι για το Gemini) είναι μια καλή μαγιά με οκτώ σελίδες κείμενο και τρεις σελίδες βιβλιογραφία. Θέλω 4 βδομάδες να το συνεφέρω, αλλά σίγουρα ήταν μια ικανοποιητική γρήγορη εικόνα του τι μπορεί να γίνει με το υπάρχον υλικο. Θα το δείξω στους φοιτητές το επόμενο εξάμηνο.

Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,009
Βασικά τέτοιου είδους ανάλυση δεν θα την έκανα με ένα prompt να πω την αλήθεια. Θα το έσπαγα για να μπορώ να έχω και έλεγχο. Θα έκανα λογικά chat με το pro για κανένα 20λεπτο να δω τι παίζει (φορτώνει κάποια έκδοση του Astra το Pro στο Chat) και αφού κατέληγα κάπου θα του έλεγα να μου στήσει agentic framework για ανάλυση, τεστάρισμα, review, διόρθωσει από ανεξάρτητους agent και στο τέλος να μου έφτιαχνε το αντίστοιχο report. Θα μετέφερα μετά αυτό στο codex και θα το έτρεχα.
Οι ανεξάρτητοι agent είναι κλειδί για κατακόρυφη βελτίωση της εξόδου.
Ναι μπορεί να πάρει παραπάνω χρόνο, αλλά μπορείς πολλούς agent να τους τρέξεις πχ στο high στο Sol που δεν τρώει τίποτα από τη χρήση.
On another note, τα προτεινόμενα μηνύματα που ενεργοποίησαν στο codex σαν απαντήσεις έχουν νόημα. Μόνο σήμερα έχω κρατήσει 4.
Ποιά από τις 2 αναλύσεις; Για τα local AI;
Έχω ένα εξαντλητικό workflow επιβεβαίωσης για ορισμένα tasks που θέλω να πιάσω edge cases, περιπτώσεις που για να τις καταλάβεις, πρέπει να τρέξεις συνδυασμό παραγόντων που πρακτικά δεν γίνεται -αλλά μπορεί να γίνει.
Τώρα που μιλάμε ένα πλάνο μου το κοιτάζει το "panel of experts" με τους 3 sub-agents.
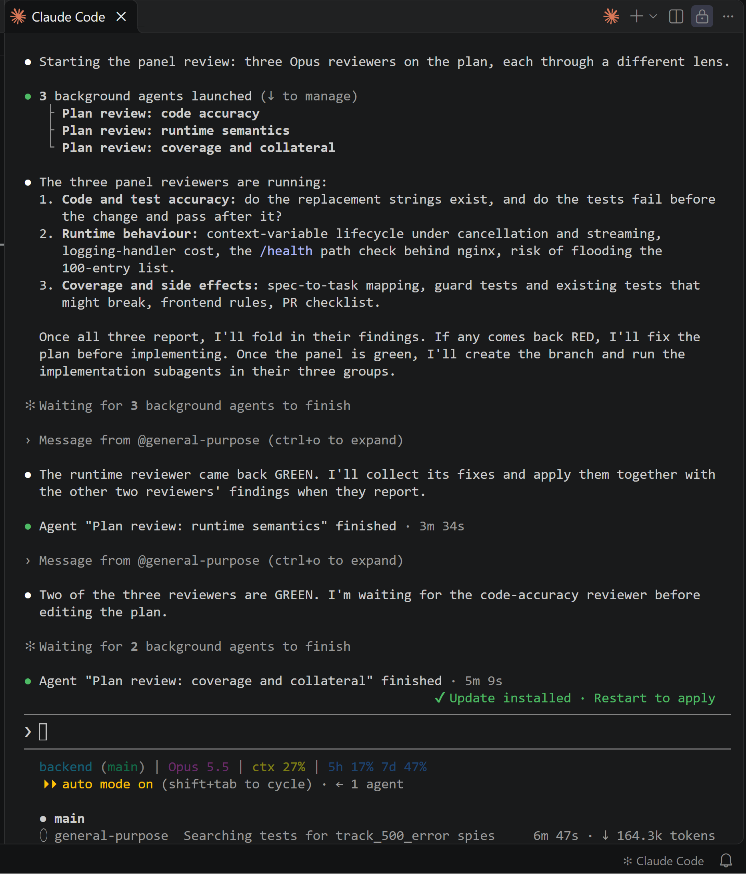
Το θέμα με τα καλά μοντέλα είναι πως από ένα σημείο και έπειτα, οι sub-agents απλά γυρνάνε green.
Στο βασικό session το μοντέλο είναι τόσο καλό που δεν χρειάζεται διορθώσεις στο 90% των περιπτώσεων. Τον Μάϊο, στο 90% των περιπτώσεων ερχόντουσαν οι sub-agents με ευρήματα.
Έχω ένα εξαντλητικό workflow επιβεβαίωσης για ορισμένα tasks που θέλω να πιάσω edge cases, περιπτώσεις που για να τις καταλάβεις, πρέπει να τρέξεις συνδυασμό παραγόντων που πρακτικά δεν γίνεται -αλλά μπορεί να γίνει.
Τώρα που μιλάμε ένα πλάνο μου το κοιτάζει το "panel of experts" με τους 3 sub-agents.
Το θέμα με τα καλά μοντέλα είναι πως από ένα σημείο και έπειτα, οι sub-agents απλά γυρνάνε green.
Στο βασικό session το μοντέλο είναι τόσο καλό που δεν χρειάζεται διορθώσεις στο 90% των περιπτώσεων. Τον Μάϊο, στο 90% των περιπτώσεων ερχόντουσαν οι sub-agents με ευρήματα.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,009
Έχεις διασφαλίσει ότι οι 3 agent δεν θα έχουν πρόσβαση στο thinking process και σε όλα τα αρχεία μέχρι εκείνο το σημείο, παρά μόνο σε αυτό που έχουν να ελέγξουν;
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,009
Μην το λες...στο CODEX μέσω GUΙ μέχρι πριν λίγο καιρό δεν μπορούσες. Μέσω CLI γινόταν. Όμως και πάλι όταν έχεις ένα workspace δεν είσαι ποτέ σίγουρος ότι δεν θα δει μέσα στο workspace αρχεία κλπ. Μέσω πολλαπλών agents.md υποτίθεται ότι το λύνεις αυτό και περιορίζεις τους sub-agent τουλάχιστον σε συγκεκριμένα sub-directories . Για κάποιο λόγο όμως, εκ του αποτελέσματος όταν έκανα το adversarial review σε άλλο project στο codex το αποτέλεσμα για κάποιο λόγο ήταν πάντα καλύτερο αντικειμενικά. Δεν ξέρω αν ήταν bias, ανάγνωση αρχείων, bug της υλοποίησης ή ότι δεν υπήρχε πλήρης απομόνωση των agent. Ακόμη το κάνω χειροκίνητα σε νέο project.Προφανώς.
Ο orchestrator τους δίνει το prompt, επί τούτου χωρίς να έχουν γνώση του τι έχει προηγηθεί.
Context sharing δεν νομίζω πως γίνεται και να το θέλεις, τεχνικά.
Και το αστείο το fact checking το ανεξάρτητο δεν είχε ουσιαστικές διαφορές είτε στο ίδιο είτε σε άλλο project, ακόμη και αν του έλεγα να μην λάβει υπόψη εσωτερική βιβλιογραφία και να το δει ανεξάρτητα μόνο από δημόσιες πηγές στο internet.
Υπάρχει πάντως θέμα με την επιστημονική βιβλιογραφία που δεν είναι Open Access, εκεί η μόνη λύση που δουλεύει τέλεια (αλλά αργά) προς το παρόν είναι χρήση browser από το codex και μέσω vpn σύνδεση που προσφέρει τα άρθρα ανοικτά χωρίς να χρειάζεται να κάνεις Login κλπ. Είχα στήσει και τα API που προσφέρουν elsevier / springer / willey, αλλά εκ του αποτελέσματος δεν δούλεψε ποτέ πλήρως σωστά.
Χθες ξεκίνησα μια δοκιμαστική pro συνδρομή του Claude.
Η βασική του χρήση, στην οποία δεν με καλύπτουν τα άλλα πληρωμένα LLM που έχω, είναι η σύνδεσή του με IDE για ανάπτυξη και troubleshooting σε κάποια software projects που τρέχω αυτή την εποχή, κυρίως FPGA related. Όλα για το χόμπι, ως συνήθως.
Είχα ένα συγκεκριμένο πρόβλημα σε ένα από αυτά που και ο Copilot (6.1 Sol) και ο Gemini (3.1 Pro, 3.5 Thinking) έφαγαν τα μούτρα τους.
Έφαγα αρκετές ώρες με troubleshooting, signaltap, κτλ κτλ χωρίς αποτέλεσμα.
Ο Claude (Opus 5.5 με medium effort) το βρήκε μέσα σε λίγα λεπτά, χωρίς να μου ζητήσει να κάνω κανένα πείραμα ή δοκιμή.
Απλά του είπα αυτός είναι ο κώδικας, αυτή η λειτουργικότητα δεν δουλεύει σωστά, και απλά το βρήκε και το έφτιαξε, εγώ έκανα ένα compile και upload και τέλος.
Μαγεία.
Αν είσαι developer το θεωρώ μονόδρομο αυτή τη στιγμή, ειδικά τη στιγμή που με ~20€ το μήνα έχεις integration με IDEs, κάτι που καμία άλλη πληρωμένη συνδρομή δεν υποστηρίζει αυτή τη στιγμή (με τόσο χαμηλό κόστος).
Επίσης, έχουν φτιάξει το πρόβλημα που υπήρχε με το consumption. Πριν λίγους μήνες που το είχα ξαναδοκιμάσει, για ένα παρόμοιο troubleshooting είχε φάει σχεδόν το 25% του allowance της εβδομάδας. Χθες έκαψε μόλις το 1%.

Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,009
IDE integration δίνει από τη 10ευρη συνδρομή η OpenAI. Στην 20ευρη που είναι και η πιο συνηθισμένη δουλεύει μια χαρά.Χθες ξεκίνησα μια δοκιμαστική pro συνδρομή του Claude.
Η βασική του χρήση, στην οποία δεν με καλύπτουν τα άλλα πληρωμένα LLM που έχω, είναι η σύνδεσή του με IDE για ανάπτυξη και troubleshooting σε κάποια software projects που τρέχω αυτή την εποχή, κυρίως FPGA related. Όλα για το χόμπι, ως συνήθως.
Είχα ένα συγκεκριμένο πρόβλημα σε ένα από αυτά που και ο Copilot (6.1 Sol) και ο Gemini (3.1 Pro, 3.5 Thinking) έφαγαν τα μούτρα τους.
Έφαγα αρκετές ώρες με troubleshooting, signaltap, κτλ κτλ χωρίς αποτέλεσμα.
Ο Claude (Opus 5.5 με medium effort) το βρήκε μέσα σε λίγα λεπτά, χωρίς να μου ζητήσει να κάνω κανένα πείραμα ή δοκιμή.
Απλά του είπα αυτός είναι ο κώδικας, αυτή η λειτουργικότητα δεν δουλεύει σωστά, και απλά το βρήκε και το έφτιαξε, εγώ έκανα ένα compile και upload και τέλος.
Μαγεία.
Αν είσαι developer το θεωρώ μονόδρομο αυτή τη στιγμή, ειδικά τη στιγμή που με ~20€ το μήνα έχεις integration με IDEs, κάτι που καμία άλλη πληρωμένη συνδρομή δεν υποστηρίζει αυτή τη στιγμή (με τόσο χαμηλό κόστος).
Επίσης, έχουν φτιάξει το πρόβλημα που υπήρχε με το consumption. Πριν λίγους μήνες που το είχα ξαναδοκιμάσει, για ένα παρόμοιο troubleshooting είχε φάει σχεδόν το 25% του allowance της εβδομάδας. Χθες έκαψε μόλις το 1%.
Πάντως ο τρόπος που δούλεψες είναι ο πιο σωστός. Τρέχεις το πιο "έξυπνο" μοντέλο για αξιολόγηση/σχεδιασμό και βάζεις μετά τα αρκετά έξυπνα αλλά φθηνότερα να κάνουν τη δουλειά.
Αν σου φαίνεται πάντως ότι κατεβαίνει αργά το usage στην OpenAI δουλεύω agents σχεδόν 24ωρο και δεν έχω μείνει με όλα τα reset που προσφέρουν.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,009
Να συμπληρώσω βέβαια ότι την τελευταία εβδομάδα υπάρχουν πάρα πολλές αναφορές στο reddit ιδιαίτερα ότι η OpenAI προχώρησε σε Nerfing κυρίως του Sol 6.1. Αναμενόμενο εν μέρει γιατί με τα συχνά reset όλοι τα χρησιμοποιούν περισσότερο. Να πω την αλήθεια, δεν έχω πέσει κάτω από το "Extra Thinking" και πολλές φορές βάζω το Max.
Από την πλευρά της η OpenAI έχει αναγνωρίσει ότι τα μοντέλα είχαν μειωμένη απόδοση στις 13 και 14 Οκτωβρίου.
Υ.Γ. Ο όρος «nerfing» αναφέρεται στη σκόπιμη ή μη υποβάθμιση των δυνατοτήτων, της απόδοσης ή της λειτουργικής ελευθερίας ενός LLM, σε σύγκριση με προηγούμενη έκδοσή του ή με τις αρχικές τεχνικές του δυνατότητες.
Ο όρος nerfing προέρχεται από τη βιομηχανία των βιντεοπαιχνιδιών, όπου περιγράφει τη μείωση της ισχύος ενός χαρακτήρα ή όπλου, συνήθως για λόγους εξισορρόπησης.
Τις περισσότερες φορές, οι αναφορές για "nerfing" είναι αβάσιμες.
Τα γράφει κόσμος που δεν έχει ιδέα, αποκλειστικά για το "hype". Δηλαδή τι να κάνουν; Να αλλάξει η αρχιτεκτονική του μοντέλου με λιγότερες ενεργές παραμέτρους; Να αλλάξει το quantization μειώνοντας την ακρίβεια;
Ένα οποιοδήποτε ανοιχτό benchmark θα το δείξει σε δεύτερο checkpoint και το lab θα γίνει ρεζίλι. Την επόμενη ημέρα θα χάσει τους μισούς πελάτες στο API.
Αχ και παιδεύεσαι τσάμπα
Από τη βασική εφαρμογή του claude πλέον έχει μπεί και το orchestration layer. Μπορείς αν ανοίξεις ένα project, μιλάς μόνο με τον orchestrator και εκείνος κάνει ότι πιστεύει, σηκώνει cloud sessions (σε δικό τους VM), sub-agents στο κάθε session κλπ.
Στη δική μου περίπτωση, έχει στη μνήμη του το workflow επιβεβαίωσης-κάψιμο tokens που θέλω και απλά δουλεύει.
Τα γράφει κόσμος που δεν έχει ιδέα, αποκλειστικά για το "hype". Δηλαδή τι να κάνουν; Να αλλάξει η αρχιτεκτονική του μοντέλου με λιγότερες ενεργές παραμέτρους; Να αλλάξει το quantization μειώνοντας την ακρίβεια;
Ένα οποιοδήποτε ανοιχτό benchmark θα το δείξει σε δεύτερο checkpoint και το lab θα γίνει ρεζίλι. Την επόμενη ημέρα θα χάσει τους μισούς πελάτες στο API.
Μην το λες...στο CODEX μέσω GUΙ μέχρι πριν λίγο καιρό δεν μπορούσες. Μέσω CLI γινόταν. Όμως και πάλι όταν έχεις ένα workspace δεν είσαι ποτέ σίγουρος ότι δεν θα δει μέσα στο workspace αρχεία κλπ. Μέσω πολλαπλών agents.md υποτίθεται ότι το λύνεις αυτό και περιορίζεις τους sub-agent τουλάχιστον σε συγκεκριμένα sub-directories . Για κάποιο λόγο όμως, εκ του αποτελέσματος όταν έκανα το adversarial review σε άλλο project στο codex το αποτέλεσμα για κάποιο λόγο ήταν πάντα καλύτερο αντικειμενικά. Δεν ξέρω αν ήταν bias, ανάγνωση αρχείων, bug της υλοποίησης ή ότι δεν υπήρχε πλήρης απομόνωση των agent. Ακόμη το κάνω χειροκίνητα σε νέο project.
Και το αστείο το fact checking το ανεξάρτητο δεν είχε ουσιαστικές διαφορές είτε στο ίδιο είτε σε άλλο project, ακόμη και αν του έλεγα να μην λάβει υπόψη εσωτερική βιβλιογραφία και να το δει ανεξάρτητα μόνο από δημόσιες πηγές στο internet.
Υπάρχει πάντως θέμα με την επιστημονική βιβλιογραφία που δεν είναι Open Access, εκεί η μόνη λύση που δουλεύει τέλεια (αλλά αργά) προς το παρόν είναι χρήση browser από το codex και μέσω vpn σύνδεση που προσφέρει τα άρθρα ανοικτά χωρίς να χρειάζεται να κάνεις Login κλπ. Είχα στήσει και τα API που προσφέρουν elsevier / springer / willey, αλλά εκ του αποτελέσματος δεν δούλεψε ποτέ πλήρως σωστά.
Αχ και παιδεύεσαι τσάμπα
Από τη βασική εφαρμογή του claude πλέον έχει μπεί και το orchestration layer. Μπορείς αν ανοίξεις ένα project, μιλάς μόνο με τον orchestrator και εκείνος κάνει ότι πιστεύει, σηκώνει cloud sessions (σε δικό τους VM), sub-agents στο κάθε session κλπ.
Στη δική μου περίπτωση, έχει στη μνήμη του το workflow επιβεβαίωσης-κάψιμο tokens που θέλω και απλά δουλεύει.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,009
Ένα από τα βασικά workflows που χρειάζομαι είναι η υλοποίηση adversarial review κειμένων που φτιάχνω. Για να γίνει αυτό πρέπει να υπάρχει απομόνωση της αξιολόγησης από τη δημιουργία.
Κοίτα ουσιαστικά υπάρχουν 3 επίπεδα απομόνωσης:
1. Απομόνωση της συζήτησης που στην ουσία αφορά το να βλέπει προηγούμενες συζητήσεις, αποφάσεις, επιχειρήματα και συμπεράσματα. Αυτή η απομόνωση χρειάζεται ώστε ο πράκτορας να μην υιοθετήσει την δική μου λογική προσέγγιση.
2. Απομόνωση στο file system. Αυτό αφορά οποιοδήποτε άλλο αρχείο έχω μοιραστεί με το workspace ή έχουν ήδη φτιαχτεί και αποθηκευτεί εκεί. Αυτό αποτρέπει προηγούμενα αρχεία να επηρεάσουν το αποτέλεσμα.
3. Απομόνωση στις οδηγίες. Αυτό έχει να κάνει με την υιοθέτηση οδηγιών που έχουν δωθεί για το συνολικό έργο, skills που έχουν ενεργοποιηθεί και προφανώς παραδοχές. Αυτό αποτρέπει τους reviewers να υιοθετούν τα ίδια biases που διαμορφώθηκαν κατά την ανάπτυξη στην ανάλυση.
Να πω την αλήθεια τα παραπάνω τα υλοποιούσα χειροκίνητα από την εποχή του ChatGPT 4.x, έχοντας απενεργοποιημένες τις μνήμες, θεωρώντας κάθε νέο chat ως έναν διακριτό agent και με εμένα να κάνω χειροκίνητα το orchestration.
Σε πολλές φάσεις θέλησα να το αυτοματοποιήσω, αν και να πω την αλήθεια ίσως είναι καλύτερο να έχω μια επαφή πριν το τελικό αποτέλεσμα σαν quality control με λίγο χέριασμα 1-2 φορές στη διάρκεια του workflow: Δημιουργία - Αξιολόγηση - Βελτίωση βάσει της αξιολόγησης.
Στην OpenAI για να πετύχεις αυτοματοποιημένα και τα 3 επίπεδα της απομόνωσης χρειάζεται να χρησιμοποιήσεις είτε το API είτε το SDK.
Όμως, κάτι αντίστοιχο ισχύει και με την Anthropic. Στην ουσία για να πετύχεις τα 3 επίπεδα απομόνωσης χρειάζεται ο κάθε Agent να βρίσκεται σε καινούργιο sandbox και φυσικά να μπορεί να γίνει μετά consolidation των διαφορετικών αποτελεσμάτων που έχουν παραχθεί σε διαφορετικά sandboxes. Και αυτό δεν μπορεί να γίνει ούτε από το GUI της Anthropic, είσαι υποχρεωμένος και εκεί να παίξεις με API/SDK, δεν προσφέρεται άμεσα.
Κοινώς δεν υπάρχει λύση απευθείας από GUI σε καμία από τις 2 εταιρίες. Και στις 2 μπορείς να πετύχεις πλήρη αυτοματοποίηση μέσω API/SDK ή με περισσότερα χεράτα βήματα μέσω GUI.
Θα το πάω από κάτω προς τα πάνω.
Υπάρχει, τα projects. Αυτό που έγραψα παραπάνω.
Κάθε session που ανοίγει, ανοίγει σε ξεχωριστό cloud VM, με νέο provisioning. Όχι local sandboxes. Μπορείς να έχεις όσα session θέλεις το καθένα σε δικό του μηχάνημα.
Ακόμη και σε πρωτογενή δουλειά, χωρίς να έχουν πρόσβαση πουθενά, εάν το δηλώσεις, τους κόβει ο auto mode classifier ακόμη και το read access των αρχείων στον φάκελο που έχεις το project σου.
Consolidation δεν χρειάζεται να κάνεις μόνος σου, το κάνει ο orchestrator.
Πρίν από ένα χρόνο, έπρεπε να γράφεις σωστά prompts και να είσαι και από πάνω σε όλη τη διαδικασία, βήμα προς βήμα.
Πριν από 6 μήνες, άρχισαν να ελέγχουν το αποτέλεσμα σοβαρά, χωρίς να χρειάζεται το ντάντεμα.
Σήμερα, δεν χρειάζεται ούτε να κάτσεις να δομήσεις το prompt. Παίρνεις καλύτερο αποτέλεσμα με ένα ελεύθερο dictation.
1. Ανάλογα το project το οποίο δουλεύεις. Εάν κάνεις software engineering και του κόψεις τη πρόσβαση στο φάκελο του project, τι σόι review θα κάνει; Ο sub-agent δεν μοιράζεται το context με το βασικό session. Το βασικό session πάει και του γράφει ένα prompt. Εκεί μπορείς να ζητήσεις το prompt που θα του δώσει να μην μοιραστεί τίποτα από το βασικό session. Πλέον δεν κάνω ούτε αυτό. Εάν το μοντέλο θεωρεί πως κάνεις λάθος, σου το λέει.
2. Δεν χρειάζεται, auto mode classifier εάν το θέλεις οπωσδήποτε. Συνήθως, ακόμη και στις εργασίες της δουλειάς, τους επιτρέπω να έχουν πρόσβαση στα αρχεία του εκάστοτε project. Εκτός και εάν πρόκειται για πρωτογενή έρευνα δεν καταλαβαίνω πως η μη-πρόσβαση θα οδηγήσει σε καλύτερα αποτελέσματα.
3. By default δηλαδή το codex μεταφέρει bias στους sub-agents; Άνοιξα τώρα το prompt που έδωσε το Opus 5.5 από το βασικό session σε έναν code-review sub-agent και δεν έχει κανένα bias ούτε περιλαμβάνει μέρος της κεντρικής συζήτησης.
Όμως, κάτι αντίστοιχο ισχύει και με την Anthropic. Στην ουσία για να πετύχεις τα 3 επίπεδα απομόνωσης χρειάζεται ο κάθε Agent να βρίσκεται σε καινούργιο sandbox και φυσικά να μπορεί να γίνει μετά consolidation των διαφορετικών αποτελεσμάτων που έχουν παραχθεί σε διαφορετικά sandboxes. Και αυτό δεν μπορεί να γίνει ούτε από το GUI της Anthropic, είσαι υποχρεωμένος και εκεί να παίξεις με API/SDK, δεν προσφέρεται άμεσα.
Κοινώς δεν υπάρχει λύση απευθείας από GUI σε καμία από τις 2 εταιρίες. Και στις 2 μπορείς να πετύχεις πλήρη αυτοματοποίηση μέσω API/SDK ή με περισσότερα χεράτα βήματα μέσω GUI.
Υπάρχει, τα projects. Αυτό που έγραψα παραπάνω.
Κάθε session που ανοίγει, ανοίγει σε ξεχωριστό cloud VM, με νέο provisioning. Όχι local sandboxes. Μπορείς να έχεις όσα session θέλεις το καθένα σε δικό του μηχάνημα.
Ακόμη και σε πρωτογενή δουλειά, χωρίς να έχουν πρόσβαση πουθενά, εάν το δηλώσεις, τους κόβει ο auto mode classifier ακόμη και το read access των αρχείων στον φάκελο που έχεις το project σου.
Consolidation δεν χρειάζεται να κάνεις μόνος σου, το κάνει ο orchestrator.
Σε πολλές φάσεις θέλησα να το αυτοματοποιήσω, αν και να πω την αλήθεια ίσως είναι καλύτερο να έχω μια επαφή πριν το τελικό αποτέλεσμα σαν quality control με λίγο χέριασμα 1-2 φορές στη διάρκεια του workflow: Δημιουργία - Αξιολόγηση - Βελτίωση βάσει της αξιολόγησης.
Στην OpenAI για να πετύχεις αυτοματοποιημένα και τα 3 επίπεδα της απομόνωσης χρειάζεται να χρησιμοποιήσεις είτε το API είτε το SDK.
Πρίν από ένα χρόνο, έπρεπε να γράφεις σωστά prompts και να είσαι και από πάνω σε όλη τη διαδικασία, βήμα προς βήμα.
Πριν από 6 μήνες, άρχισαν να ελέγχουν το αποτέλεσμα σοβαρά, χωρίς να χρειάζεται το ντάντεμα.
Σήμερα, δεν χρειάζεται ούτε να κάτσεις να δομήσεις το prompt. Παίρνεις καλύτερο αποτέλεσμα με ένα ελεύθερο dictation.
Ένα από τα βασικά workflows που χρειάζομαι είναι η υλοποίηση adversarial review κειμένων που φτιάχνω. Για να γίνει αυτό πρέπει να υπάρχει απομόνωση της αξιολόγησης από τη δημιουργία.
Κοίτα ουσιαστικά υπάρχουν 3 επίπεδα απομόνωσης:
1. Απομόνωση της συζήτησης που στην ουσία αφορά το να βλέπει προηγούμενες συζητήσεις, αποφάσεις, επιχειρήματα και συμπεράσματα. Αυτή η απομόνωση χρειάζεται ώστε ο πράκτορας να μην υιοθετήσει την δική μου λογική προσέγγιση.
2. Απομόνωση στο file system. Αυτό αφορά οποιοδήποτε άλλο αρχείο έχω μοιραστεί με το workspace ή έχουν ήδη φτιαχτεί και αποθηκευτεί εκεί. Αυτό αποτρέπει προηγούμενα αρχεία να επηρεάσουν το αποτέλεσμα.
3. Απομόνωση στις οδηγίες. Αυτό έχει να κάνει με την υιοθέτηση οδηγιών που έχουν δωθεί για το συνολικό έργο, skills που έχουν ενεργοποιηθεί και προφανώς παραδοχές. Αυτό αποτρέπει τους reviewers να υιοθετούν τα ίδια biases που διαμορφώθηκαν κατά την ανάπτυξη στην ανάλυση.
Να πω την αλήθεια τα παραπάνω τα υλοποιούσα χειροκίνητα από την εποχή του ChatGPT 4.x, έχοντας απενεργοποιημένες τις μνήμες, θεωρώντας κάθε νέο chat ως έναν διακριτό agent και με εμένα να κάνω χειροκίνητα το orchestration.
1. Ανάλογα το project το οποίο δουλεύεις. Εάν κάνεις software engineering και του κόψεις τη πρόσβαση στο φάκελο του project, τι σόι review θα κάνει; Ο sub-agent δεν μοιράζεται το context με το βασικό session. Το βασικό session πάει και του γράφει ένα prompt. Εκεί μπορείς να ζητήσεις το prompt που θα του δώσει να μην μοιραστεί τίποτα από το βασικό session. Πλέον δεν κάνω ούτε αυτό. Εάν το μοντέλο θεωρεί πως κάνεις λάθος, σου το λέει.
2. Δεν χρειάζεται, auto mode classifier εάν το θέλεις οπωσδήποτε. Συνήθως, ακόμη και στις εργασίες της δουλειάς, τους επιτρέπω να έχουν πρόσβαση στα αρχεία του εκάστοτε project. Εκτός και εάν πρόκειται για πρωτογενή έρευνα δεν καταλαβαίνω πως η μη-πρόσβαση θα οδηγήσει σε καλύτερα αποτελέσματα.
3. By default δηλαδή το codex μεταφέρει bias στους sub-agents; Άνοιξα τώρα το prompt που έδωσε το Opus 5.5 από το βασικό session σε έναν code-review sub-agent και δεν έχει κανένα bias ούτε περιλαμβάνει μέρος της κεντρικής συζήτησης.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,009
Προσωπικά δεν χρησιμοποιώ αυτά τα εργαλεία για coding/software engineering...Θα το πάω από κάτω προς τα πάνω.
Υπάρχει, τα projects. Αυτό που έγραψα παραπάνω.
Κάθε session που ανοίγει, ανοίγει σε ξεχωριστό cloud VM, με νέο provisioning. Όχι local sandboxes. Μπορείς να έχεις όσα session θέλεις το καθένα σε δικό του μηχάνημα.
Ακόμη και σε πρωτογενή δουλειά, χωρίς να έχουν πρόσβαση πουθενά, εάν το δηλώσεις, τους κόβει ο auto mode classifier ακόμη και το read access των αρχείων στον φάκελο που έχεις το project σου.
Consolidation δεν χρειάζεται να κάνεις μόνος σου, το κάνει ο orchestrator.
Πρίν από ένα χρόνο, έπρεπε να γράφεις σωστά prompts και να είσαι και από πάνω σε όλη τη διαδικασία, βήμα προς βήμα.
Πριν από 6 μήνες, άρχισαν να ελέγχουν το αποτέλεσμα σοβαρά, χωρίς να χρειάζεται το ντάντεμα.
Σήμερα, δεν χρειάζεται ούτε να κάτσεις να δομήσεις το prompt. Παίρνεις καλύτερο αποτέλεσμα με ένα ελεύθερο dictation.
1. Ανάλογα το project το οποίο δουλεύεις. Εάν κάνεις software engineering και του κόψεις τη πρόσβαση στο φάκελο του project, τι σόι review θα κάνει; Ο sub-agent δεν μοιράζεται το context με το βασικό session. Το βασικό session πάει και του γράφει ένα prompt. Εκεί μπορείς να ζητήσεις το prompt που θα του δώσει να μην μοιραστεί τίποτα από το βασικό session. Πλέον δεν κάνω ούτε αυτό. Εάν το μοντέλο θεωρεί πως κάνεις λάθος, σου το λέει.
2. Δεν χρειάζεται, auto mode classifier εάν το θέλεις οπωσδήποτε. Συνήθως, ακόμη και στις εργασίες της δουλειάς, τους επιτρέπω να έχουν πρόσβαση στα αρχεία του εκάστοτε project. Εκτός και εάν πρόκειται για πρωτογενή έρευνα δεν καταλαβαίνω πως η μη-πρόσβαση θα οδηγήσει σε καλύτερα αποτελέσματα.
3. By default δηλαδή το codex μεταφέρει bias στους sub-agents; Άνοιξα τώρα το prompt που έδωσε το Opus 5.5 από το βασικό session σε έναν code-review sub-agent και δεν έχει κανένα bias ούτε περιλαμβάνει μέρος της κεντρικής συζήτησης.
Θα γράψω επαγγελματικά κώδικα μια φορά το χρόνο και άντε να χρειαστεί να στήσω 2-3 φορές κάποια εξελιγμένα excel που όντως θα γλυτώσω χρόνο να μου τα φτιάξει από το να κάτσω να τα στήσω μόνος μου. Όσο για τα τοπικά εργαλεία που μου έχει αναπτύξει το codex δεν είναι κάτι περίπλοκο να φτιαχτούν. Το codex απλοποιεί το testing όχι το γράψιμο του κώδικα.
Χρησιμοποιώ τα εργαλεία κυρίως για:
1. Έρευνα που οδηγεί σε επιστημονικές δημοσιεύσεις
2. Desk research για consulting εργασία
3. Ανάλυση δεδομένων του desk research - σπάνια έχω big data έτσι και αλλιώς
4. Έλεγχο/αξιολόγηση κειμένων πριν παραδωθούν. Εδώ το πρόβλημα που έχω είναι ότι δεν μπορώ να το κάνω αυτό για όλα τα έργα λόγω confidentiality. Αυτός είναι και ο βασικός λόγος για το offline μοντέλο που στήνω. Τη βελτιστοποίηση πάντα την κάνω παραδοσιακά με το χέρι γιατί θέλω πλήρη έλεγχο του τι παραδίδω.
Πάντα είναι ωραίο να παίζεις και να αυτοματοποιείς τα πάντα, αλλά στην πράξη θέλεις -ακόμη- human gates για να εξασφαλίσεις την ποιότητα της δουλειάς και φυσικά το ownership του αποτελέσματος
Οπότε οι διαφορές που καταλαβαίνουμε έχουν να κάνουν κυρίως με το τελείως διαφορετικό πεδίο εφαρμογής στον επαγγελματικό μας χώρο. Προφανώς όπως λες πρέπει να βλέπει τον συνολικό κώδικα ο agent ο δικός σου με ότι commenting κλπ περιέχει, αλλιώς δεν θα μπορεί να δουλέψει.
Το αν μεταφέρει το bias δεν έχω ψάξει σε επίπεδο κώδικα αν το κάνει ή όχι ή αν είναι κάποιος άλλος μηχανισμός που επηρρεάζει το αποτέλεσμα. Θα μπορούσε να είναι και κάτι πιο απλό, κάποιος κώδικας που κρατάει στη μνήμη καταστάσεις του μοντέλου στο επίπεδο σκέψης/reasoning για αύξηση της ταχύτητας / μείωση της ανάγκης για νέα token. Αυτό το αντιμετωπίζω τώρα που προσπαθώ να καταλάβω πως το offline μοντέλο μου δεν θα κρατά μνήμες μέσω ρυθμίσεων όπως preserve_thinking κλπ τα οποία οδηγούν σε αύξηση της ταχύτητας αλλά σε σταδιακή πτώση της περιπλοκότητας της νέας σκέψης και τελικά μείωση της απόδοσης του μοντέλου. Μπορεί ακόμη και κάτι τέτοιο να παίζει.
Όμως αυτό που όντως έχω κάνει είναι να κρίνω βάσει του αποτελέσματος και μετά να εικάζω γιατί έγινε αυτό - αποδείξεις δεν έχω.
Και νομίζω ότι η θεωρία αναγνωρίζει αυτά τα επίπεδα isolation. Έχουν περάσει πάνω από 15 χρόνια που έστησα το πρώτο μεγάλο μου πολυπρακτορικό σύστημα με Orchestrators που δούλευε μια χαρά, αλλά τότε δεν είχαμε LLM και περιορισμό στο hardware για τους διάφορους agent που έλεγχαν εξοπλισμό στον φυσικό κόσμο. Εκεί το isolation ήταν πολύ εύκολο μέσω ελέγχου της επικοινωνίας των agent μεταξύ τους. Και ναι όλα ήταν γραμμένα σε Fortran