Τεχνητή Νοημοσύνη (AI). Τι είναι, τι ξέρουμε, τι αλλάζει στη ζωή και στον πολιτισμό;

Μετά από λίγες μέρες με το Mythos 5.2 και έχοντας του βάλει ορισμένα αρκετά σύνθετα tasks να ολοκληρώσει -ορισμένα εκ των οποίων τρέχουν ακόμη, παρότι εδώ και κάποιους μήνες το πιστεύω πραγματικά πως έχουμε λύσει το software engineering, συνεπώς δεν περίμενα να λύσει κάτι περισσότερο, διαπιστώνω το εξής. Πρόκειται για το πρώτο μοντέλο που αμφισβητεί επιλογές αρχιτεκτονικής ή/και ρωτάει για πιθανές αβλεψίες.

Και δεν είναι πως αμφισβητεί λάθος επιλογές αρχιτεκτονικής αλλά εκεί που πραγματικά "έμεινα" ήταν όταν μου έβαλε μέσα και ρυθμιστικές παραμέτρους του κανονιστικού πλαισίου.

Πρόκειται όντως για κάτι ιδιαίτερο και ξεχωριστό σε σχέση με ότι έχουμε μέχρι σήμερα. Εγώ τώρα πως το χρησιμοποιώ, το έχω σαν orchestrator, συζητάω μαζί του για τον τελικό στόχο, κάνω τις επιλογές αρχιτεκτονικής και μετά τα στέλνει σε sub-agents Opus 5.5 για την υλοποίηση.

Τώρα πόσο καταλήγει να κοστίζει αυτό. Σίγουρα όχι εξωφρενικά μεγαλύτερα νούμερα εφόσον τη πολλή δουλειά τη κάνει το Opus. Και τη κάνει εξαιρετικά.

View attachment 280959

Σε άλλα νέα, βγήκε και το Gemini 4 Carbon.
Λέω ευκαιρία να το δοκιμάσω λίγο από το Gemini Enterprise της δουλειάς, ας του βάλω το prompt που είχαμε κάνει εδώ δοκιμή με το 4 Argon.
Το harness είναι τόσο κακό, που μετά από 15 λεπτά βγάζει μήνυμα πως έκανε time-out και να σπάσω το request σε μικρότερα tasks. Όσο καλό μοντέλο και να είναι -που είναι, εάν το harness είναι απαράδεκτο σε τέτοιο σημείο που να σου σπάει τα νεύρα, για την καθημερινή τυπική δουλειά δεν κάνει.

Εν αντιθέσει με αυτό, στο API του, το ενσωματώσαμε σε μια από τις εφαρμογές μας άμεσα και είναι αρκετά καλύτερα τα αποτελέσματα σε σχέση με το Argon.

Τέλος, δείτε και αυτό. Μετά τη κυκλοφορία του Opus 5.5 η Anthropic πήγε πάλι στην εκθετική αύξηση επισκεψιμότητας.

View attachment 280960
Μιας και τα χρησιμοποιείς όλα κάθε Ai που πιστεύεις είναι καλύτερο σε πιο τομεα grok, Gemini, GPT, claude, copilot?
 
Δεν απαντάται σε μια γραμμή αυτό.

Για τον μέσο άνθρωπο που θέλει καλά αποτελέσματα σε διάφορα tasks, αυτή τη στιγμή η καλύτερη επιλογή είναι να πάρει την 20ευρη συνδρομή του Claude, να χρησιμοποιεί το τελευταίο μοντέλο Opus και το αποτέλεσμα που θα παίρνει είναι κοντά στο κορυφαίο διαθέσιμο και με αρκετή διαθέσιμη χρήση στη συνδρομή.

Το οικοσύστημα είναι το πιο πλήρες, έχει extensions σε office, πολύ δυνατό browser use, είναι αυτή τη στιγμή η καλύτερη εμπειρία.


Τώρα για τους υπόλοιπους που είμαστε κάπως power users και nerds.

Για προγραμματισμό, πάλι, τα μοντέλα της Anthropic είναι τα καλύτερα αυτή τη στιγμή. Τον κύριο όγκο δουλειάς εάν θέλεις να τον κάνεις με φυσιολογικό κόστος θα τον κάνει το εκάστοτε Opus ή το αντίστοιχο της OpenAI επίπεδο μοντέλου, το Sol. Αυτή τη στιγμή, το Opus είναι πολύ καλύτερο σε σχέση με το διαθέσιμο Sol, οπότε δεν υπάρχει σύγκριση εκεί. Το Astra είναι μια χαρά μοντέλο, δεν του λείπει κάτι, αλλά λόγω κόστους δεν μπορεί να είναι το βασικό μοντέλο που χρησιμοποιεί κανείς. Fable/Mythos είναι στη κορυφή σήμερα, πραγματικά μοναδικά σε αυτό που κάνουν, επίσης με υψηλό κόστος, εάν έχεις απεριόριστη χρήση API μέσω της εταιρίας για παράδειγμα, φυσικά χρησιμοποιείς αυτό.

Επειδή δεν μπορείς να κάνεις βαριά χρήση των καλών μοντέλων σε επίπεδο chat και να τρέχουν και projects, εγώ προσωπικά χρησιμοποιώ για ότι μικρό θέλω να ρωτήσω, τη συνδρομή του Gemini Enterprise. Νομίζω πληρώνουμε περίπου ~30 ευρώ/μήνα/θέση και περιλαμβάνει πρακτικά απεριόριστη χρήση στο βασικό chat. Το Gemini 4 Carbon στα μικρά tasks είναι εξαιρετικό, επίσης γράφει τα καλύτερα Ελληνικά μεταξύ των διαφόρων επιλογών (και το καινούριο Fable είναι κοντά).

Για την ίδια χρήση, εάν κάποιος έχει από τη δουλειά του το premium 365 copilot, που έχει διαθέσιμο το 6.1 Sol, μια χαρά αποτέλεσμα θα πάρει και από αυτό στα περισσότερα tasks. Ούτε και εκεί κατάφερα να τερματίσω τη χρήση του.

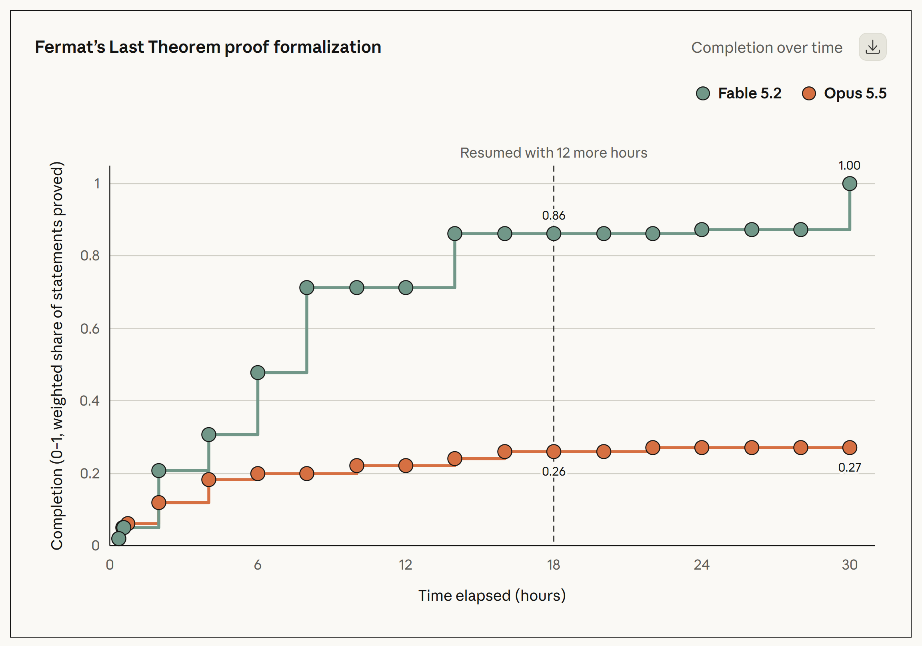
Όσον αφορά την επιστημονική έρευνα, δεν είμαι σε θέση να αξιολογήσω πρωτογενή αποτελέσματα αλλά δεν νομίζω πως είναι πρακτικά χρήσιμα στον περισσότερο κόσμο. Τι εννοώ, το σημερινό Fable 5.2 έκανε την απόδειξη του τελευταίου θεωρήματος του Fermat. Wow, καταπληκτικό, αλλά αυτό έγινε με 1000 agents να δουλεύουν επί 30 ώρες. Αντίστοιχα να ξέρετε και για το cybersecurity. Τα βασικά sweeps που βάζουμε να κάνουν τα μοντέλα με τυπικό κόστος, δεν έχουν σχέση με τις δυνατότητες τους οι οποίες για να φτάσουν στο επίπεδο που διαφημίζεται, απαιτούν πολλές ώρες αυτόνομης δουλειάς πολλών agent ταυτόχρονα με κόστος τετραψήφια-πενταψήφια νούμερα.

1794411466767.png


Για τον grok δεν έχω άποψη, είναι πολύ πίσω. Η Meta φαίνεται να έβγαλε καλά μοντέλα αλλά δεν έχει εργαλεία να τα δουλέψεις.
 
  • Like
Reactions: speedman_27
Δεν απαντάται σε μια γραμμή αυτό.

Για τον μέσο άνθρωπο που θέλει καλά αποτελέσματα σε διάφορα tasks, αυτή τη στιγμή η καλύτερη επιλογή είναι να πάρει την 20ευρη συνδρομή του Claude, να χρησιμοποιεί το τελευταίο μοντέλο Opus και το αποτέλεσμα που θα παίρνει είναι κοντά στο κορυφαίο διαθέσιμο και με αρκετή διαθέσιμη χρήση στη συνδρομή.

Το οικοσύστημα είναι το πιο πλήρες, έχει extensions σε office, πολύ δυνατό browser use, είναι αυτή τη στιγμή η καλύτερη εμπειρία.


Τώρα για τους υπόλοιπους που είμαστε κάπως power users και nerds.

Για προγραμματισμό, πάλι, τα μοντέλα της Anthropic είναι τα καλύτερα αυτή τη στιγμή. Τον κύριο όγκο δουλειάς εάν θέλεις να τον κάνεις με φυσιολογικό κόστος θα τον κάνει το εκάστοτε Opus ή το αντίστοιχο της OpenAI επίπεδο μοντέλου, το Sol. Αυτή τη στιγμή, το Opus είναι πολύ καλύτερο σε σχέση με το διαθέσιμο Sol, οπότε δεν υπάρχει σύγκριση εκεί. Το Astra είναι μια χαρά μοντέλο, δεν του λείπει κάτι, αλλά λόγω κόστους δεν μπορεί να είναι το βασικό μοντέλο που χρησιμοποιεί κανείς. Fable/Mythos είναι στη κορυφή σήμερα, πραγματικά μοναδικά σε αυτό που κάνουν, επίσης με υψηλό κόστος, εάν έχεις απεριόριστη χρήση API μέσω της εταιρίας για παράδειγμα, φυσικά χρησιμοποιείς αυτό.

Επειδή δεν μπορείς να κάνεις βαριά χρήση των καλών μοντέλων σε επίπεδο chat και να τρέχουν και projects, εγώ προσωπικά χρησιμοποιώ για ότι μικρό θέλω να ρωτήσω, τη συνδρομή του Gemini Enterprise. Νομίζω πληρώνουμε περίπου ~30 ευρώ/μήνα/θέση και περιλαμβάνει πρακτικά απεριόριστη χρήση στο βασικό chat. Το Gemini 4 Carbon στα μικρά tasks είναι εξαιρετικό, επίσης γράφει τα καλύτερα Ελληνικά μεταξύ των διαφόρων επιλογών (και το καινούριο Fable είναι κοντά).

Για την ίδια χρήση, εάν κάποιος έχει από τη δουλειά του το premium 365 copilot, που έχει διαθέσιμο το 6.1 Sol, μια χαρά αποτέλεσμα θα πάρει και από αυτό στα περισσότερα tasks. Ούτε και εκεί κατάφερα να τερματίσω τη χρήση του.

Όσον αφορά την επιστημονική έρευνα, δεν είμαι σε θέση να αξιολογήσω πρωτογενή αποτελέσματα αλλά δεν νομίζω πως είναι πρακτικά χρήσιμα στον περισσότερο κόσμο. Τι εννοώ, το σημερινό Fable 5.2 έκανε την απόδειξη του τελευταίου θεωρήματος του Fermat. Wow, καταπληκτικό, αλλά αυτό έγινε με 1000 agents να δουλεύουν επί 30 ώρες. Αντίστοιχα να ξέρετε και για το cybersecurity. Τα βασικά sweeps που βάζουμε να κάνουν τα μοντέλα με τυπικό κόστος, δεν έχουν σχέση με τις δυνατότητες τους οι οποίες για να φτάσουν στο επίπεδο που διαφημίζεται, απαιτούν πολλές ώρες αυτόνομης δουλειάς πολλών agent ταυτόχρονα με κόστος τετραψήφια-πενταψήφια νούμερα.

View attachment 280968


Για τον grok δεν έχω άποψη, είναι πολύ πίσω. Η Meta φαίνεται να έβγαλε καλά μοντέλα αλλά δεν έχει εργαλεία να τα δουλέψεις.
Για καθημερινα προβλήματα πχ πως βάφεται ένας τοίχος κτλ;
 
Για το μέσο χρήστη σήμερα η καλύτερη λύση είναι η 20δόλαρη συνδρομή του Claude.
H OpenAΙ είναι τουλάχιστον 1 γενιά πίσω. Βέβαια αυτό δεν σημαίνει ότι για τα περισσότερα τασκ αυτό δεν είναι αρκετό.

Αν έχεις μικρομεσαία επιχείρηση και θέλεις και ένα τυπικό επίπεδο ασφάλειας και GDPR πας σε Business Copilot που από όταν πήρε το Sol 6.1 είναι μια χαρά για τα περισσότερα. Στο Excel έχει και μοντέλα της Anthropic.

Gemini θα πρότεινα μόνο σε κάποιον που χρησιμοποιεί ενεργά το πλήρες οικοσύστημα της google. Έχω την Plus συνδρομή λόγω του cloud space που πληρώνω και το χρησιμοποιώ ελάχιστα γιατί το Flash 3.8 ακόμη και στο High Thinking κάνει πολλές κοτσάνες που το Sol 6.1 δεν κάνει. Είναι αστείο, αλλά νομίζω ότι με όλη τη δουλειά που έχω κάνει στο harness στο local μοντέλο που έχω, το εμπιστεύομαι περισσότερο απο το Gemini 3.8 Flash (το local τρέχει το Qwen3.8 Flash Next).

Προσωπικά συνεχίζω με την OpenAI για τον απλό λόγο ότι δεν θέλω να αλλάξω οικοσύστημα. Έχω μάθει τα χούγια της, λατρεύω το CODEX και με την Pro 100 συνδρομή ακόμη και αν κάνω όλα τα επαγγελματικά στο Astra (που είναι overkill) δεν βγαίνω εκτός ορίων.
 
  • Like
Reactions: speedman_27
Gemini 4 Hydrogen

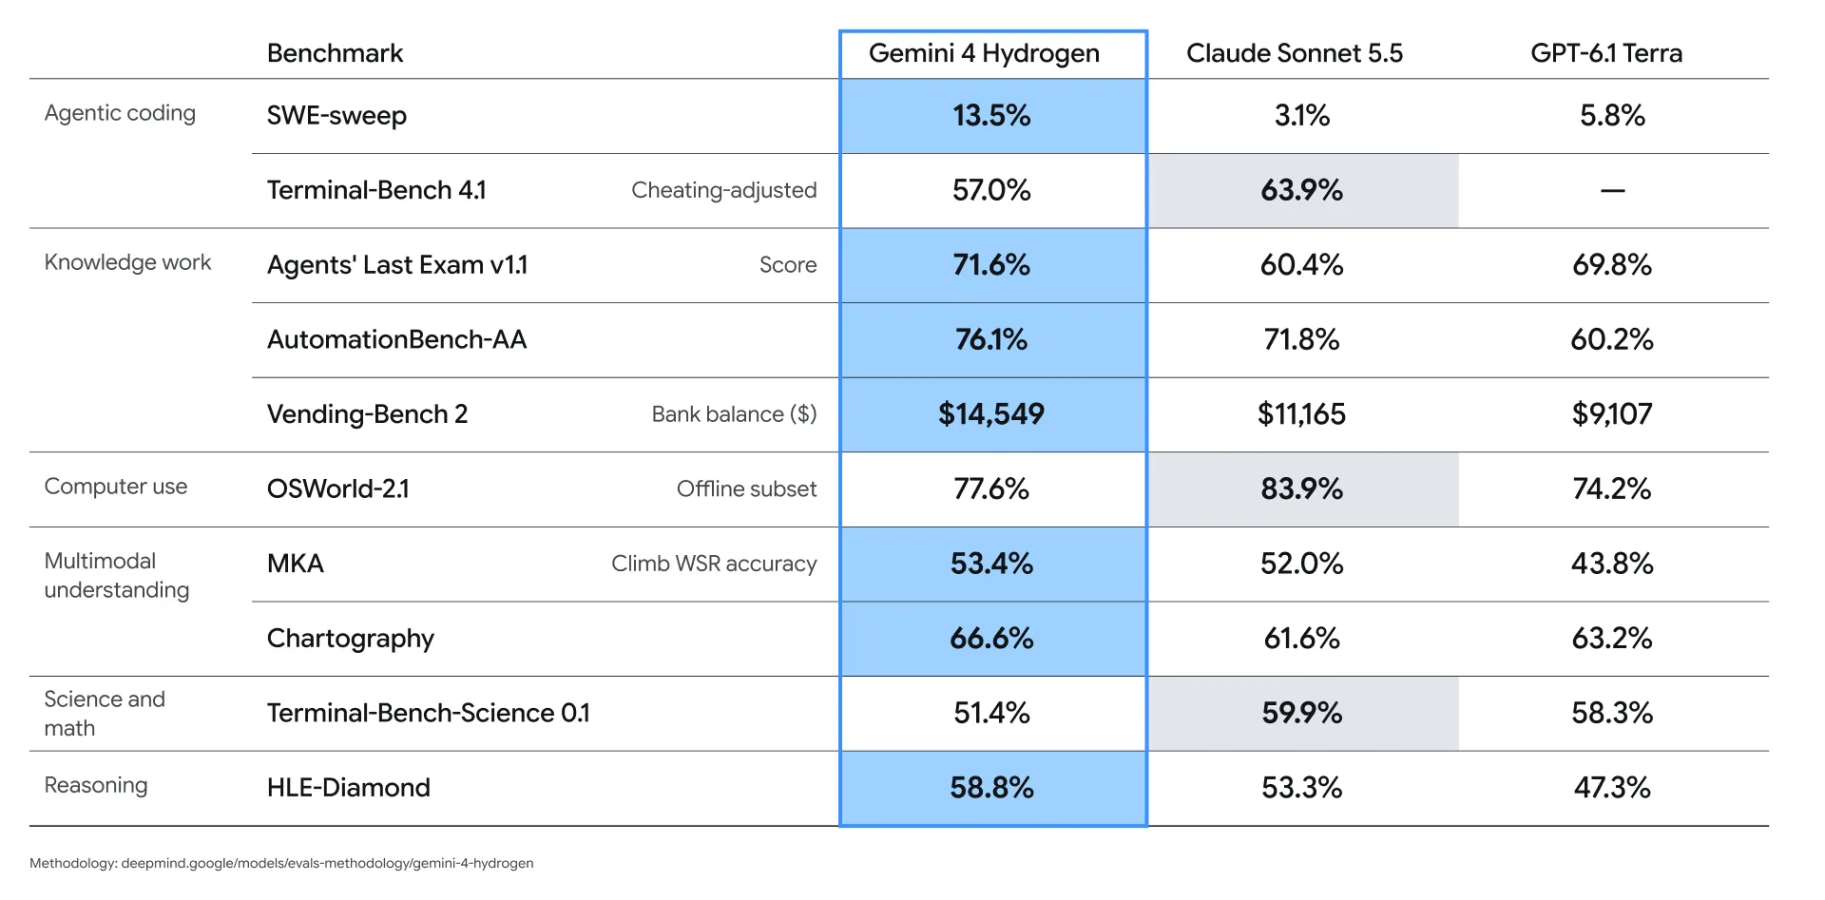
Κυκλοφόρησε το Gemini 4 Hydrogen, για τον περισσότερο κόσμο το σημαντικότερο μοντέλο της Google, εφόσον αυτό είναι διαθέσιμο σε όλους. Είτε χρησιμοποιούν το ai mode του Google Search είτε το Gemini.

1794507331343.png

1794507342435.png

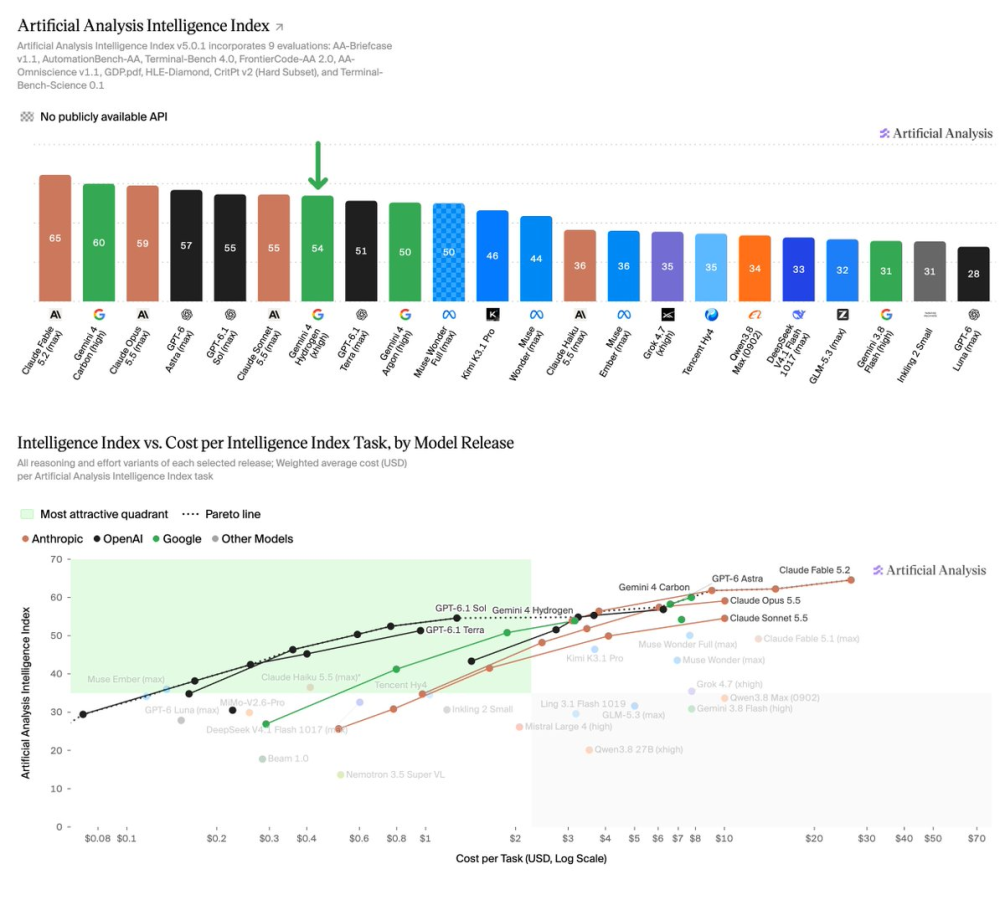
Google's new Gemini 4 Hydrogen has Intelligence just below Claude Sonnet 5.5 and GPT-6.1 Sol, at a third of Sonnet’s cost but ~2.5x that of GPT-6.1 Sol
@GoogleDeepMind
has released their third new model in six weeks. Gemini 4 Hydrogen introduces an xhigh reasoning level and scores 54 on the Artificial Analysis Intelligence Index, with strengths in visual reasoning and non-hallucination. This places it 1 point behind Claude Sonnet 5.5 (max) and GPT-6.1 Sol (max), at ~32% of Sonnet’s cost but ~2.5x that of GPT-6.1 Sol. With high reasoning, Gemini 4 Hydrogen matches the Intelligence of Gemini 4 Argon for ~19% of the Cost per Task

Key takeaways:
➤ The new xhigh reasoning level scores 54 on the Intelligence Index: xhigh is the first reasoning level above high on a Gemini model, and puts Hydrogen 1 point below Claude Sonnet 5.5 (max) and GPT-6.1 Sol (max), and 4 points ahead of Gemini 4 Argon (high). With default (high) reasoning, Gemini 4 Hydrogen scores 51, just behind GPT-6.1 Sol (xhigh, 52) and Claude Opus 5.5 (high, 52)
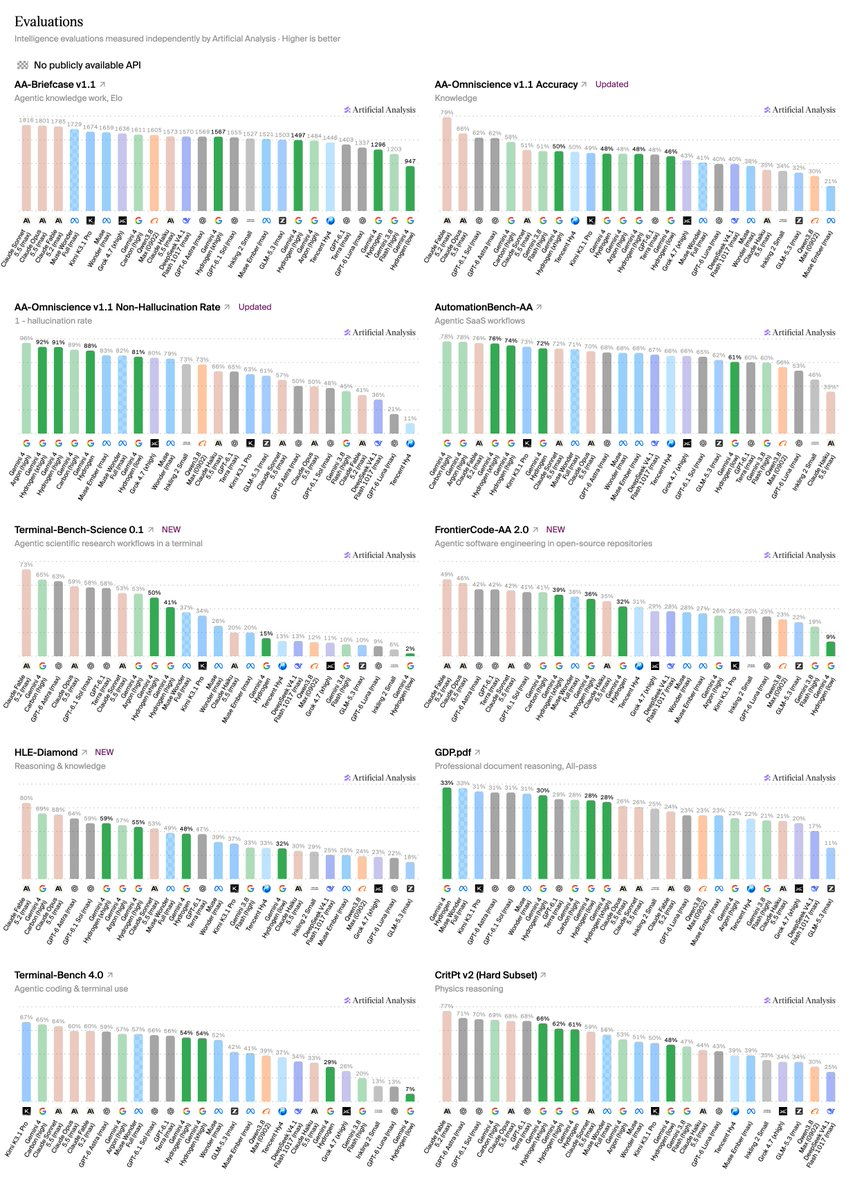
➤ Strong visual reasoning, presentation and non-hallucination: On GDP.pdf, a visual reasoning benchmark over long documents, it scores 33% all-pass on medium reasoning, the tied #1 score on the benchmark. On AA-Omniscience, Hydrogen has one of the lowest hallucination rates recorded at 8%, compared with 43% for Claude Sonnet 5.5 (max) and 52% for GPT-6.1 Sol (max). On AA-Briefcase, our agentic knowledge work evaluation, graders rate Hydrogen's presentation above other Gemini models, including Carbon
➤ Weaker on agentic terminal work: Hydrogen scores 54% on Terminal-Bench 4.0 and 50% on Terminal-Bench-Science 0.1, covering agentic coding and scientific research workflows in the terminal. Claude Sonnet 5.5 (max) scores 64% and 53%, and GPT-6.1 Sol (max) scores 56% and 58%. xhigh reasoning helps on the science tasks, lifting Terminal-Bench-Science from 41% at high to 50%, but makes no difference on Terminal-Bench 4.0 (54% at both). Science scores are even across domains, from 46% in earth sciences to 53% in physical sciences
➤ Low cost for its intelligence, with high token use at xhigh: Hydrogen is priced at $1.50/$7.50 per million input/output tokens. At xhigh it costs ~32% as much per task as Claude Sonnet 5.5 (max) for near-equal intelligence, but ~2.5x as much as GPT-6.1 Sol (max). xhigh nearly doubles output tokens compared with high for a 3 point gain in Intelligence, and Cost per Task falls from $3.16 at xhigh to $1.87 at high. Medium ($0.80) and low ($0.29) cost less again, but score 41 and 27 on the Intelligence Index
➤ On the Time per Task vs. Intelligence Pareto frontier: Gemini 4 Hydrogen has an output speed of ~200 output tokens per second. With high, medium, and low reasoning effort, Gemini 4 Hydrogen is on the Time per Task vs. Intelligence Pareto frontier, meaning no models are both more intelligent and have a lower Time per Task

Τα πλήρη Benchmarks

 
GPT 6.2 Astra & Sol

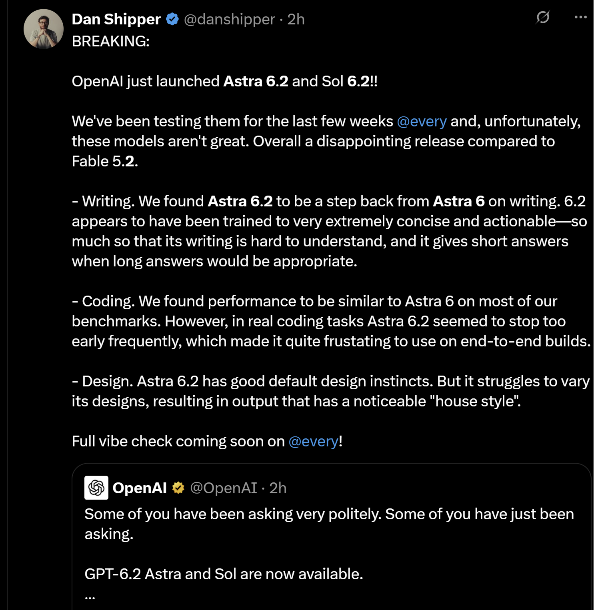
Εκ πρώτης όψεως φαίνεται πως φέρνουν σημαντικές βελτιώσεις.
Δεν πέρασαν μπροστά στο Frontier μεν, παραταύτα δείχνουν πολύ καλά releases.


1794938600112.png
1794938627585.png 1794938722579.png

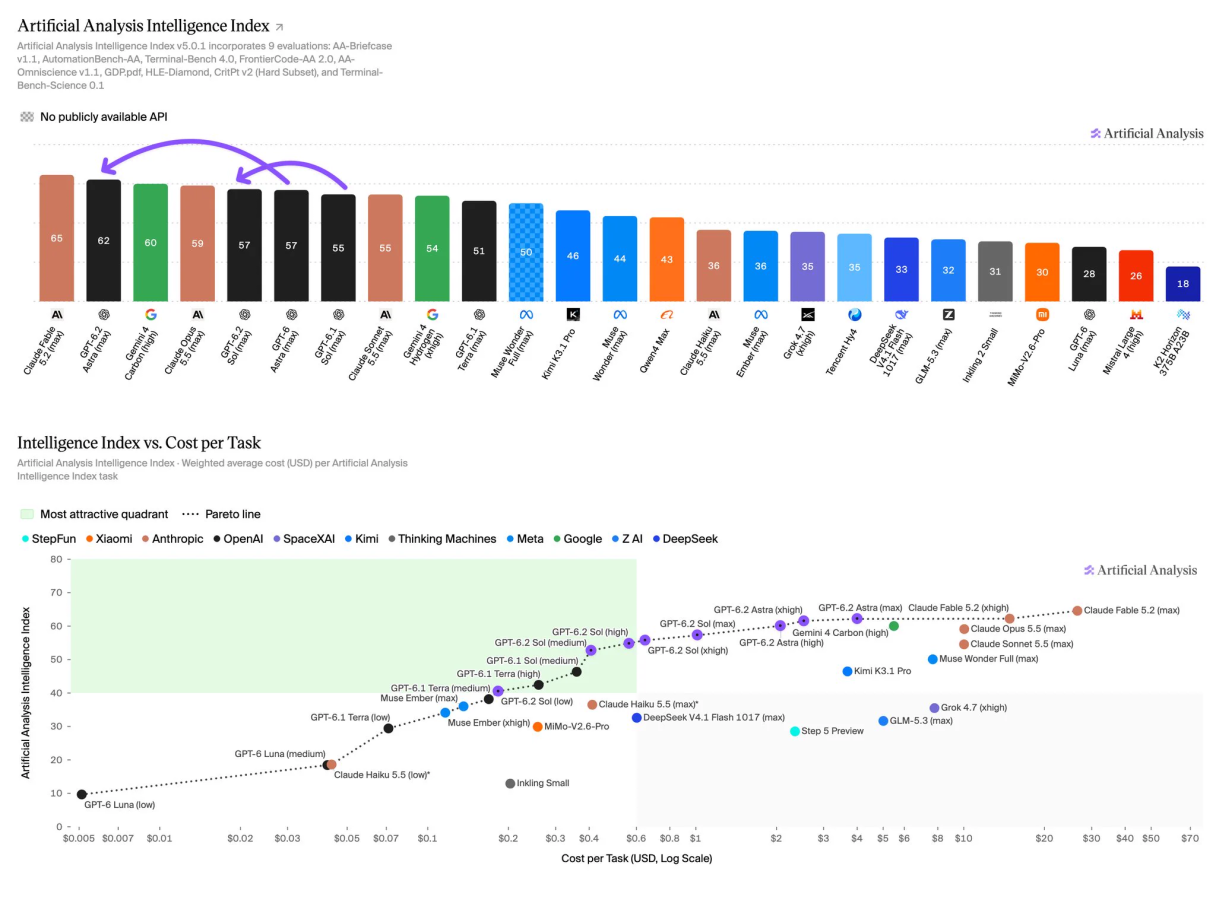
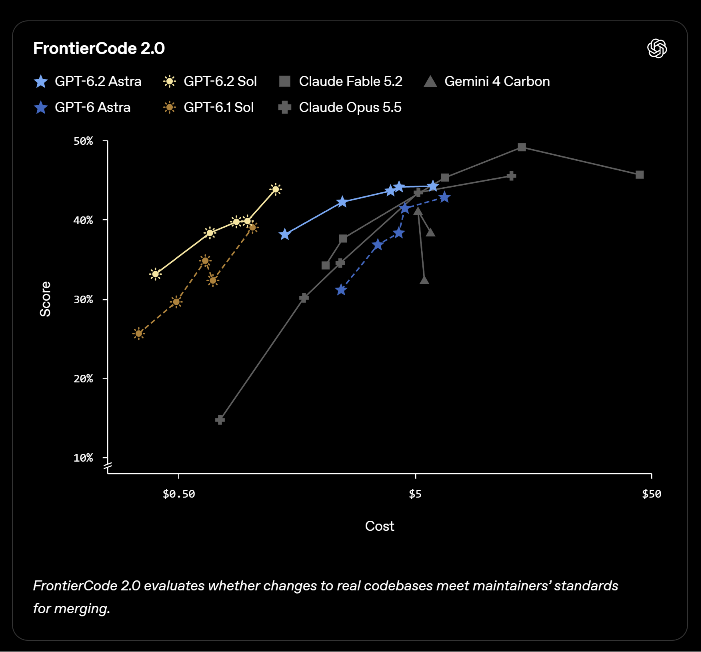
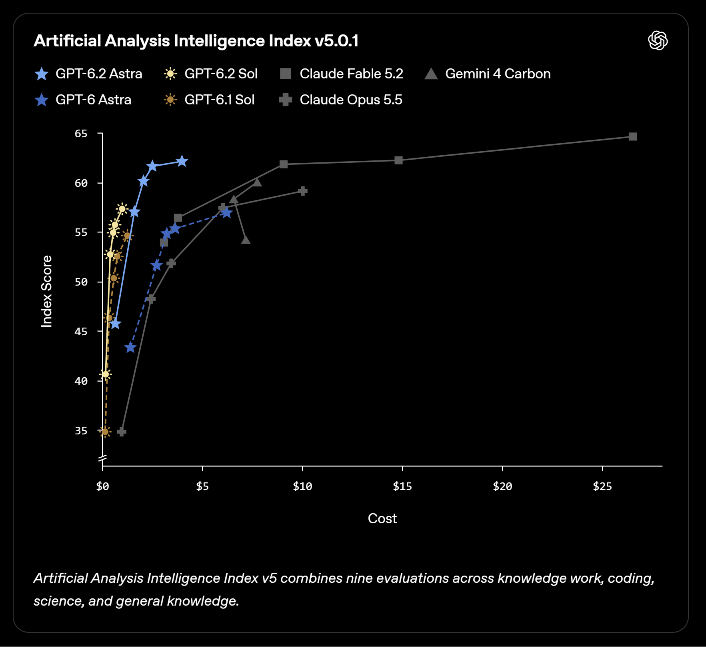
OpenAI’s release of GPT-6.2 Astra and GPT-6.2 Sol delivers the #2 model in the Artificial Analysis Intelligence Index and most of the Cost per Task Pareto frontier@OpenAI's GPT-6.2 Astra is priced at $8/$40, 20% below GPT-6 Astra, and cached input drops to $0.40 from $1.00 per million tokens. GPT-6.2 Sol pricing is unchanged from GPT-6.1 Sol, at $2/$10 per million input/output tokens.Key takeaways:
➤ Second in Intelligence Index: OpenAI now trails only Anthropic’s Claude Fable 5.2 in the Artificial Analysis Intelligence Index. GPT-6.2 Astra jumps 5 points from GPT-6 Astra, overtaking Gemini 4 Carbon (60) and Claude Opus 5.5 (59) at their top effort settings. GPT-6.2 Sol gains 2 points at 57, placing it on par with GPT-6 Astra at ~15% of the Cost per Task.
➤ Occupies most of cost and output token frontiers: OpenAI models now occupy most of the Cost per Task Pareto frontier, sharing the frontier with only Anthropic and Meta. OpenAI also dominates the Output Token per Task Pareto Frontier, with Claude Fable 5.2 being the only model from a non-OpenAI lab appearing on the frontier.
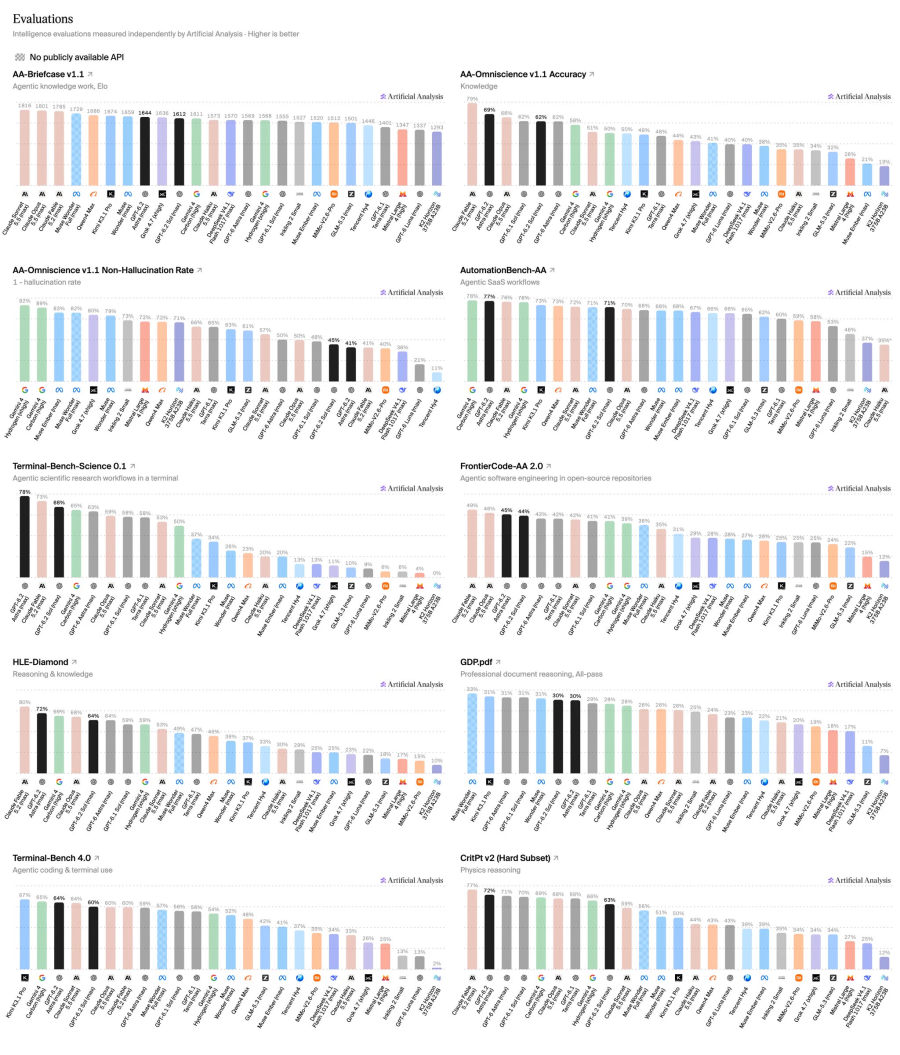
➤ Strengths in science and knowledge: OpenAI performs strongly in both of our key science-focused evaluations, leading Terminal-Bench-Science 0.1, covering agentic scientific research workflows, and placing second only to Claude Fable 5.2 in CritPt v2 (hard subset), covering physics reasoning. GPT-6.2 Astra performs below only Claude Fable 5.2 in factual knowledge as measured by AA-Omniscience v1.1 Accuracy, and in HLE-Diamond, a reasoning and knowledge benchmark.
➤ Leading in 3D and robotics: GPT-6.2 Astra leads AA-3D at 1318, with Claude Fable 5.2 at 1271 and GPT-6.2 Sol at 1259. This benchmark measures how well models build interactive 3D experiences, and is rated by human graders. GPT-6.2 also leads AA-Robotics v0.1, our research preview measuring how well language models can understand, plan, and act in the real world. GPT-6.2 Astra and GPT-6.2 Sol scored 79 and 78 respectively, ahead of Claude Fable 5.2 at 75. Our team is hard at work adding more difficult tasks, as OpenAI and Anthropic models can now perform the majority of basic tasks in this initial research preview.
➤ No improvement in Coding Agent Index: GPT-6.2 Astra is flat with GPT-6 Astra, and GPT-6.2 Sol loses 3 points relative to GPT-6.1 Sol in the Artificial Analysis Coding Agent Index (Codex harness at max effort). For Sol, the drop is driven by a 14-point drop in SWE-Atlas-QnA-AA, where the model is more likely than its predecessor to omit key facts in its responses. Cost efficiency however does place several effort levels of GPT-6.2 Astra and Sol on the Pareto frontier for Cost per Task.

Όλα τα Benchmarks:

 
Καιρός ήταν...
Μένω στο ότι το Sol 6.2 το δίνουν με ακριβώς τα ίδια credits με το Sol 6.1 στο Codex. Τα input tokens είναι στα 50 credit και τα output 250.
Το Astra 6.2 είναι φθηνότερο από το Astra 6.
Έτσι τα input tokens από τα 250 credits πέφτουν στα 200, ενώ τα output από τα 1250 πέφτουν στα 1000.

Το κόστος παραμένει σημαντικά χαμηλότερο σε σχέση και με το Fable 5.2 αλλά ακόμη και με το Opus 5.5.

Πάντως τα αναλυτικά benchmark μας δείχνουν ότι σε κάποιες κατηγορίες είναι μπροστά η Anthropic, σε άλλες η OpenAI, σε άλλες η Google και σε άλλες η Meta ενώ ακόμη και το Kimi K3.1 Pro είναι πρώτο σε μια κατηγορία. Σίγουρα είναι καλό για όλους να μην υπάρχει μονοπώλιο...
 
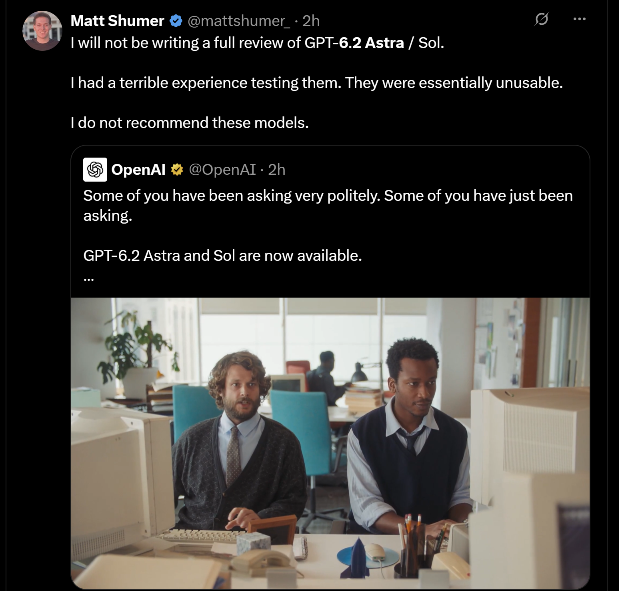
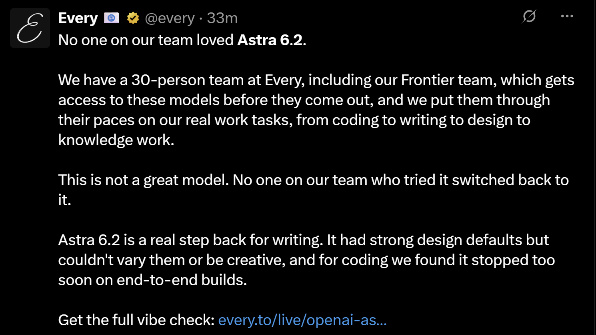
Κάτι πρέπει να πηγαίνει πάντως στραβά.
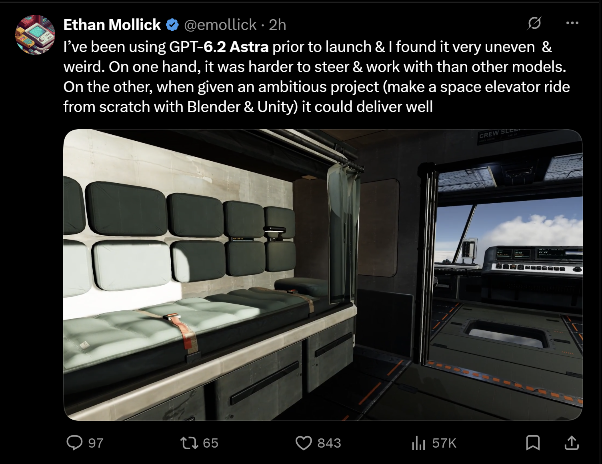
Όλοι όσοι είχαν πρόσβαση (δεν λέω για influencers, ceo εταιριών κλπ) να το δοκιμάσουν δεν γράφουν κολακευτικά πράγματα.

Βέβαια, αυτά κυρίως στο development.
Στο 3D για παράδειγμα τα παέι περίφημα.

1794948297643.png 1794948325369.png
1794948342575.png 1794948660205.png
 
Μάλιστα, υπέροχα όλα αυτά.
Ερώτηση, έχω κάτι project στο μυαλό μου ακόμα από το καιρό που ήμουν φοιτητής.
Συστήματά αυτόματου ελέγχου και αυτοματισμούς μέσω raspberry rpi5/4 κτλ & c++.
Επειδή με τον προγραμματισμό πια ΔΕΝ το έχω ποιο από όλα τα ai θα με βοηθούσε καλύτερα για την πλατφόρμα αυτή;
Πχ να περιγράφω το πρόβλημα & το τι θέλω να κάνω, να θέτω τις προδιαγραφές και τις παραμέτρους και ό,τι άλλο και να καταλήξω στον -έτοιμο- κώδικα;
 
Δεν μου ακούγεται κάτι εξαιρετικά περίπλοκο.
Οποιαδήποτε συνδρομή των 3 μεγάλων θα σε βοηθήσει πολύ. Ξεκίνα από τη δωρεάν χρήση της Google στο antigravity.

Απλά θα πρέπει να δουλέψεις από antigravity/claude code/codex. Όχι από το απλό chat.
 
Μάλιστα, υπέροχα όλα αυτά.
Ερώτηση, έχω κάτι project στο μυαλό μου ακόμα από το καιρό που ήμουν φοιτητής.
Συστήματά αυτόματου ελέγχου και αυτοματισμούς μέσω raspberry rpi5/4 κτλ & c++.
Επειδή με τον προγραμματισμό πια ΔΕΝ το έχω ποιο από όλα τα ai θα με βοηθούσε καλύτερα για την πλατφόρμα αυτή;
Πχ να περιγράφω το πρόβλημα & το τι θέλω να κάνω, να θέτω τις προδιαγραφές και τις παραμέτρους και ό,τι άλλο και να καταλήξω στον -έτοιμο- κώδικα;
Με πληρωμή 23€/ μήνα και οι τρεις μεγάλες θα σου κάνουν δουλειά. Εγώ αυτή τη στιγμή έχω δωρεάν το Gemini pro και έχω ενθουσιαστεί με το gemini hydrogen στο xhigh .
Μου βγάζει καλύτερα αποτελέσματα από το Argon στο default . Το Argon αν τολμήσω αν το βάλω κάτι παραπάνω από medium στα 3-4 prompts τελείωσα το εβδομαδιαίο όριο του pro ...

Για δωρεάν βάλε opencode με deepseek 4.1 και GLM 5.3 flash .

Το GLM έκανα debugging την android tv μου. Νομίζω τα ημερήσια όρια ειναι στα 20m tokens output .
 
  • Like
Reactions: leonkoum
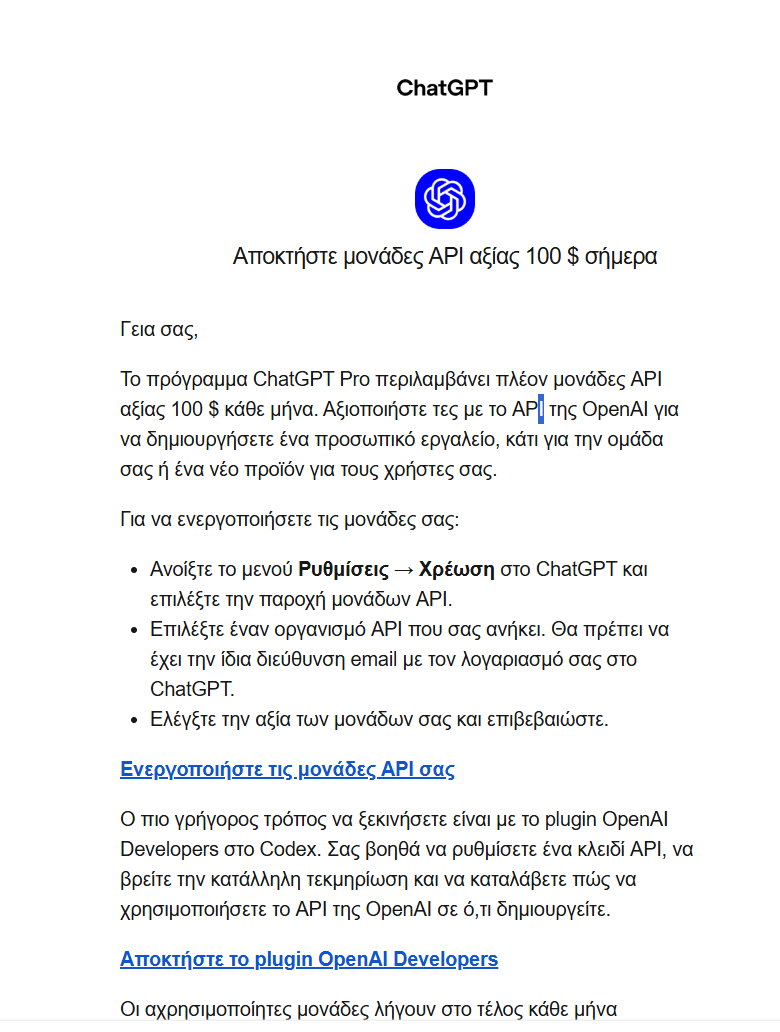
Η OpenAI επεκτείνει τον πόλεμο τιμών...Πήρα το παρακάτω mail σήμερα το πρωί.
Επίσης είναι δεδoμένο πως το Fable είναι αισθητά καλύτερο σε coding.
Από την άλλη λίγες δοκιμές που έκανα χθες βράδυ, κάνει το Astra 6.2 multidisciplinary έρευνα και μετά γράφει κείμενα απίστευτα με απλά prompts. Επειδή έτσι και αλλιώς οι ρυθμίσεις μου είναι τελείως για professional συγγραφή κειμένων δεν μπορώ να τσεκάρω για δημιουργικό κείμενο.

Θα επαναλάβω αυτά που έχουμε πει και πιο πριν. Οποια 20δόλαρη συνδρομή και να αγοράσει κάποιος σήμερα από Anthropic / OpenAI είναι μια χαρά. Meta δεν έχω δοκιμάσει και το Hydrogen της Google δεν μου αρέσει, όπως δεν μου αρέσει και το integration στο οικοσύστημά της.

Με κάπου 250 ευρώ το μήνα κάποιος μπορεί να έχει 2 συνδρομές να χρησιμοποιεί αυτή της Anthropic για να κάνει orchestration με το Fable και όλη τη δουλειά με το Sol 6.2 Extra High, που το λες και Overkill.

1794988062227.png
 
Και ένα άρθρο για την ασφάλεια...πόσο εύκολο έχει γίνει να κάνεις Jailbreak ένα μοντέλο και αυτό να σε βοηθήσει να φτιάξεις όπλα βιολογικού πολέμου...

 
Το academia.edu προσφέρει μια νέα υπηρεσία co-scientist σε beta. Δωρεάν χρήση AI για έναν μήνα, και μάλιστα με επιλογή μοντέλων.

Έδωσα στο Opus 5.5 δυο μεταγραφές από χειρόγραφα του 17ου αιώνα και του ζήτησα να τα μετατρέψει σε ένα κείμενο. Το έκανε επιλέγοτνας το πιο πλήρες κείμενο και κάνοντας διορθώσεις με βάση το άλλο. Και 88 υποσημειώσεις για τις επεμβάσεις του. Μάλιστα σχολίασε ότι δεν έχει το σκαναρισμένο για έλεγχο, και πρέπει να βασιστεί μόνο στις μεταγραφές, οπότε διόρθωσε όπως νόμιζε σημεία που θεώρησε ότι δεν έβγαζαν σωστό νόημα. Το σχόλιο πάντως ότι μία φράση (που κατ' αυτό δεν έβγαζε σωστό νόημα) ήταν ακριβής μετάφραση από τον Κοπέρνικο με εντυπωσίασε. Χρειάστηκε περίπου 15 λεπτά για 8 σελίδες. Περιμένω από φιλόλογο να τσεκάρει το αποτέλεσμα. Μετά ζήτησα από το Haiku να το μεταφράσει και στα αγγλικά, αλλά το αποτέλεσμα μου βγήκε πολύ άτσαλο κι όχι ποιητικό...

Σε ένα άλλο τεστ έδωσα στον Sol 6.2 ένα άρθρο για κριτική. Βρήκε αρκετά προβλήματα (κι εγώ είχα καταλάβει ότι δεν ήταν καλό το άρθρο). Έχοντας πρόσβαση σε όλο το academia.edu, μου έφερε παραδείγμα με εκτενή ανάλυση ότι αναφορές που είχε δώσει σε άλλους συγγραφείς φανέρωνε κακή κατανόηση από τον συγγραφέα του περιεχομένου των αναφερόμενων άρθρων!
 
  • Like
Reactions: anderm
Το academia.edu προσφέρει μια νέα υπηρεσία co-scientist σε beta. Δωρεάν χρήση AI για έναν μήνα, και μάλιστα με επιλογή μοντέλων.

Έδωσα στο Opus 5.5 δυο μεταγραφές από χειρόγραφα του 17ου αιώνα και του ζήτησα να τα μετατρέψει σε ένα κείμενο. Το έκανε επιλέγοτνας το πιο πλήρες κείμενο και κάνοντας διορθώσεις με βάση το άλλο. Και 88 υποσημειώσεις για τις επεμβάσεις του. Μάλιστα σχολίασε ότι δεν έχει το σκαναρισμένο για έλεγχο, και πρέπει να βασιστεί μόνο στις μεταγραφές, οπότε διόρθωσε όπως νόμιζε σημεία που θεώρησε ότι δεν έβγαζαν σωστό νόημα. Το σχόλιο πάντως ότι μία φράση (που κατ' αυτό δεν έβγαζε σωστό νόημα) ήταν ακριβής μετάφραση από τον Κοπέρνικο με εντυπωσίασε. Χρειάστηκε περίπου 15 λεπτά για 8 σελίδες. Περιμένω από φιλόλογο να τσεκάρει το αποτέλεσμα. Μετά ζήτησα από το Haiku να το μεταφράσει και στα αγγλικά, αλλά το αποτέλεσμα μου βγήκε πολύ άτσαλο κι όχι ποιητικό...

Σε ένα άλλο τεστ έδωσα στον Sol 6.2 ένα άρθρο για κριτική. Βρήκε αρκετά προβλήματα (κι εγώ είχα καταλάβει ότι δεν ήταν καλό το άρθρο). Έχοντας πρόσβαση σε όλο το academia.edu, μου έφερε παραδείγμα με εκτενή ανάλυση ότι αναφορές που είχε δώσει σε άλλους συγγραφείς φανέρωνε κακή κατανόηση από τον συγγραφέα του περιεχομένου των αναφερόμενων άρθρων!
Για επιστημονικό literature review, από τη στιγμή που έστησα στο SearXNG τα API από elsevier, springer, IEEE και χρησιμοποιώντας σαν backup το semantic scholar, το local μοντέλο που τρέχω κάνει (σε περισσότερο χρόνο) απίστευτη δουλειά. Επίσης όταν το βάζω σε adversarial mode λιώνει οποιοδήποτε paper χωρίς έλεος...

Όπως λέω τώρα τελευταία, έχουμε ήδη μάλλον περισσότερη νοημοσύνη στα χέρια μας από ότι χρειαζόμαστε. Το θέμα τώρα είναι να την αξιοποιήσουμε καλύτερα για τις δικές μας δουλειές/ασχολίες.