

Εγώ ήμουν μέτριος στα μαθηματικά. Όλο 5 ή 6 επαιρνα. Είχα δύο δεκαριά, στην "αριθμητική ανάλυση" και στις "εξισώσεις Bessel και ανάλυση Fourier". Έλυνα δισδιάστατη μεταφορά θερμότητας με το χέρι... Και έτσι χτύπησα το τρίτο δέκαρι στη "μηχανική ρευστών". Τώρα δεν θυμάμαι τίποτα, έχω να τα χρησιμοποιήσω δεκαετίες. Το πιο πολύπλοκο πράγμα που χρησιμοποιώ είναι το Excel. Θυμάμαι όμως με νοσταλγία που προσπαθούσα να βρω άκρη σε 4k γραμμές Fortran γραμμένες από άλλον...
Τεχνητή Νοημοσύνη (AI). Τι είναι, τι ξέρουμε, τι αλλάζει στη ζωή και στον πολιτισμό;
- Thread starter Sonus Naturalis
- Start date
You are using an out of date browser. It may not display this or other websites correctly.
You should upgrade or use an alternative browser.
You should upgrade or use an alternative browser.


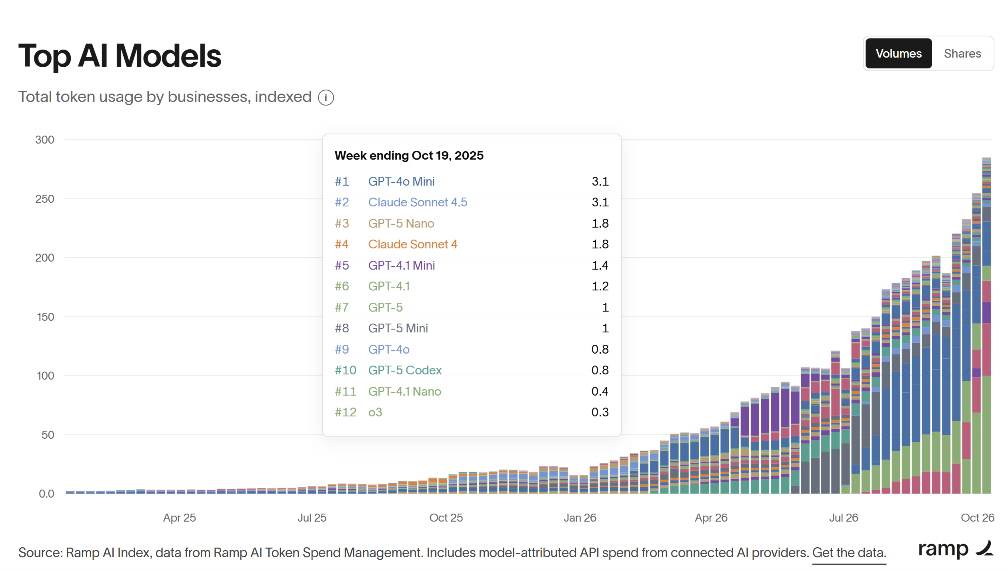
Για να καταλάβουμε πως πάνε εμπορικά τα μοντέλα μιας εταιρίας, μπορεί κανείς να δει το AI Index Token Shareper model της Ramp.
Δείτε κάποια ενδεικτικά checkpoints.
Πέρυσι τέτοια περίοδο το GPT-4o Mini ήταν το μοντέλο που οι περισσότερες επιχειρήσεις ενσωμάτωναν στις εφαρμογές τους λόγω κόστους. Η ανάπτυξη πήγαινε στο Sonnet 4.5 -το οποίο στη δική μου χρήση ήταν το πρώτο μοντέλο που όντως εκτελούσε από την αρχή μέχρι το τέλος με σχετική επιτυχία. Μέχρι τότε τα αποτελέσματα ήταν μέτρια στη καλύτερη.
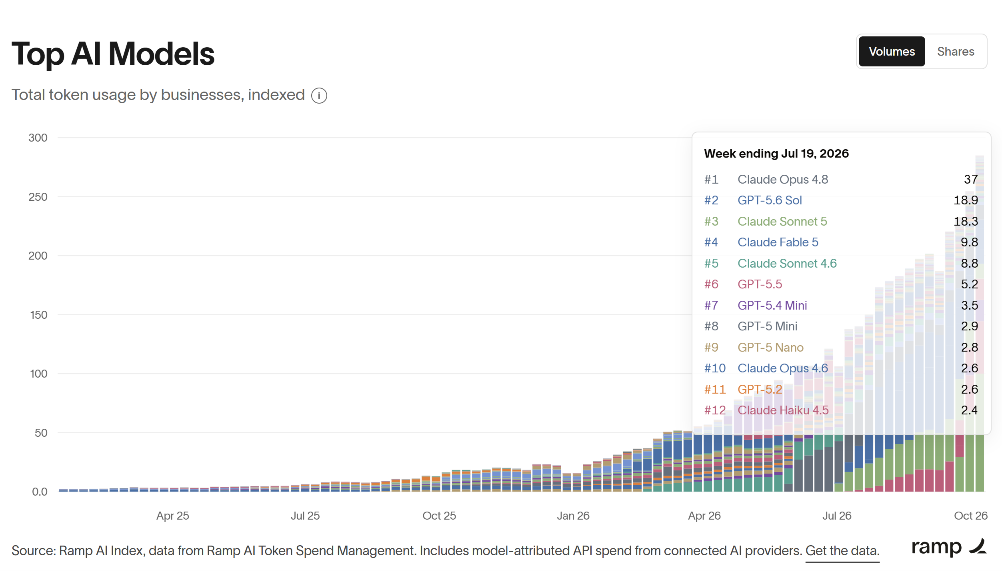
Τον Ιούλιο που βγήκε το 5.6 Sol, για πρώτη φορά άρχισε να γίνεται αρκετά μεγάλη χρήση και από επιχειρήσεις. Όντως ήταν πολύ καλό μοντέλο και αρκετά φθηνότερο από το Opus 4.8. Το Fable παρότι εντυπωσιακά καλύτερο από ότι κυκλοφορούσε, δεν εντάσσεται στα περισσότερα workflows εταιριών εφόσον δεν διατίθεται με zero-data-retention για τους περισσότερους πελάτες τους.
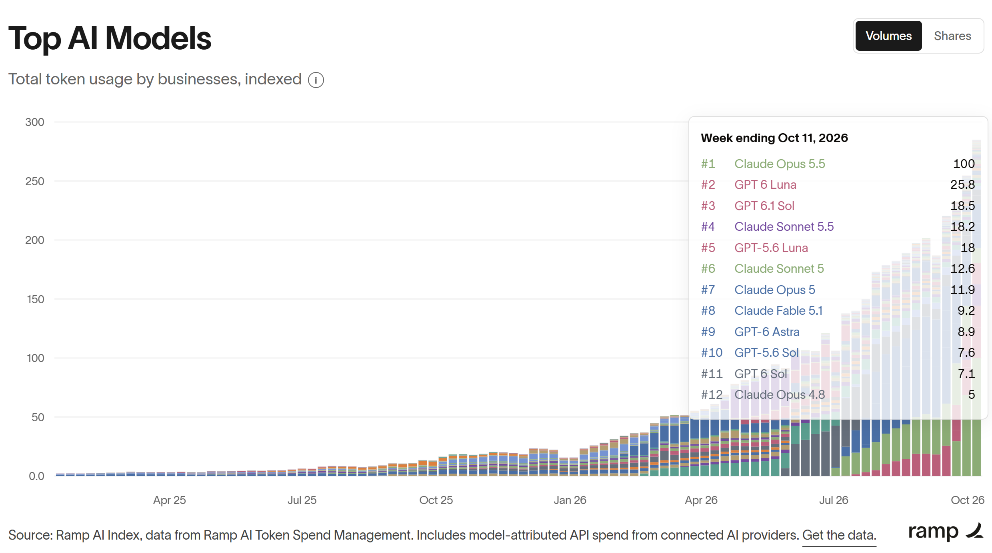
Και στο σήμερα:
Δείτε κάποια ενδεικτικά checkpoints.
Πέρυσι τέτοια περίοδο το GPT-4o Mini ήταν το μοντέλο που οι περισσότερες επιχειρήσεις ενσωμάτωναν στις εφαρμογές τους λόγω κόστους. Η ανάπτυξη πήγαινε στο Sonnet 4.5 -το οποίο στη δική μου χρήση ήταν το πρώτο μοντέλο που όντως εκτελούσε από την αρχή μέχρι το τέλος με σχετική επιτυχία. Μέχρι τότε τα αποτελέσματα ήταν μέτρια στη καλύτερη.
Τον Ιούλιο που βγήκε το 5.6 Sol, για πρώτη φορά άρχισε να γίνεται αρκετά μεγάλη χρήση και από επιχειρήσεις. Όντως ήταν πολύ καλό μοντέλο και αρκετά φθηνότερο από το Opus 4.8. Το Fable παρότι εντυπωσιακά καλύτερο από ότι κυκλοφορούσε, δεν εντάσσεται στα περισσότερα workflows εταιριών εφόσον δεν διατίθεται με zero-data-retention για τους περισσότερους πελάτες τους.
Και στο σήμερα:

Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,039
Από την μία είμαι πολύ χαρούμενος για τον παγκόσμιο ανταγωνισμό. Από την άλλη φοβάμαι τι μπορούν να κάνουν με ένα τέτοιο μοντέλο.Το αφήνω αυτό απλά εδώ.
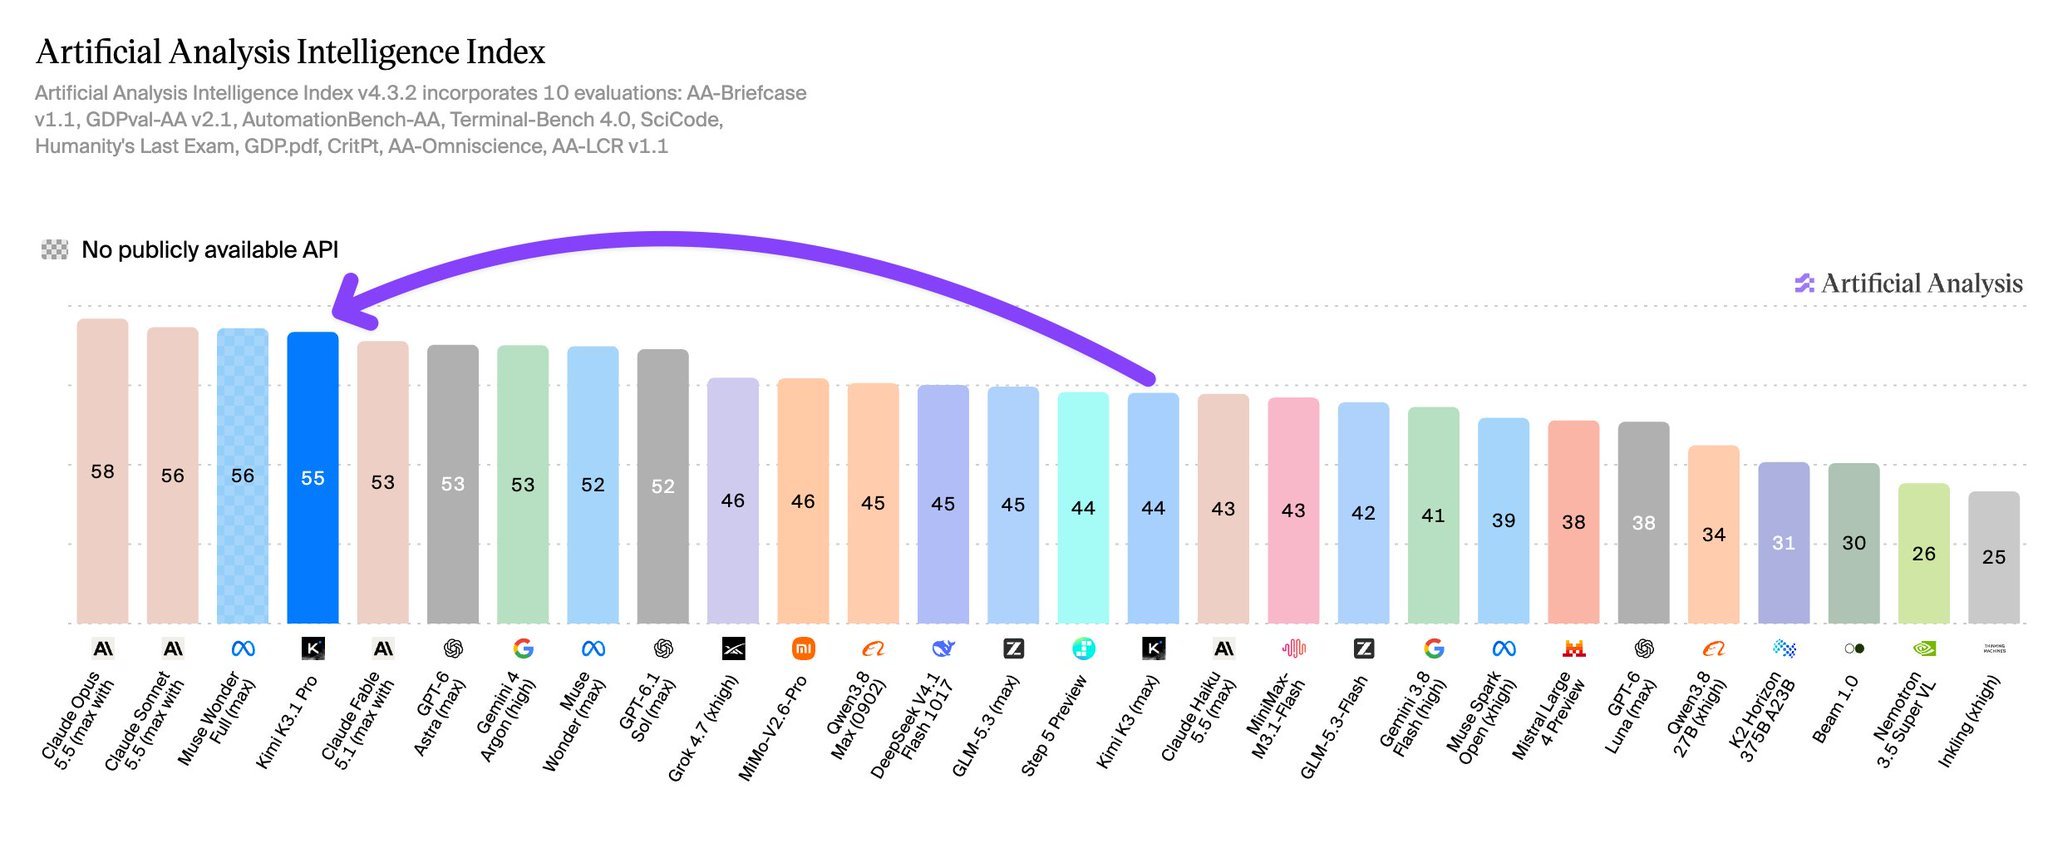
Σοκ και δέος. Ανοιχτό μοντέλο, που θα μπορεί να τρέξει ο οποιοσδήποτε (με πρόσβαση σε data enter) , καλύτερο από τα GPT Sol, Astra, Gemini 4 και τον Grok.
View attachment 279710
Λένε ότι είναι nerfed κατά τουλάχιστον 10% σε cyber security δυνατότητες. Αλλά και πάλι μπορεί να επαναφέρουν δυνατότητες.
Το τρέχεις σπίτι με 15000 ευρώ πάντως...Είναι τρελό...
Όσο και αν το έχουν βελτιστοποιήσει για τα τεστ, είναι σε κάθε περίπτωση πάνω από τα Fable 5.1 και Astra ή έστω στο ίδιο επίπεδο.
Το άλλο που δεν συζητάμε είναι πόση νοημοσύνη μπορούμε σιγά σιγά να φέρουμε στα σπίτια μας. Με 3.5-4k τρέχεις το Qwen3.8-Flash-Next που είναι τυπικά στο παραπάνω benchmark αντίστοιχο του chatgpt 5.5 xHigh.
Περιμένω πάντως και τα δύο που έχουν ανακοινωθεί από την Alibaba τα Qwen4 Flash και 27B για τοπικά.
Τέλος πραγματικά για τις αγγαρείες ήδη τα μικρά μοντέλα είναι αρκετά έξυπνα, τα μεγάλα τα θέλεις για συγκεκριμένα task μόνο.
Το τρέχεις σπίτι με 15000 ευρώ πάντως...Είναι τρελό...
Τι θα τρέξεις σπίτι με 15 χιλιάδες;
Είναι 2.8Τρις παράμετροι, σε FP8 με το context του, τη kv cache κλπ θέλει 3TB (!!!) VRAM.
Ένα NVL72 GB200 της nvidia τουλάχιστον. Ενα τυπικό 8x DGX δεν το τρέχει.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,039
Έχεις απόλυτο δίκαιο...ρώτησα στα γρήγορα το Gemini και έβγαλε αυτή την πατάτα ότι με quantization Q4 θα μπορείς από τα 400 GB ram να το τρέξεις - ζήτω τα hallucinations.Τι θα τρέξεις σπίτι με 15 χιλιάδες;
Είναι 2.8Τρις παράμετροι, σε FP8 με το context του, τη kv cache κλπ θέλει 3TB (!!!) VRAM.
Ένα NVL72 GB200 της nvidia τουλάχιστον. Ενα τυπικό 8x DGX δεν το τρέχει.
1.5–1.7 TB σε Q4, οπότε χρειάζεσαι να πουλήσεις γκαρσονιέρα για 80k μήπως καταφέρεις να συνδέσεις 4x Mac Studio M5 Ultra 512 GB για να το τρέξεις στο σπίτι και αν.
Το θέμα με τα πάρα πολύ μεγάλα μοντέλα είναι πως πέραν από το να φορτώσουν στη μνήμη της οποίας υποδομής πρέπει να μπορούν να κάνουν και decode ικανοποιητικά.
Να δώσεις 80k και να τρέχει με 10tok/s χωρίς concurrency, για ένα χρήστη, είναι απλα κακή εμπειρία.
Όσον αφορά το capability, σε πολλά tasks είναι αρκετά χειρότερο από το Astra που υποτίθεται ματσάρει εκ πρώτης όψεως. Πάντως ακόμη και λίγο πουσαρισμενοι να είναι οι αριθμοί και να μην είναι στο frontier του σημερα, είναι στο, frontier προ τριμήνου. Το ότι υπάρχει κάτι τέτοιο ελεύθερα διαθέσιμο πρέπει να δημιουργεί στρες σε όλα τα lab.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,039
Θα σου μιλήσω από προσωπική εμπειρία. Όλα είναι θέμα βελτιστοποίησης. Τελικά στο σπίτι τρέχω μοντέλο που είναι ~96 GB και έχω μέσο decode γύρω στα 30 tk/s που είναι απόλυτα λειτουργικό. Σε κάποια task πέφτει στα 20-22 tk/s και σε άλλα πάει 40+ tk/s. Και όμως είναι το ταχύτερο και πιο αξιόπιστο στις απαντήσεις συνολικά από αρκετά μικρότερα MoE μοντέλα που έχουν σημαντικά χαμηλότερο memory footprint. Τα windows κάνουν θαύματα και με τα 32 GB συν το swap τρέχω όλο το καθημερινό workload των windows απροβλημάτιστα. Το harness θέλει περίπου 3-4 GB στη ram και μετά όλα τα άλλα των windows. Συνήθως παίζω από 130-170 GB / 200 GB commited memory. Και να θυμίσω ότι η πλατφόρμα που έχω είναι σημαντικά πιο αργή σε επεξεργαστική ισχύ από κάρτες γραφικών με rtx chip της nvidia και η δύναμή της είναι στην μεγάλη διαθεσιμότητα μνήμης σε απλό form factor.Το θέμα με τα πάρα πολύ μεγάλα μοντέλα είναι πως πέραν από το να φορτώσουν στη μνήμη της οποίας υποδομής πρέπει να μπορούν να κάνουν και decode ικανοποιητικά.
Να δώσεις 80k και να τρέχει με 10tok/s χωρίς concurrency, για ένα χρήστη, είναι απλα κακή εμπειρία.
Όσον αφορά το capability, σε πολλά tasks είναι αρκετά χειρότερο από το Astra που υποτίθεται ματσάρει εκ πρώτης όψεως. Πάντως ακόμη και λίγο πουσαρισμενοι να είναι οι αριθμοί και να μην είναι στο frontier του σημερα, είναι στο, frontier προ τριμήνου. Το ότι υπάρχει κάτι τέτοιο ελεύθερα διαθέσιμο πρέπει να δημιουργεί στρες σε όλα τα lab.
Όλα αυτά είναι εφικτά γιατί έχεις πάντα κάποιους τρελούς που πιέζουν αρχιτεκτονικές στα όρια. Στη δική μου πλατφόρμα AMD395+ ("AMD Strix") έχουν συγκλίνει σε ένα μοντέλο και η προσπάθεια έχει αποτέλεσμα. Σκέψου ότι τις τελευταίες ημέρες έχει σχεδόν ημερήσια update το inference engine (εικάζω ότι λιώνουν τα reset του codex) της ομάδας που βελτιστοποιεί για τα windows. Άσε που κάνουν και σοβαρά quantizations συνδυάζοντας διάφορες τεχνικές (χωρίς να μπλέκουν με abliteration κλπ).
Σχεδόν κανένα από τα μεγάλα μοντέλα δεν είναι πια dense έτσι και αλλιώς, όλα είναι MoE.
Αντίστοιχα το καλοκαίρι που το έψαχνα είχα δει αρκετούς που στην πλατφόρμα μου είχαν λιώσει το OSS-120B γιατί έφταναν τα 50 tk/s και για coding production με καλό harness πήγαινε μια χαρά - είναι και μόλις ~64 GB σε μνήμη.
Επίσης σε όλες τις πλατφόρμες που έχω δει δοκιμές το concurency μέχρι τους 4 χρήστες/ταυτόχρονα requests είναι θετικό πολύ πάντα. Το μόνο που είναι απίστευτα μπροστά και συνεχίζει να αυξάνει τα νούμερά του σε 8+ requests είναι το DGX Spark. Αλλά δεν νομίζω ότι εταιρία με πολύ κόσμο θα επενδύσει για τα επόμενα 1-2 χρόνια σε κάτι τέτοιο αν δεν έχει κάποιο confidentiality θέμα. To Luna σε max thinking για πολλά από τα coding tasks είναι υπέραρκετό και σχεδόν τσάμπα.
Καταλήγοντας το έχουμε ξαναπεί το local/offline θέλει καλό σχεδιασμό για να δεις αν έχει νόημα η επένδυση. Στην πλειονότητα των χρηστών δεν έχει.