

Εγώ ήμουν μέτριος στα μαθηματικά. Όλο 5 ή 6 επαιρνα. Είχα δύο δεκαριά, στην "αριθμητική ανάλυση" και στις "εξισώσεις Bessel και ανάλυση Fourier". Έλυνα δισδιάστατη μεταφορά θερμότητας με το χέρι... Και έτσι χτύπησα το τρίτο δέκαρι στη "μηχανική ρευστών". Τώρα δεν θυμάμαι τίποτα, έχω να τα χρησιμοποιήσω δεκαετίες. Το πιο πολύπλοκο πράγμα που χρησιμοποιώ είναι το Excel. Θυμάμαι όμως με νοσταλγία που προσπαθούσα να βρω άκρη σε 4k γραμμές Fortran γραμμένες από άλλον...
Τεχνητή Νοημοσύνη (AI). Τι είναι, τι ξέρουμε, τι αλλάζει στη ζωή και στον πολιτισμό;
- Thread starter Sonus Naturalis
- Start date
You are using an out of date browser. It may not display this or other websites correctly.
You should upgrade or use an alternative browser.
You should upgrade or use an alternative browser.


Για να καταλάβουμε πως πάνε εμπορικά τα μοντέλα μιας εταιρίας, μπορεί κανείς να δει το AI Index Token Shareper model της Ramp.
Δείτε κάποια ενδεικτικά checkpoints.
Πέρυσι τέτοια περίοδο το GPT-4o Mini ήταν το μοντέλο που οι περισσότερες επιχειρήσεις ενσωμάτωναν στις εφαρμογές τους λόγω κόστους. Η ανάπτυξη πήγαινε στο Sonnet 4.5 -το οποίο στη δική μου χρήση ήταν το πρώτο μοντέλο που όντως εκτελούσε από την αρχή μέχρι το τέλος με σχετική επιτυχία. Μέχρι τότε τα αποτελέσματα ήταν μέτρια στη καλύτερη.
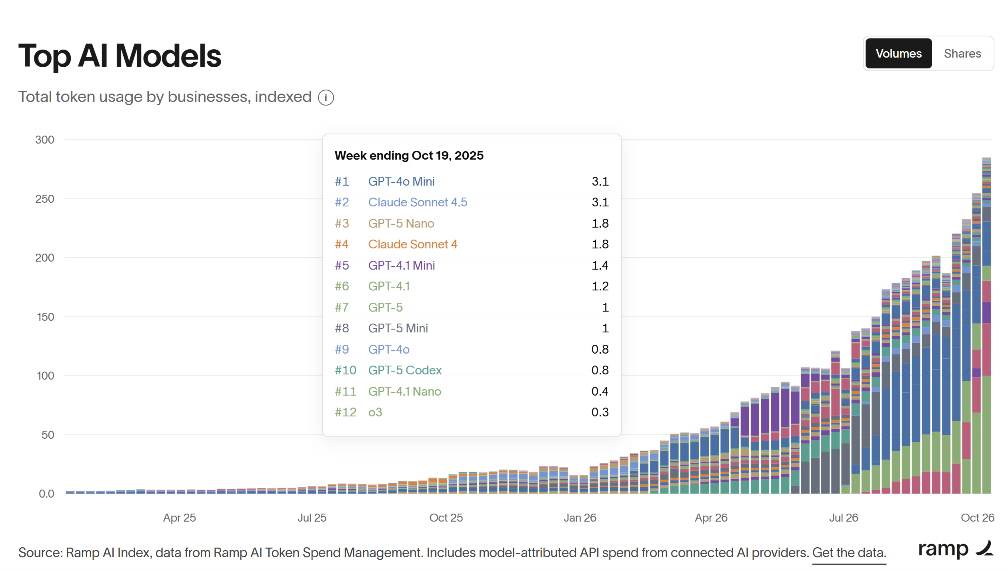
Τον Ιούλιο που βγήκε το 5.6 Sol, για πρώτη φορά άρχισε να γίνεται αρκετά μεγάλη χρήση και από επιχειρήσεις. Όντως ήταν πολύ καλό μοντέλο και αρκετά φθηνότερο από το Opus 4.8. Το Fable παρότι εντυπωσιακά καλύτερο από ότι κυκλοφορούσε, δεν εντάσσεται στα περισσότερα workflows εταιριών εφόσον δεν διατίθεται με zero-data-retention για τους περισσότερους πελάτες τους.
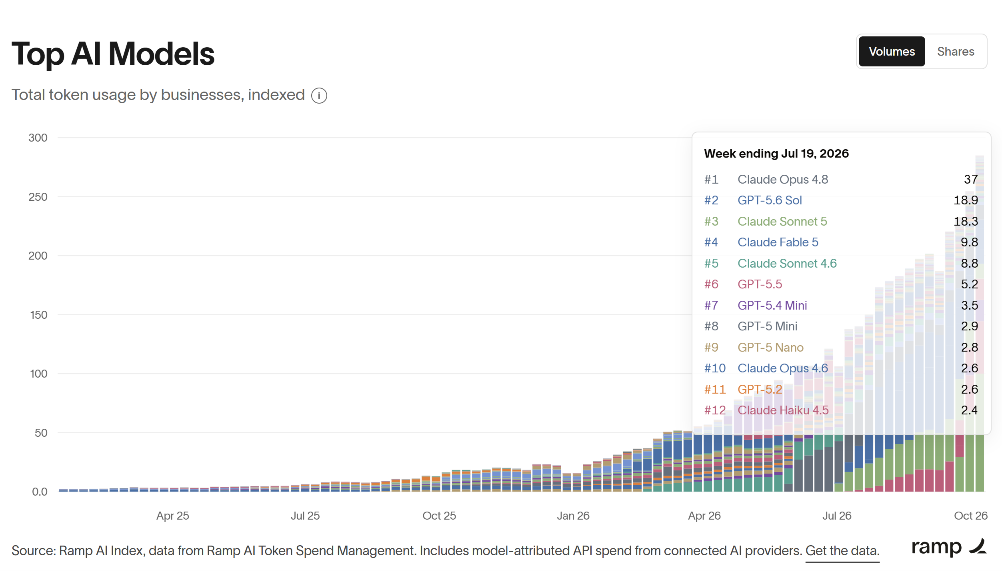
Και στο σήμερα:
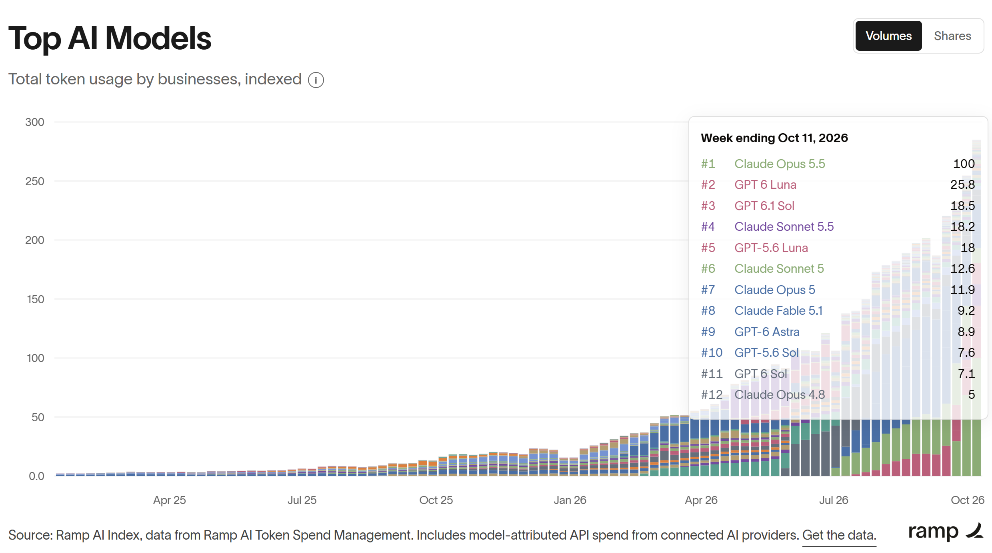
Δείτε κάποια ενδεικτικά checkpoints.
Πέρυσι τέτοια περίοδο το GPT-4o Mini ήταν το μοντέλο που οι περισσότερες επιχειρήσεις ενσωμάτωναν στις εφαρμογές τους λόγω κόστους. Η ανάπτυξη πήγαινε στο Sonnet 4.5 -το οποίο στη δική μου χρήση ήταν το πρώτο μοντέλο που όντως εκτελούσε από την αρχή μέχρι το τέλος με σχετική επιτυχία. Μέχρι τότε τα αποτελέσματα ήταν μέτρια στη καλύτερη.
Τον Ιούλιο που βγήκε το 5.6 Sol, για πρώτη φορά άρχισε να γίνεται αρκετά μεγάλη χρήση και από επιχειρήσεις. Όντως ήταν πολύ καλό μοντέλο και αρκετά φθηνότερο από το Opus 4.8. Το Fable παρότι εντυπωσιακά καλύτερο από ότι κυκλοφορούσε, δεν εντάσσεται στα περισσότερα workflows εταιριών εφόσον δεν διατίθεται με zero-data-retention για τους περισσότερους πελάτες τους.
Και στο σήμερα:

Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,044
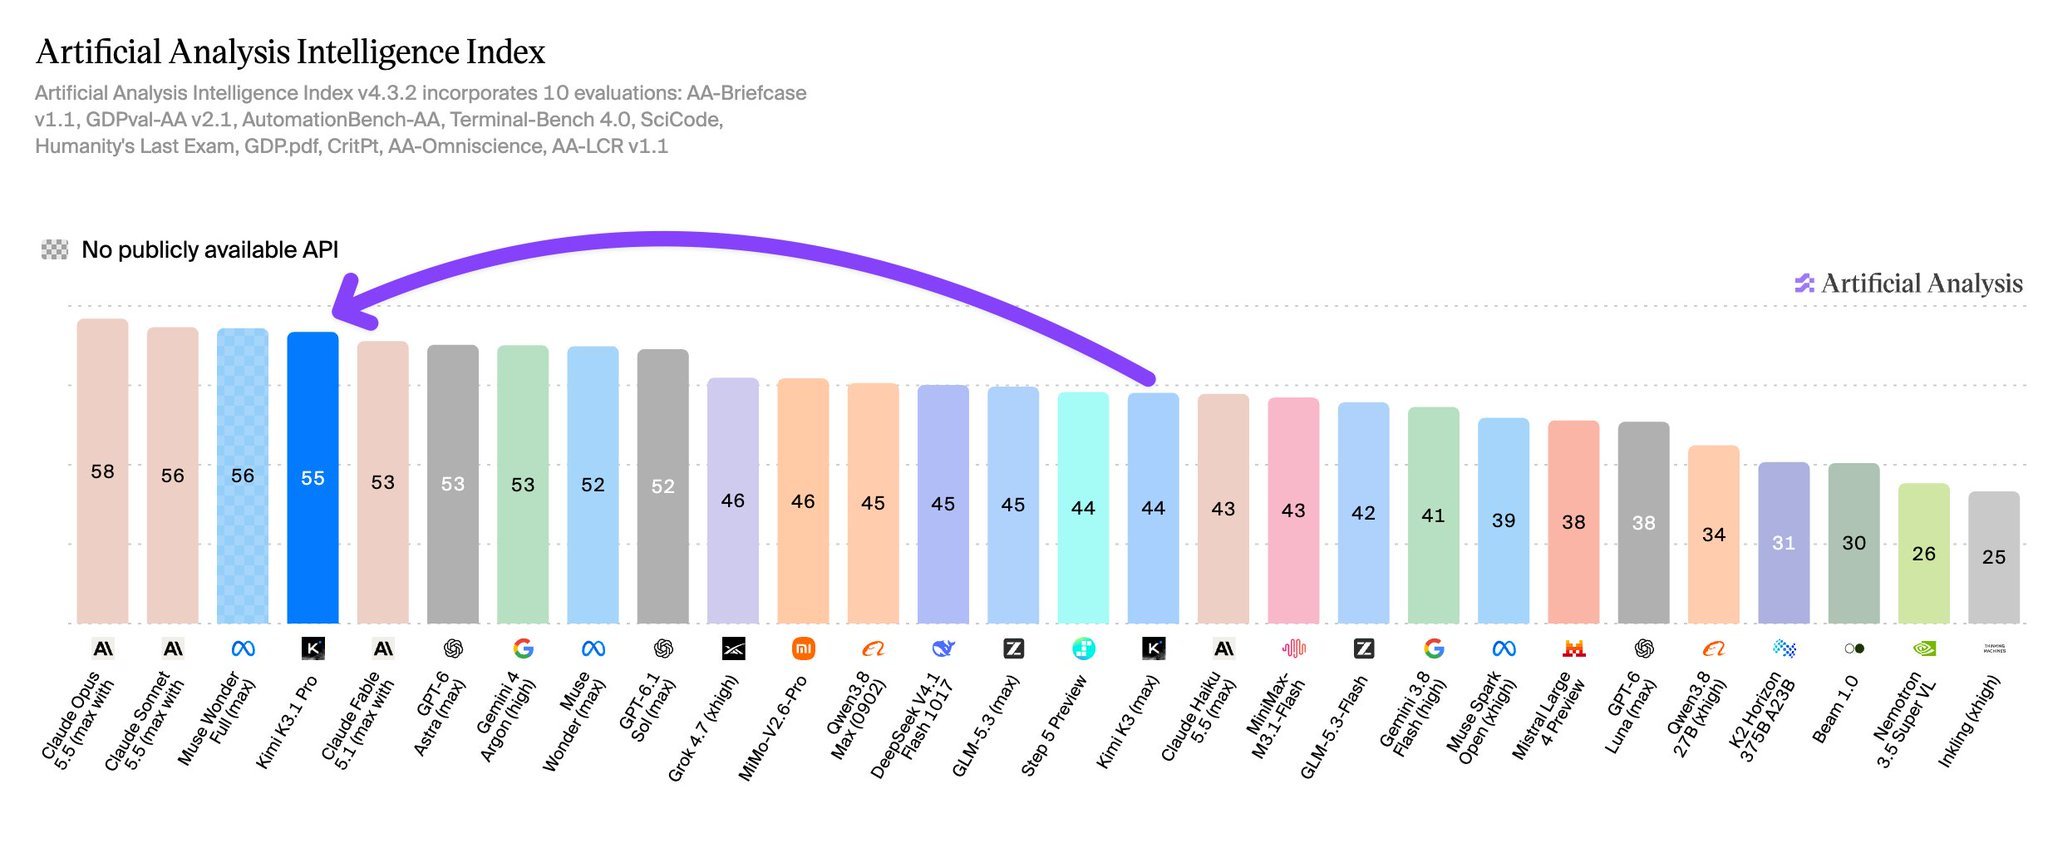
Από την μία είμαι πολύ χαρούμενος για τον παγκόσμιο ανταγωνισμό. Από την άλλη φοβάμαι τι μπορούν να κάνουν με ένα τέτοιο μοντέλο.Το αφήνω αυτό απλά εδώ.
Σοκ και δέος. Ανοιχτό μοντέλο, που θα μπορεί να τρέξει ο οποιοσδήποτε (με πρόσβαση σε data enter) , καλύτερο από τα GPT Sol, Astra, Gemini 4 και τον Grok.
View attachment 279710
Λένε ότι είναι nerfed κατά τουλάχιστον 10% σε cyber security δυνατότητες. Αλλά και πάλι μπορεί να επαναφέρουν δυνατότητες.
Το τρέχεις σπίτι με 15000 ευρώ πάντως...Είναι τρελό...
Όσο και αν το έχουν βελτιστοποιήσει για τα τεστ, είναι σε κάθε περίπτωση πάνω από τα Fable 5.1 και Astra ή έστω στο ίδιο επίπεδο.
Το άλλο που δεν συζητάμε είναι πόση νοημοσύνη μπορούμε σιγά σιγά να φέρουμε στα σπίτια μας. Με 3.5-4k τρέχεις το Qwen3.8-Flash-Next που είναι τυπικά στο παραπάνω benchmark αντίστοιχο του chatgpt 5.5 xHigh.
Περιμένω πάντως και τα δύο που έχουν ανακοινωθεί από την Alibaba τα Qwen4 Flash και 27B για τοπικά.
Τέλος πραγματικά για τις αγγαρείες ήδη τα μικρά μοντέλα είναι αρκετά έξυπνα, τα μεγάλα τα θέλεις για συγκεκριμένα task μόνο.
Το τρέχεις σπίτι με 15000 ευρώ πάντως...Είναι τρελό...
Τι θα τρέξεις σπίτι με 15 χιλιάδες;
Είναι 2.8Τρις παράμετροι, σε FP8 με το context του, τη kv cache κλπ θέλει 3TB (!!!) VRAM.
Ένα NVL72 GB200 της nvidia τουλάχιστον. Ενα τυπικό 8x DGX δεν το τρέχει.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,044
Έχεις απόλυτο δίκαιο...ρώτησα στα γρήγορα το Gemini και έβγαλε αυτή την πατάτα ότι με quantization Q4 θα μπορείς από τα 400 GB ram να το τρέξεις - ζήτω τα hallucinations.Τι θα τρέξεις σπίτι με 15 χιλιάδες;
Είναι 2.8Τρις παράμετροι, σε FP8 με το context του, τη kv cache κλπ θέλει 3TB (!!!) VRAM.
Ένα NVL72 GB200 της nvidia τουλάχιστον. Ενα τυπικό 8x DGX δεν το τρέχει.
1.5–1.7 TB σε Q4, οπότε χρειάζεσαι να πουλήσεις γκαρσονιέρα για 80k μήπως καταφέρεις να συνδέσεις 4x Mac Studio M5 Ultra 512 GB για να το τρέξεις στο σπίτι και αν.
Το θέμα με τα πάρα πολύ μεγάλα μοντέλα είναι πως πέραν από το να φορτώσουν στη μνήμη της οποίας υποδομής πρέπει να μπορούν να κάνουν και decode ικανοποιητικά.
Να δώσεις 80k και να τρέχει με 10tok/s χωρίς concurrency, για ένα χρήστη, είναι απλα κακή εμπειρία.
Όσον αφορά το capability, σε πολλά tasks είναι αρκετά χειρότερο από το Astra που υποτίθεται ματσάρει εκ πρώτης όψεως. Πάντως ακόμη και λίγο πουσαρισμενοι να είναι οι αριθμοί και να μην είναι στο frontier του σημερα, είναι στο, frontier προ τριμήνου. Το ότι υπάρχει κάτι τέτοιο ελεύθερα διαθέσιμο πρέπει να δημιουργεί στρες σε όλα τα lab.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,044
Θα σου μιλήσω από προσωπική εμπειρία. Όλα είναι θέμα βελτιστοποίησης. Τελικά στο σπίτι τρέχω μοντέλο που είναι ~96 GB και έχω μέσο decode γύρω στα 30 tk/s που είναι απόλυτα λειτουργικό. Σε κάποια task πέφτει στα 20-22 tk/s και σε άλλα πάει 40+ tk/s. Και όμως είναι το ταχύτερο και πιο αξιόπιστο στις απαντήσεις συνολικά από αρκετά μικρότερα MoE μοντέλα που έχουν σημαντικά χαμηλότερο memory footprint. Τα windows κάνουν θαύματα και με τα 32 GB συν το swap τρέχω όλο το καθημερινό workload των windows απροβλημάτιστα. Το harness θέλει περίπου 3-4 GB στη ram και μετά όλα τα άλλα των windows. Συνήθως παίζω από 130-170 GB / 200 GB commited memory. Και να θυμίσω ότι η πλατφόρμα που έχω είναι σημαντικά πιο αργή σε επεξεργαστική ισχύ από κάρτες γραφικών με rtx chip της nvidia και η δύναμή της είναι στην μεγάλη διαθεσιμότητα μνήμης σε απλό form factor.Το θέμα με τα πάρα πολύ μεγάλα μοντέλα είναι πως πέραν από το να φορτώσουν στη μνήμη της οποίας υποδομής πρέπει να μπορούν να κάνουν και decode ικανοποιητικά.
Να δώσεις 80k και να τρέχει με 10tok/s χωρίς concurrency, για ένα χρήστη, είναι απλα κακή εμπειρία.
Όσον αφορά το capability, σε πολλά tasks είναι αρκετά χειρότερο από το Astra που υποτίθεται ματσάρει εκ πρώτης όψεως. Πάντως ακόμη και λίγο πουσαρισμενοι να είναι οι αριθμοί και να μην είναι στο frontier του σημερα, είναι στο, frontier προ τριμήνου. Το ότι υπάρχει κάτι τέτοιο ελεύθερα διαθέσιμο πρέπει να δημιουργεί στρες σε όλα τα lab.
Όλα αυτά είναι εφικτά γιατί έχεις πάντα κάποιους τρελούς που πιέζουν αρχιτεκτονικές στα όρια. Στη δική μου πλατφόρμα AMD395+ ("AMD Strix") έχουν συγκλίνει σε ένα μοντέλο και η προσπάθεια έχει αποτέλεσμα. Σκέψου ότι τις τελευταίες ημέρες έχει σχεδόν ημερήσια update το inference engine (εικάζω ότι λιώνουν τα reset του codex) της ομάδας που βελτιστοποιεί για τα windows. Άσε που κάνουν και σοβαρά quantizations συνδυάζοντας διάφορες τεχνικές (χωρίς να μπλέκουν με abliteration κλπ).
Σχεδόν κανένα από τα μεγάλα μοντέλα δεν είναι πια dense έτσι και αλλιώς, όλα είναι MoE.
Αντίστοιχα το καλοκαίρι που το έψαχνα είχα δει αρκετούς που στην πλατφόρμα μου είχαν λιώσει το OSS-120B γιατί έφταναν τα 50 tk/s και για coding production με καλό harness πήγαινε μια χαρά - είναι και μόλις ~64 GB σε μνήμη.
Επίσης σε όλες τις πλατφόρμες που έχω δει δοκιμές το concurency μέχρι τους 4 χρήστες/ταυτόχρονα requests είναι θετικό πολύ πάντα. Το μόνο που είναι απίστευτα μπροστά και συνεχίζει να αυξάνει τα νούμερά του σε 8+ requests είναι το DGX Spark. Αλλά δεν νομίζω ότι εταιρία με πολύ κόσμο θα επενδύσει για τα επόμενα 1-2 χρόνια σε κάτι τέτοιο αν δεν έχει κάποιο confidentiality θέμα. To Luna σε max thinking για πολλά από τα coding tasks είναι υπέραρκετό και σχεδόν τσάμπα.
Καταλήγοντας το έχουμε ξαναπεί το local/offline θέλει καλό σχεδιασμό για να δεις αν έχει νόημα η επένδυση. Στην πλειονότητα των χρηστών δεν έχει.
Δεν έχει βέβαια ακριβώς σχέση το μοντέλο των 27B παραμέτρων με εκείνο των 2.8T.
Έκατσα λίγο και έκανα τα μαθηματικά. Το Kimi 3.1 Pro είναι native MXFP4 οπότε έχουμε τα παρακάτω:
1.56TB VRAM για τα model weights, 27KB/token για τη KV Cache, 1εκ tokens το context.
Δεν υπάρχει consumer hardware που μπορεί να τρέξει τέτοιο πράγμα ικανοποιητικά.
Εάν αγοράσεις 4 Mac Studio 512GB για παράδειγμα που θεωρητικά το χωράνε, θα τρέχει με 10tok/sec και το prefil σε πιο βαριά requests θα κάνει λεπτά μέχρι το πρώτο token. Ένα request 200k input tokens θέλει 14 λεπτά στο prefill.
Ρεαλιστικά, για τρέξει τέτοια κλάση μοντέλων χρειάζεται εξοπλισμό datacenter. Το ελάχιστο αποδεκτό για να έχεις 50tok/sec/χρήστη είναι ένα HGX B300. Το οποίο βέβαια, ανεξαρτήτως μνήμης, έχει αρκετό compute για να τρέξει παράλληλα requests από περίπου ~100 χρήστες.
Για να έχει αυτό το πράγμα το οποιοδήποτε νόημα, πρέπει να είσαι σε 100% utilization και σε αυτή τη περίπτωση ζήτημα είναι να "κερδίσεις" ένα 15% σε σχέση με ένα managed ZDR endpoint.

songless_bird
AVClub Fanatic
Έχει κάποιος εμπειρία από pay per use συνδρομές;
Χρησιμοποίησα με το opencode το glm 5.3 flash free και ειμαι εντυπωσιασμενος για coding και agent και σκέφτομαι να φορτώσω για αρχή 20€ για κανονική πρόσβαση στο zen του opencode.
Ένας φίλος μου είπε ότι μπορώ να βρω για χρήση του glm 5.3 flash φτηνότερα από openrouter.
Αλλά δεν μπορώ να συγκρίνω ταχύτητες και φοβάμαι ότι μπορεί να είναι πιο αργό από του opencode .
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,044
Δυστυχώς ο δρόμος εδώ είναι κυρίως δοκιμάζω και βλέπω πως πάει...Έχει κάποιος εμπειρία από pay per use συνδρομές;
Χρησιμοποίησα με το opencode το glm 5.3 flash free και ειμαι εντυπωσιασμενος για coding και agent και σκέφτομαι να φορτώσω για αρχή 20€ για κανονική πρόσβαση στο zen του opencode.
Ένας φίλος μου είπε ότι μπορώ να βρω για χρήση του glm 5.3 flash φτηνότερα από openrouter.
Αλλά δεν μπορώ να συγκρίνω ταχύτητες και φοβάμαι ότι μπορεί να είναι πιο αργό από του opencode .
songless_bird
AVClub Fanatic
Είδα ότι πλέον αυτό που κάνω δεν χρειάζεται μόνιμη συνδρομή που μπορεί σε 1 μήνα να μην κάνω την ίδια που έκανα σε έναν άλλο, οπότε το pay per use μου φαίνεται πιο λογικο για την περιστασιακή χρήση και προσφέρει στα ίδια χρήματα περισσότερα. Συγκρίνοντας την σταθερή συνδρομή Go και την pay per use Zen του opencode .Δυστυχώς ο δρόμος εδώ είναι κυρίως δοκιμάζω και βλέπω πως πάει...
Απλά με παραξενεύει η διαφορά στην τιμή.
GLM 5.3 Flash
Openrouter
Input: ~$0.047
Output: ~$0.12
Opencode
Input: ~$0.07 - $0.12
Output: ~$0.25 - $0.42
GLM 5.3
Openrouter
Input: ~$0.079
Output: ~$1.40
Opencode
Input: ~$1.40
Output: ~$4.40
Ανά 1M tokens
Στο openrouter δεν διαλέγεις τον φθηνότερο provider.
Βλέπεις ανά μοντέλο ποιός σε εξυπηρετεί καλύτερα, στο επίπεδο τιμής που σε ενδιαφέρει, τη ταχύτητα και την αξιοπιστία που επιθυμείς.
Για παράδειγμα:
Βλέπεις ανά μοντέλο ποιός σε εξυπηρετεί καλύτερα, στο επίπεδο τιμής που σε ενδιαφέρει, τη ταχύτητα και την αξιοπιστία που επιθυμείς.
Για παράδειγμα:
songless_bird
AVClub Fanatic
Μπέρδεμα καθώς βλέπω αυτά είναι σαν χρηματιστήριοΣτο openrouter δεν διαλέγεις τον φθηνότερο provider.
Βλέπεις ανά μοντέλο ποιός σε εξυπηρετεί καλύτερα, στο επίπεδο τιμής που σε ενδιαφέρει, τη ταχύτητα και την αξιοπιστία που επιθυμείς.
Για παράδειγμα:

Φαντάζομαι μπορώ να βάλω μια ρύθμιση που να με ενδιαφέρει πχ cheapest και να επιλέγει αυτόματα τον φθηνότερο ( άσχετα την ταχύτητα) ή να με ενδιαφέρει η ταχύτητα άσχετα αν βγαίνει πιο ακριβά.
Πάντως βλέπω ότι συμφέρει πιο πολύ από opencode .
Μπορείς να επιλέξεις, φυσικά.
Σε ενδιαφέρει η ταχύτητα να είναι >50tok/sec.
Οτιδήποτε χαμηλότερο, όντας επί πληρωμή μικρό μοντέλο είναι αδιάφορο.
Για να έχεις ένα benchmark, το Opus 5.5 είναι στα 80-100tok/sec και είναι συγκριτικά εξαιρετικά μεγαλύτερο μοντέλο.
Σε ενδιαφέρει η ταχύτητα να είναι >50tok/sec.
Οτιδήποτε χαμηλότερο, όντας επί πληρωμή μικρό μοντέλο είναι αδιάφορο.
Για να έχεις ένα benchmark, το Opus 5.5 είναι στα 80-100tok/sec και είναι συγκριτικά εξαιρετικά μεγαλύτερο μοντέλο.
Μου έδωσαν πρόσβαση και στον always-on agent της anthropic, το Claude Duet.
Θα το δοκιμάσω και θα επανέλθω. Εκ πρώτης όψεως, διαβάζει στην αρχή όλο σου το history και έχει πρόσβαση σε όλες τις λειτουργείες του claude.
Δείχνει ενδιαφέρον. Ένα σημείο διαφοροποίησης είναι πως χρησιμοποιεί το quota της συνδρομής. Βέβαια στις Max συνδρομές είναι πρακτικά απεριόριστο, οπότε μικρό το κακό.
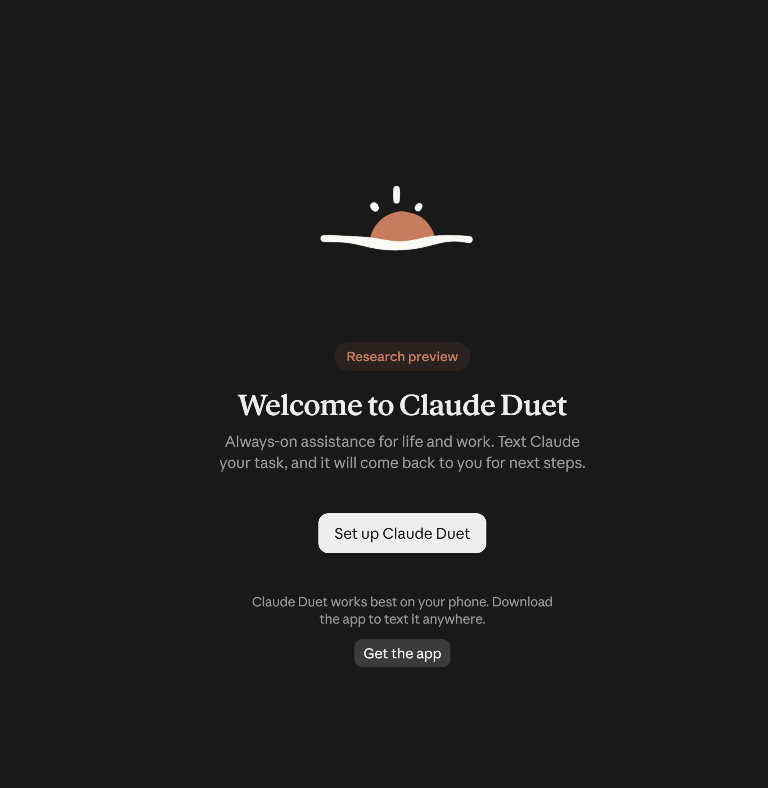
Θα το δοκιμάσω και θα επανέλθω. Εκ πρώτης όψεως, διαβάζει στην αρχή όλο σου το history και έχει πρόσβαση σε όλες τις λειτουργείες του claude.
Δείχνει ενδιαφέρον. Ένα σημείο διαφοροποίησης είναι πως χρησιμοποιεί το quota της συνδρομής. Βέβαια στις Max συνδρομές είναι πρακτικά απεριόριστο, οπότε μικρό το κακό.

Έχει κάποιος εμπειρία από pay per use συνδρομές;
Θα πληρώσεις πολλά περισσότερα χωρίς λόγο.
Έχω δημιουργήσει ένα test για να βλέπω πόσο κοστίζει το κάθε μοντέλο. Ένα πολύ απλό, με αρχεία σε directory που κάνει pull από το git και λύνει τα conflicts.
Ένα Sonnet παίρνει περίπου 2% από το πεντάωρο όριο, ενώ ένα Opus 5%
Σε usage credits το Opus παίρνει περίπου 0.50€!
Ίσως να σε συμφέρει μόνο αν χρησιμοποιείς λιγότερο από το 20% του εβδομαδιαίου ορίου κάθε φορά.
Το μόνο σίγουρο είναι ότι η χρήση των API είναι ΠΟΛΥ πιο ακριβή από μία συνδρομή.
Γιώργος Κυριακαράκος
Administration Team
- 17 June 2006
- 12,044
Περιμένουμε review!!!Μου έδωσαν πρόσβαση και στον always-on agent της anthropic, το Claude Duet.
Θα το δοκιμάσω και θα επανέλθω. Εκ πρώτης όψεως, διαβάζει στην αρχή όλο σου το history και έχει πρόσβαση σε όλες τις λειτουργείες του claude.
Δείχνει ενδιαφέρον. Ένα σημείο διαφοροποίησης είναι πως χρησιμοποιεί το quota της συνδρομής. Βέβαια στις Max συνδρομές είναι πρακτικά απεριόριστο, οπότε μικρό το κακό.
View attachment 279810
songless_bird
AVClub Fanatic
Σε ενα σεναριο χρησης πιανοντας τα ορια της συνδρομης opencode GO των 10$ για το glm 5.3 flash στο pay per use θα ειχα πληρωσει 30$...Θα πληρώσεις πολλά περισσότερα χωρίς λόγο.
Έχω δημιουργήσει ένα test για να βλέπω πόσο κοστίζει το κάθε μοντέλο. Ένα πολύ απλό, με αρχεία σε directory που κάνει pull από το git και λύνει τα conflicts.
Ένα Sonnet παίρνει περίπου 2% από το πεντάωρο όριο, ενώ ένα Opus 5%
Σε usage credits το Opus παίρνει περίπου 0.50€!
Ίσως να σε συμφέρει μόνο αν χρησιμοποιείς λιγότερο από το 20% του εβδομαδιαίου ορίου κάθε φορά.
Το μόνο σίγουρο είναι ότι η χρήση των API είναι ΠΟΛΥ πιο ακριβή από μία συνδρομή.
 Θελει να το κοιταξω λιγο ακομη γιατι εχω πληρωσει chatgpt plus και ενα μηνα δεν εκανα τιποτα που να δικαιολογει τα 23€.